
P2P 与分布式存储 / 系统课时
心跳超时为什么不能直接证明宕机
心跳超时为什么不能直接证明宕机
在分布式存储集群中,连续三秒没有收到节点心跳,并不意味着该节点已经宕机。进程可能仍在运行,只是消息没有及时到达。本课通过四种故障场景和一次误切换案例,说明故障检测为什么存在不确定性,以及如何避免误判引发双主写入和无谓的副本重建。
学习目标
- 区分进程崩溃、网络抖动、节点过载和单向通信故障造成的心跳缺失。
- 根据心跳间隔与超时阈值,分析故障检测的误判和延迟。
- 解释副本切换为什么需要多数派仲裁、任期保护和写入栅栏。
心跳超时究竟说明什么
假设存储节点 P 每隔 1 秒向监测者 M 发送一次心跳,M 在连续 3 秒没有收到新心跳后,将 P 标记为疑似故障。
M 此时能够确认的事实只有:在最近 3 秒内,没有成功接收到 P 的心跳。它无法仅凭这一结果区分 P 是否已经退出、消息是否丢失,或者 P 是否暂时忙到无法调度心跳任务。
这是分布式系统中的故障检测不确定性:远程进程停止运行,与远程进程仍在运行但消息无限延迟,在有限观察时间内可能产生完全相同的现象。网络连接断开也只能证明当前通信路径不可用,不能单独证明远端进程死亡。
因此,心跳超时应该产生一个怀疑状态(Suspect),而不是直接产生一个已经确认宕机的结论。
四种故障为什么表现得一样
同样是连续 3 秒没有收到心跳,背后的原因可能完全不同。
| 故障类型 | 实际发生的事情 | 可用于辅助判断的证据 |
|---|---|---|
| 进程崩溃 | 存储进程退出,不再生成心跳 | 进程退出记录、宿主机上的进程状态 |
| 网络抖动 | 心跳在链路中丢失或延迟 | 丢包率、往返时延、其他路径的探测结果 |
| 节点过载 | CPU 饱和、长时间 GC 暂停或 I/O 拥塞阻碍心跳处理 | CPU 使用率、GC 暂停、运行队列、磁盘延迟 |
| 单向通信故障 | P 到 M 的方向不可达,反向通信可能正常 | 双向探测、其他观察者的心跳记录 |
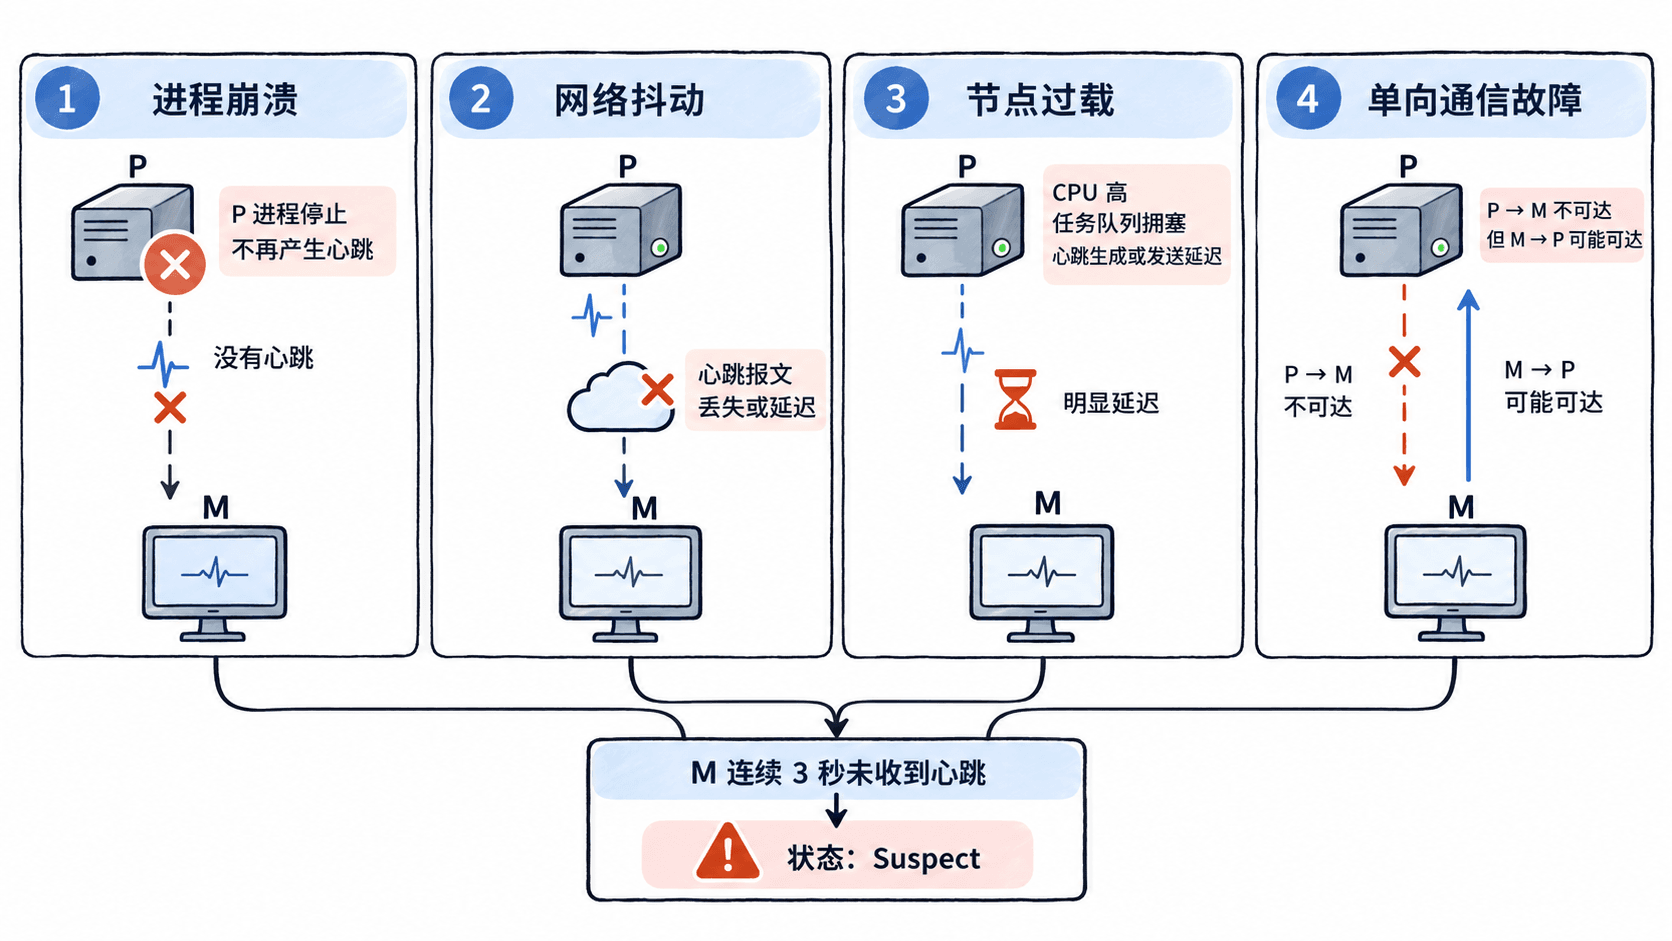
其中,单向通信故障尤其容易误导排查人员。假设 P 到 M 的网络方向发生故障,而其他存储节点仍然能够访问 P,那么 M 看到的心跳缺失并不代表整个集群都失去了对 P 的访问能力。
超时阈值如何改变误判与检测速度
考虑一个具体配置:心跳发送间隔为 1 秒,故障怀疑阈值为 3 秒,监测者根据最近一次成功接收心跳的时间计算超时。
假设 M 在第 0 秒收到 P 的心跳,之后第 1、2、3 秒发出的心跳均没有及时到达。M 在第 3 秒触发超时,而第 3 秒发出的心跳实际在第 3.4 秒到达。
| 时间 | 监测者观察 | 节点真实状态 |
|---|---|---|
| 0 秒 | 收到心跳 | 正常运行 |
| 1 秒 | 未收到新心跳 | 正常运行 |
| 2 秒 | 仍未收到 | 正常运行 |
| 3 秒 | 达到超时阈值,标记 Suspect | 正常运行 |
| 3.4 秒 | 收到迟到的心跳 | 正常运行 |
在这个算例中,监测者至少出现了约 0.4 秒的错误怀疑窗口。如果刚达到 3 秒就永久判定宕机并立即迁移副本,就会把一次短暂通信异常转化为实际的集群操作。
如果把阈值从 3 秒提高到 8 秒,可以容忍更长的心跳间隔异常,但对于真正已经崩溃的节点,检测时间也可能增加约 5 秒。更短的阈值通常提高检测速度,也增加对抖动和暂停的敏感性。
生产系统可以记录连续心跳的实际到达间隔,利用延迟分布与历史样本设置阈值,或者使用 Phi Accrual Failure Detector 等机制计算故障怀疑程度。但即使使用自适应算法,也无法从有限的超时观测中获得绝对确定的宕机证明。
一次误判怎样引发双主与无谓恢复
假设对象 x 原本由主副本 P 负责写入,从副本 R 保存复制数据。监测者 M 因为网络故障收不到 P 的心跳,但客户端 C1 仍然能够访问 P。
如果系统错误地规定只要 M 超时,就立即让 R 成为新主,并且没有多数派选举和旧主写入栅栏,就可能出现以下过程:
- 第 0 秒,P 正常服务,M 最后一次收到 P 的心跳。
- 第 3 秒,M 判断 P 超时,错误地宣布 P 已经死亡。
- 第 4 秒,M 将 R 提升为新主,但 P 没有停止对外提供写入服务。
- 客户端 C1 向 P 写入 x=7,客户端 C2 向 R 写入 x=8。如果双方各自独立确认成功,就产生互相冲突的写入历史。
- 网络恢复后,两个节点都可能认为自己保留了合法的新版本,系统无法仅根据心跳结果决定应该保留哪一个值。
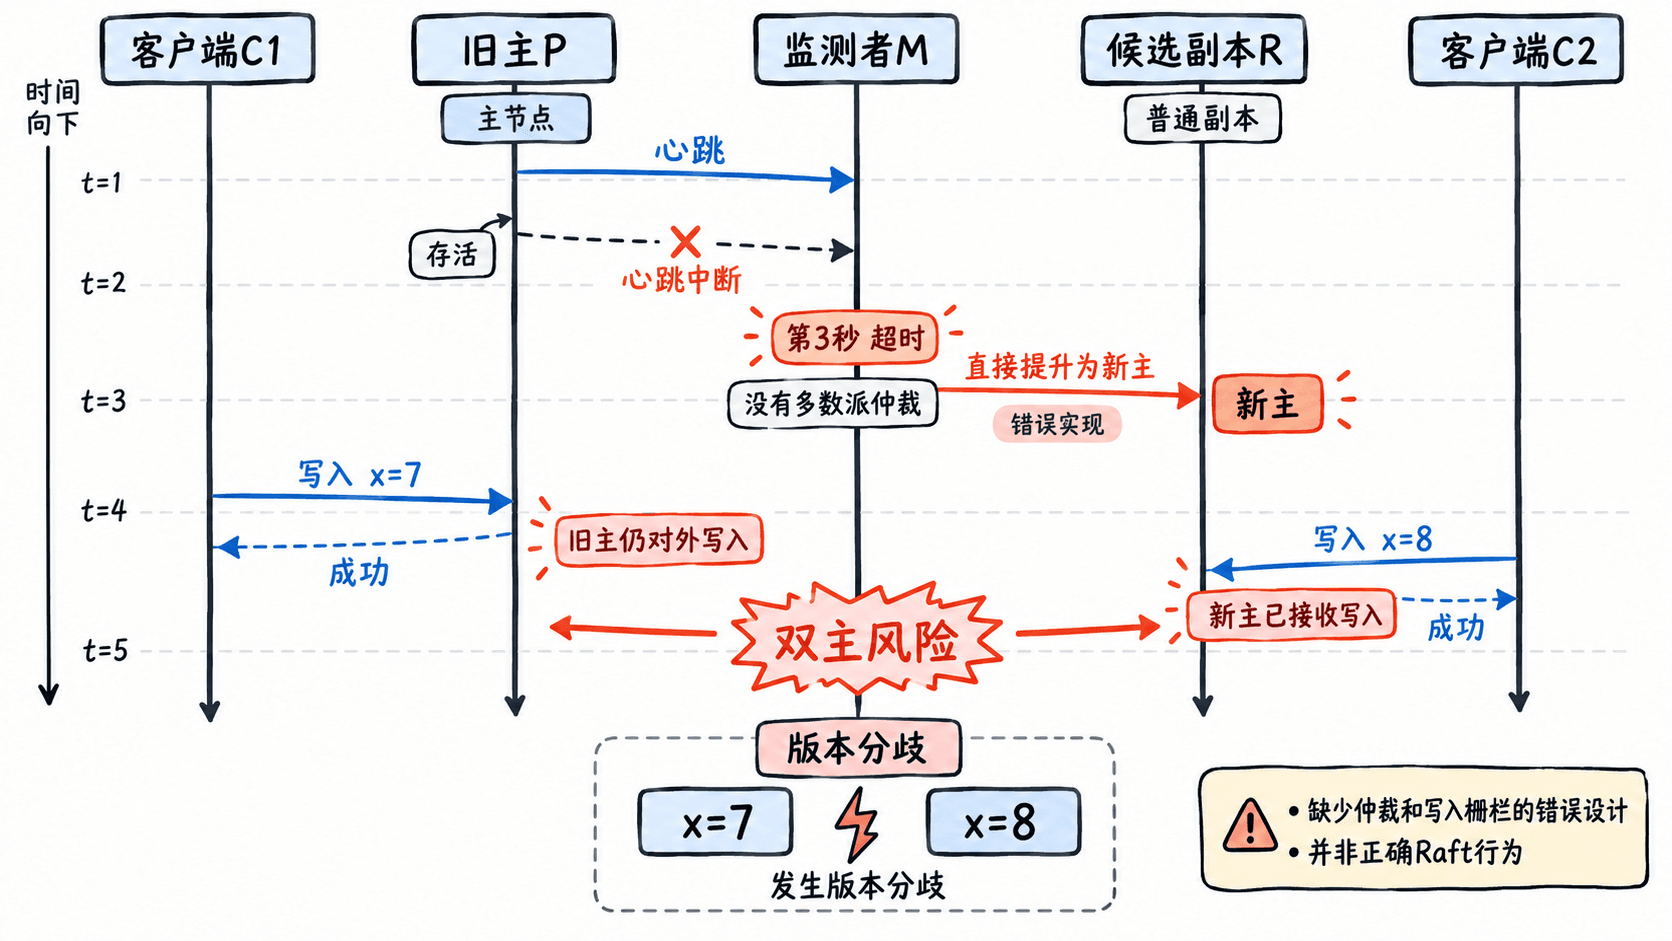
这并不是正确实现多数派共识协议时应该发生的结果。以 Raft 为例,选举超时只会触发新的竞选;候选者必须获得多数派投票才能当选领导者,写入提交也受多数派复制规则约束。
误判还会造成另一种损失:系统可能把仍然健康的节点当作丢失副本,立即启动跨节点数据复制。假设一个节点保存 2 TiB 数据,错误触发的副本重建可能产生大量磁盘读取、网络流量和目标节点写入,进一步加重原本的负载问题。
从疑似故障到安全恢复的判断顺序
实际工程中,可以把故障检测与写入权限切换分开处理,并采用以下顺序。
- 先标记怀疑状态。 例如心跳间隔 1 秒、超时阈值 3 秒时,将节点标记为 Suspect,记录最后成功接收时间与连续丢失次数,不把超时直接等同于宕机。
- 进行多角度复核。 检查其他副本是否仍能访问该节点,并结合心跳延迟、网络丢包、进程状态和宿主机负载,区分节点进程故障与观察路径故障。
- 通过多数派协议切换主节点。 三个投票节点组成的共识组,需要获得至少 2 票才能完成合法选举;单个监测者的超时事件不能独立授予写入权限。
- 用任期或栅栏令牌保护新写入。 假设旧主使用任期 41,新主取得任期 42。写入接收方必须执行权限与任期校验,使过期任期 41 的请求无法作为新的有效写入提交,不能仅依靠更新客户端路由阻止旧主。
- 确认副本确实缺失后再修复。 对需要重建的数据设置并发与带宽限制;节点恢复时先核对版本和复制进度,取消不再必要的重建任务,避免重复搬运数据。
故障检测器负责报告节点可能不可达,共识协议负责决定谁有资格继续承担写入职责,副本恢复机制负责补足真正缺失的数据。将这三个决策分开,才能在心跳误报、网络分区和节点过载时避免把一次短暂故障扩大为数据一致性事故。