
P2P 与分布式存储 / 系统课时
文件、块和对象接口如何影响设计
文件、块和对象接口如何影响设计
同样是保存 100 MB 数据,文件存储看到的是路径和目录,块存储看到的是一串逻辑块地址,对象存储看到的则是对象键和完整对象。接口不同,会直接改变元数据放在哪里、应用怎样更新数据,以及系统扩容时需要移动什么。
学习目标
- 区分文件路径、逻辑块地址和对象键三种寻址方式。
- 判断三类接口对元数据、更新粒度和分布式扩容的影响。
- 根据数据库、共享目录和海量静态文件等场景选择合适接口。
三种接口暴露的寻址单位不同
文件接口通常以路径寻址,例如 /project/video/a.mp4。路径不仅标识数据,还依赖目录层级、文件名和权限等元数据。客户端执行 open、read、write 时,文件系统需要先把路径解析到具体文件,再定位文件内部偏移。
块接口不理解“文件”。操作系统看到的更接近一个可随机读写的逻辑磁盘,例如 /dev/vdb,上层使用逻辑块地址访问扇区或块。假设块大小为 4 KiB,一个 100 MiB 逻辑卷包含 25,600 个 4 KiB 块;文件系统、数据库页结构等更高层语义由客户端自己管理。
对象接口通常使用 bucket 与 key,例如 bucket 为 images、key 为 2026/10/a.jpg。这里的斜杠通常只是 key 字符的一部分,并不意味着服务端一定存在真实目录。一次 GET 或 PUT 面向完整对象,对象还可以携带内容类型、自定义标签等元数据。
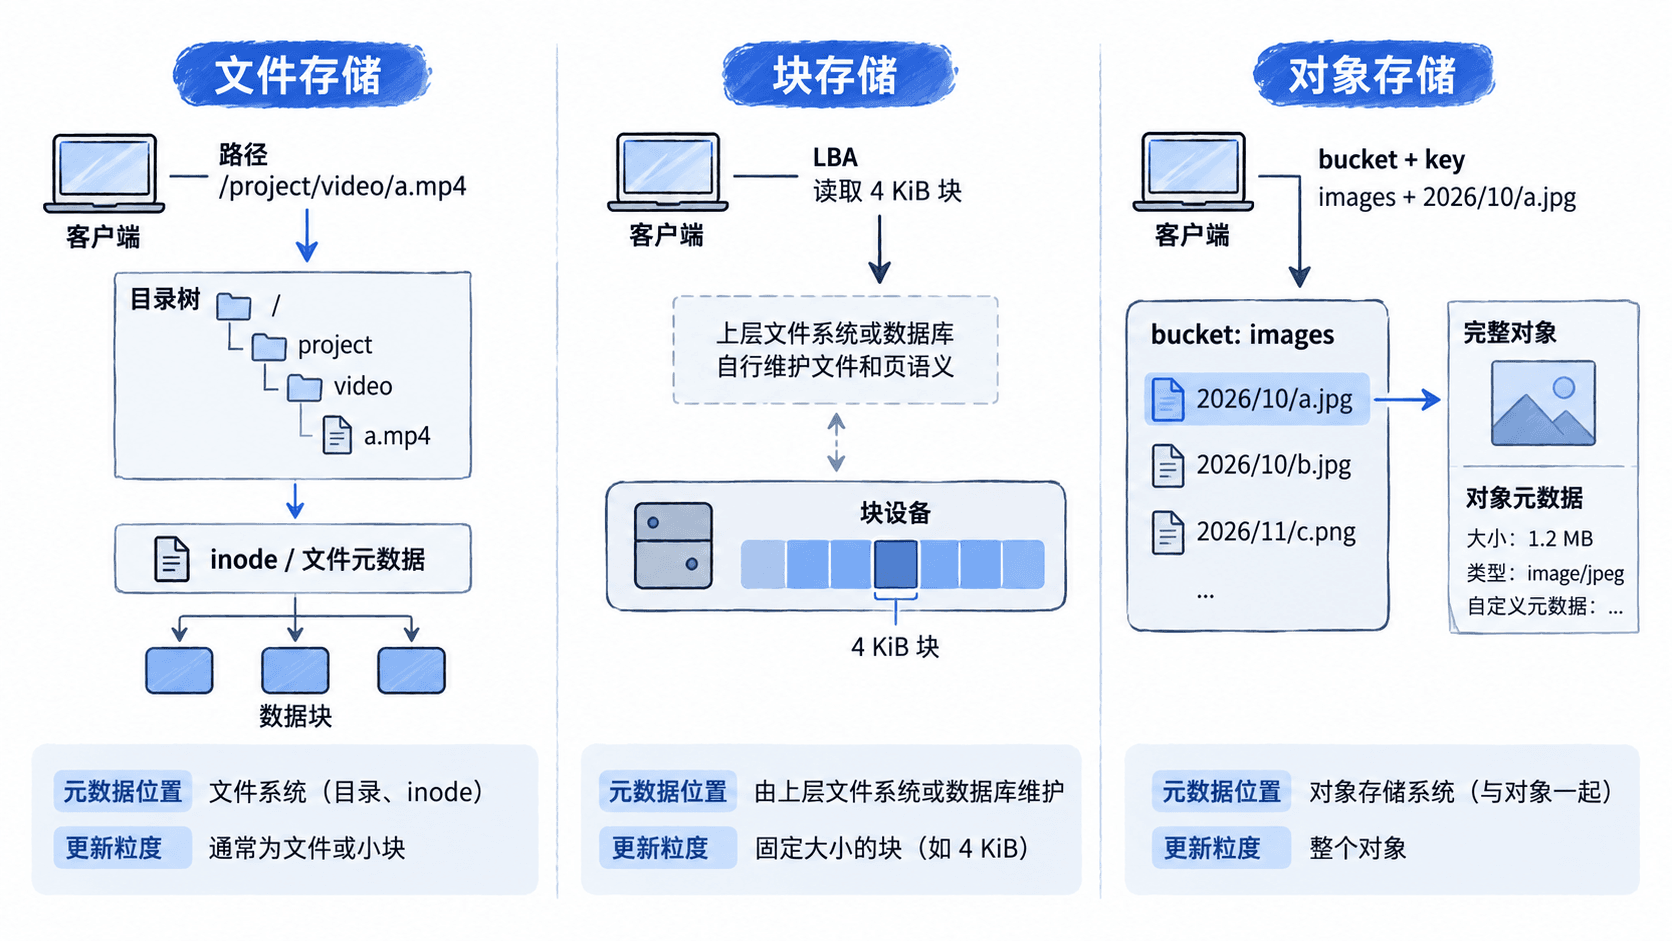
下面的 Python 示例把三种寻址方式压缩成可运行模型,重点观察同一段业务数据在接口层暴露出的地址不同。
from dataclasses import dataclass

@dataclass
class Access:
    interface: str
    address: str
    update_unit: str

accesses = [
    Access("file", "/project/video/a.mp4", "byte range in file"),
    Access("block", "LBA 1024-1279", "4 KiB blocks"),
    Access("object", "images/2026/10/a.jpg", "whole object"),
]

for item in accesses:
    print(f"{item.interface}: {item.address} -> {item.update_unit}")
预期输出:
file: /project/video/a.mp4 -> byte range in file
block: LBA 1024-1279 -> 4 KiB blocks
object: images/2026/10/a.jpg -> whole object
真实系统的 API 会更复杂,但这个模型抓住了设计差异:文件接口保留文件语义,块接口只暴露地址空间,对象接口直接暴露独立对象。
更新粒度决定写入路径
文件接口通常允许按偏移修改。例如一个 1 GiB 日志文件追加 4 KiB 数据,不需要重新上传整个文件;文件系统只需修改相关数据块和文件长度等元数据。因此共享目录、用户主目录和需要频繁追加的文件适合文件语义。
块接口的随机写能力更直接。数据库若使用 16 KiB 页,一次页更新可以映射到连续的若干底层块,而不需要理解文件内容。数据库还能自行控制缓存、预写日志和刷盘顺序,所以关系数据库常把块设备作为底层持久化介质。
对象接口更偏向“替换对象”。如果一个 100 MiB 对象只改中间 4 KiB,典型对象 API 并不提供与本地文件完全等价的任意原地覆盖语义,应用往往需要重新生成对象,或者把数据拆成较小对象后只替换其中一份。因此对象大小设计会直接影响更新成本。
元数据放在哪里会影响扩容
文件系统需要维护目录、文件属性、权限以及路径到数据位置的映射。如果有 1 亿个小文件,真正先形成压力的可能不是容量,而是元数据服务的目录查询和 inode 管理。扩容时还要保证目录命名空间与数据节点之间保持一致。
块存储的核心元数据更接近“逻辑块区间映射到哪些物理设备”。例如一个 1 TiB 逻辑卷可以被切成若干 extent,控制平面记录每个 extent 的副本位置。客户端上层的 /var/lib/db/data 文件名通常并不是块存储服务需要理解的内容。
对象存储则天然适合把 key 映射到分片或哈希空间。新增节点后,可以按哈希范围、分区表或一致性映射迁移部分对象,而不用维持传统目录树的强语义。对象彼此独立也使海量图片、备份和日志归档更容易横向扩容。
一个简单的容量估算能看出粒度差异:若保存 1 亿个平均 64 KiB 的对象,纯数据约为 5.96 TiB;即使每个对象额外需要 200 B 元数据,元数据总量也约 18.6 GiB。实际系统还会有索引、副本和日志开销,因此不能只按用户数据容量规划元数据节点。
根据访问方式选择接口
可以先看应用是否需要保留“文件”这一层语义,再看随机更新粒度。
| 场景 | 更合适的接口 | 关键原因 |
|---|---|---|
| 多台主机共享工程目录 | 文件 | 需要路径、目录和文件权限语义 |
| MySQL、PostgreSQL 数据盘 | 块 | 需要低延迟随机读写,并由数据库管理页和 WAL |
| 图片、视频、备份归档 | 对象 | 对象独立、容量大、便于跨节点扩展 |
| 虚拟机系统盘 | 块 | 客户端需要一个可格式化的逻辑磁盘 |
| 海量构建产物与日志归档 | 对象 | 常见模式是写入后整体读取,很少原地修改 |
如果业务既需要对象级扩容,又频繁改一个“大文件”中的很小区域,不应简单把整个大文件直接做成单对象。更常见的做法是把数据切成固定大小分片,例如 8 MiB 或 64 MiB 一片,再单独保存描述分片顺序的元数据;这样修改局部内容时只替换受影响的分片。
文件、块和对象不是三种不同介质,而是三种不同接口契约。设计存储系统时先明确客户端究竟需要路径语义、随机块地址,还是独立对象,再决定元数据服务、更新策略和分片扩容方式,通常比先选具体存储产品更可靠。