
P2P 与分布式存储 / 系统课时
数据放置映射怎样定位对象分片
数据放置映射怎样定位对象分片
读取对象 obj-17 时,存储系统必须先找到它所属的逻辑分片,再找到保存该分片的物理节点。本课以 8 个逻辑分片、每片 2 个副本为例,比较元数据查询与客户端确定性计算,并用程序验证节点扩容对路由的影响。
学习目标
- 区分对象标识、逻辑分片号与物理节点放置映射。
- 解释查询式路由和确定性计算式路由的请求成本与版本要求。
- 通过可运行示例找出扩容后需要变更副本集合的分片。
先固定对象到逻辑分片的映射
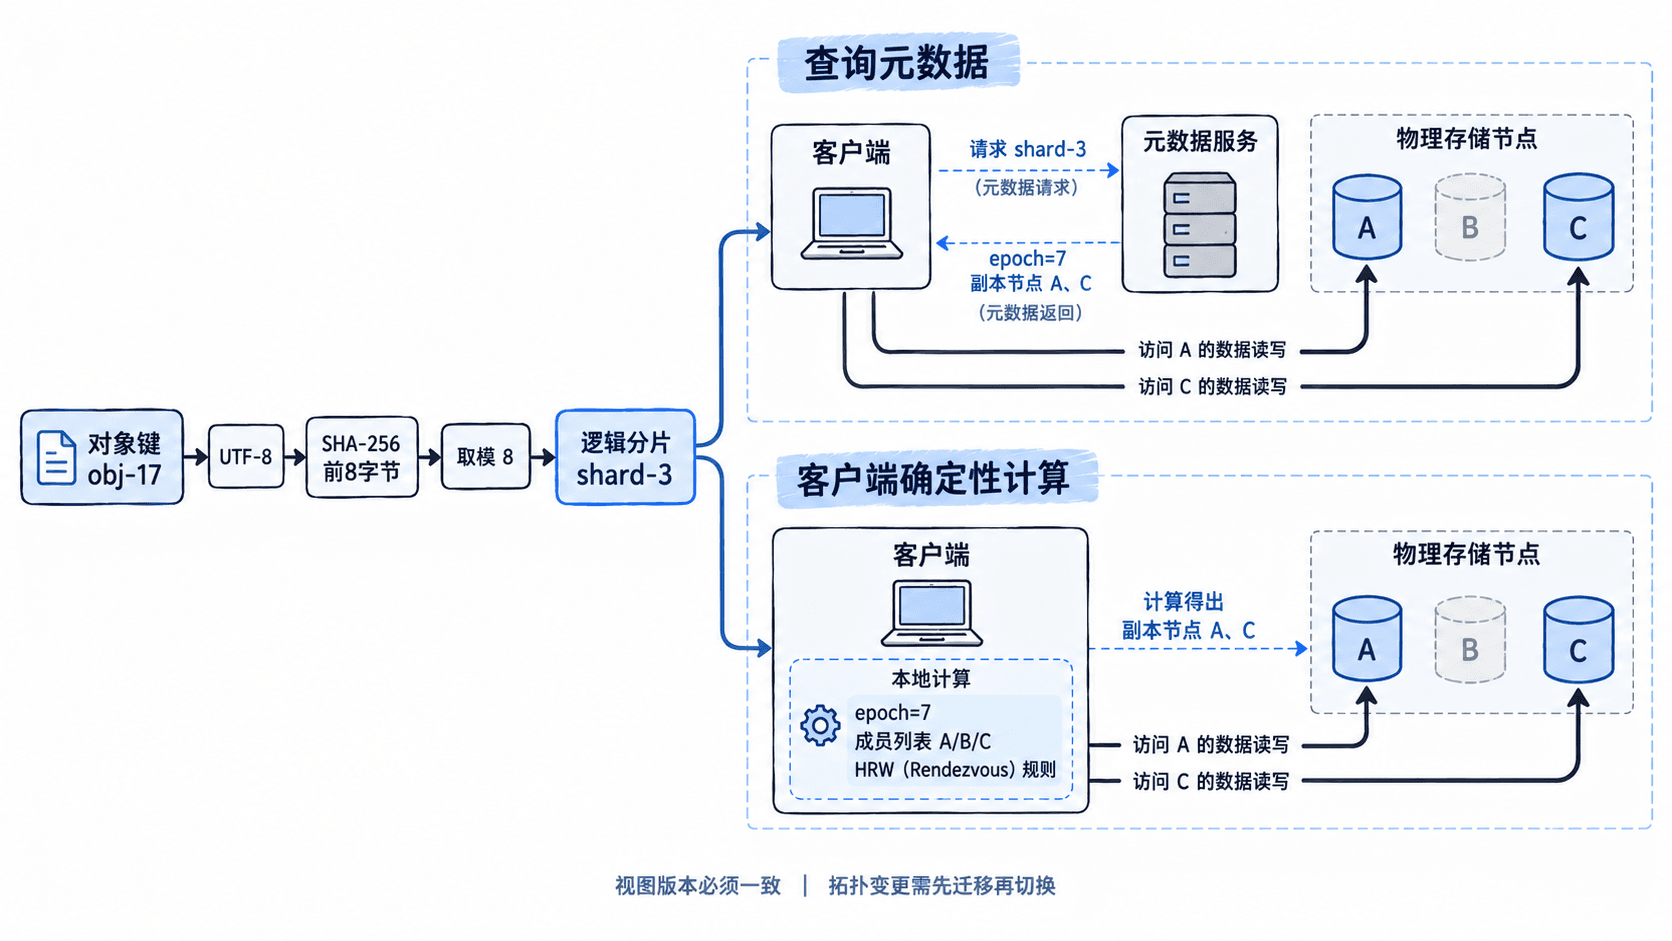
对象标识必须采用一致的格式,例如 bucket/key。本例把标识按 UTF-8 编码,计算 SHA-256 摘要,取前 8 字节作为无符号大端整数,再对 8 取模。obj-17 因此属于 shard-3。使用稳定哈希而不是 Python 内置的 hash(),可以避免不同进程算出不同分片号。
第二层映射是 shardId → 副本节点集合。例如集群视图 epoch=7 中,shard-3 → [A,C];客户端最终访问的是 A 或 C,而非抽象分片号。增加节点 D 时,无须更改 8 个逻辑分片的编号,但其中一些分片的物理放置可能改变。
查询元数据服务如何获得位置
查询式路由把分片放置表集中交给元数据服务管理;客户端不必知道节点选择算法。一次未命中本地缓存的读取可按下列顺序执行:
- 根据对象键算出
shard-3;也可以由元数据服务直接接收对象键并解析。 - 查询该分片的放置记录,拿到
epoch=7及副本列表[A,C]。 - 按读一致性策略选择副本发起读取;若收到路由已过期信息,则获取新视图后重试。
代价是缓存未命中时多一次查询。假设元数据 RPC 往返耗时 3 ms,串行查询就可能给读路径增加约 3 ms。客户端可缓存例如 5 秒,但仅靠过期时间不足以防止迁移期误写:写入还须由服务端检查有效视图版本或主节点任期。
这种方式便于把热点分片单独迁移到节点 D,或按机架、容量设置放置例外;代价是元数据服务需要具备高可用能力,并承受缓存未命中的查询流量。
客户端如何确定性计算副本节点
计算式路由让客户端持有相同的成员列表、哈希规则及 epoch,不用为每次对象访问询问元数据服务。下面采用 HRW(Rendezvous Hashing):对每个候选节点计算 SHA-256(shardId|nodeId),按哈希得分排序,选前 2 个作为副本候选。
当成员集合由 [A,B,C] 变为 [A,B,C,D],同一个对象仍然属于原来的逻辑分片,但部分分片会选择 D。客户端必须先获取生效的新版本,不能因发现 D 在线就立即自行切换。本例的 HRW 仅展示规则计算;生产部署还应限制副本不能集中在同一故障域,并考虑节点容量和健康状态。
| 比较项 | 查询式 | 确定性计算式 |
|---|---|---|
| 单次定位 | 读元数据或缓存 | 本地执行规则 |
| 变更发布 | 更新分片放置记录 | 分发成员、规则与版本 |
| 特殊放置 | 可直接登记例外 | 需额外规则或覆盖表 |
用 Python 核对两种路由
将下面程序保存为 placement_demo.py,使用 Python 3.9 或更新版本执行 python placement_demo.py。metadata_v7 是模拟的元数据快照,不是真实网络 RPC;两个分支使用同一规则,目的是核对结果是否一致。
import hashlib

SHARD_COUNT = 8

def shard_of(key):
    # 使用稳定字节编码和哈希,保证不同客户端算出同一分片
    digest = hashlib.sha256(key.encode("utf-8")).digest()
    return int.from_bytes(digest[:8], "big") % SHARD_COUNT

def owners(shard, nodes):
    # HRW 评分选前两个;此演示尚未加入机架故障域限制
    return tuple(sorted(
        nodes,
        key=lambda node: hashlib.sha256(
            f"{shard}|{node}".encode("utf-8")
        ).digest(),
        reverse=True
    )[:2])

def main():
    v7_nodes = ("A", "B", "C")
    v8_nodes = ("A", "B", "C", "D")
    # 把预先算好的结果当作元数据服务返回的 epoch=7 快照
    metadata_v7 = {s: owners(s, v7_nodes) for s in range(SHARD_COUNT)}
    shard = shard_of("obj-17")

    print(f"obj-17 -> shard-{shard}")
    print("元数据查询 v7:", metadata_v7[shard])
    print("客户端计算 v7:", owners(shard, v7_nodes))
    print("新拓扑候选 v8:", owners(shard, v8_nodes))
    changed = [
        s for s in range(SHARD_COUNT)
        if set(metadata_v7[s]) != set(owners(s, v8_nodes))
    ]
    print("副本集合变化的分片:", changed)

if __name__ == "__main__":
    main()
预期输出:
obj-17 -> shard-3
元数据查询 v7: ('A', 'C')
客户端计算 v7: ('A', 'C')
新拓扑候选 v8: ('A', 'D')
副本集合变化的分片: [0, 1, 2, 3, 6]
可见对象键到 shard-3 的结果没有改变;变化的是分片到物理副本的映射。这里 8 个分片中有 5 个的副本集合发生变化,是给定示例拓扑的计算结果,不代表实际集群的固定迁移比例。
更新映射时怎样避免读错节点
epoch=8 只能作为候选方案,不能因为程序算出 A、D 就立刻把读取切往 D。以 shard-3 为例,安全切换至少要依次完成以下动作:
- 保持生效视图为
epoch=7,将 A 上对应数据复制到 D,并追赶复制期间的增量写入。 - 校验 D 上数据完整性、版本或提交进度,确认新副本已具备接收请求的条件。
- 由集群控制面提交新的放置视图
epoch=8,通知客户端刷新缓存;旧版本请求按系统协议重定向或拒绝后重试。 - 对写请求同时校验有效的主副本授权或任期栅栏,避免旧主依据旧路由继续确认写入。
无论使用元数据查询还是客户端计算,最终都需要把对象键到分片与分片到节点分开管理,并让读写请求使用已生效、可校验的集群视图。