
P2P 与分布式存储 / 系统课时
读修复和反熵如何消除副本分歧
读修复和反熵如何消除副本分歧
同一个对象在三台节点上可能出现不同版本:两台已写入新值,第三台仍保存旧值。本课用可运行的三副本模拟器制造这种分歧,分别观察读取触发的修复与后台反熵回填,并检查它们不能安全覆盖数据的边界。
学习目标
- 区分读修复与反熵的触发方式、覆盖范围和适用条件。
- 运行 Python 实验,按版本比较、发现差异并回填缺失记录。
- 识别并发冲突、删除标记和仲裁读写中的修复风险。
构造两个不一致的对象
设有固定副本集合 A、B、C。doc 的版本 v1 原先存在于三台节点;新版 v2 只成功写到 A、B,C 在写入时离线。另一个对象 tag 的 v1 也只到达 A、B。
| 副本 | doc |
tag |
|---|---|---|
| A | v2,新稿 | v1,蓝 |
| B | v2,新稿 | v1,蓝 |
| C | v1,旧稿 | 缺失 |
实验假定每个对象由同一写入权威分配单调递增的版本号,v2 必定比 v1 新;它不是各节点独立生成的时间戳。若写入需至少 W=2 份确认、读取访问 R=2 份,且 N=3,则 W+R=4>N,可使成功读写集合相交,但仍须处理并发写入与故障切换等条件,不能仅凭公式宣称线性一致性。
读修复如何借一次 GET 纠正旧值
客户端读取 doc 时,协调器向 A、C 请求值和版本。A 返回 v2,C 返回 v1;协调器依据版本选择“新稿”,再把 v2 回填 C。实际系统可选择先返回再异步修复,避免让本次读取等待额外写盘;也可能采用同步修复以加强特定保证。
- 查询至少两个副本,保留每份响应的版本和内容摘要。
- 确定可比较的最高版本 v2,返回“新稿”。
- 仅对本次发现落后的 C 安排幂等回填;回填前仍需防止覆盖期间产生的更高版本。
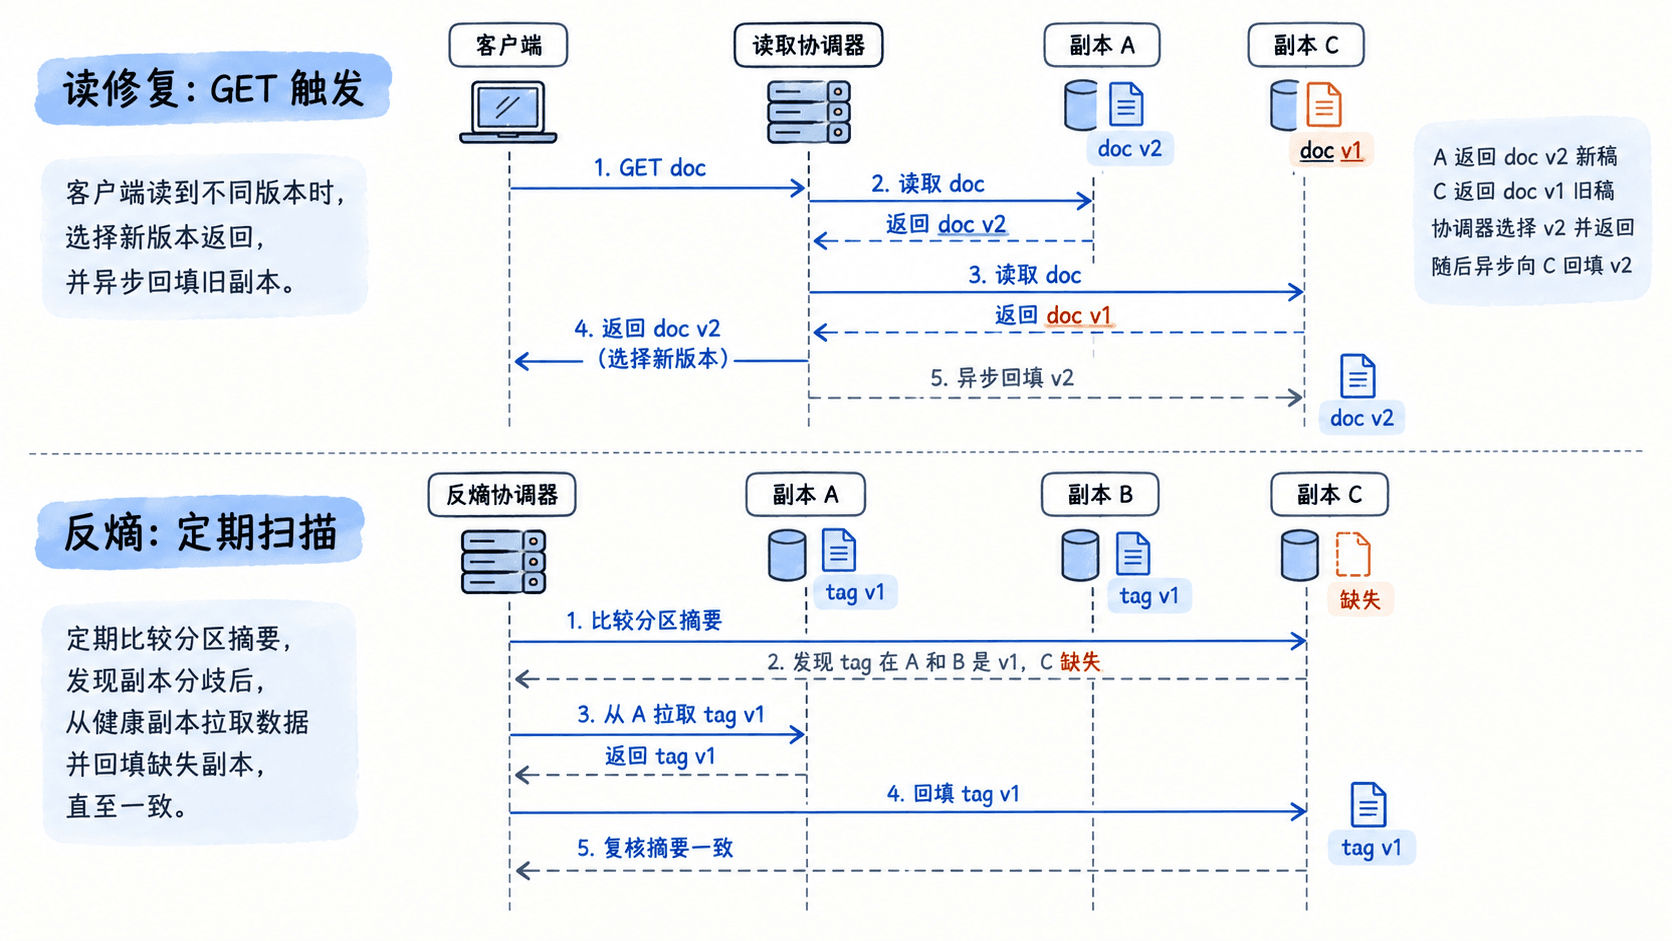
读修复只覆盖被读到且参与比较的副本。若这次只访问 C,就没有 v2 可供比较,无法凭空得知自己读到了旧值;无人读取的 tag 也不会因此恢复。
用 Python 复现读修复与反熵
把下面的完整程序保存为 repair_demo.py,使用 Python 3.10 或更新版本运行。为了清楚观察差异,示例的修复是同步执行的,且把“更大版本号”当作唯一合法的新旧判据。
from dataclasses import dataclass

@dataclass(frozen=True)
class Record:
    version: int
    value: str

replicas = {
    "A": {"doc": Record(2, "新稿"), "tag": Record(1, "蓝")},
    "B": {"doc": Record(2, "新稿"), "tag": Record(1, "蓝")},
    "C": {"doc": Record(1, "旧稿")},
}

def newest(items):
    latest = max(items, key=lambda r: r.version)
    # 同一权威版本不应对应两份不同内容。
    if any(r.version == latest.version and r.value != latest.value for r in items):
        raise ValueError("同一版本的内容冲突")
    return latest

def converge(key, nodes):
    existing = [replicas[n][key] for n in nodes if key in replicas[n]]
    latest = newest(existing)
    changed = []
    for node in nodes:
        current = replicas[node].get(key)
        # 只补缺失或旧版本,不回退更高版本。
        if current is None or current.version < latest.version:
            replicas[node][key] = latest
            changed.append(node)
    return latest, changed

# 前台读 A、C,发现 C 的 doc 落后。
value, changed = converge("doc", ("A", "C"))
print(f"读修复: doc={value.value}, v{value.version}, 回填={','.join(changed)}")

# 后台遍历所有键和副本,模拟最简单的全量反熵。
changes = []
keys = sorted(set().union(*(data.keys() for data in replicas.values())))
for key in keys:
    _, updated = converge(key, ("A", "B", "C"))
    changes.extend(f"{key}->{node}" for node in updated)
print("反熵:", ", ".join(changes))
print("C 最终:", [(key, record.version, record.value)
                for key, record in sorted(replicas["C"].items())])
预期输出:
读修复: doc=新稿, v2, 回填=C
反熵: tag->C
C 最终: [('doc', 2, '新稿'), ('tag', 1, '蓝')]
先执行的读修复只让 C 的 doc 升到 v2;随后反熵把没有被客户端读取的 tag 补到 C。这是两种机制互补、而非互相替代的可观测证据。
后台反熵如何发现长期无人读取的差异
反熵不依赖 GET。后台任务周期性地比较副本内容:小实验可枚举全部键,真实集群则常按逻辑分区交换摘要或 Merkle 树哈希,先找出不一致的区域,再下载对象键、版本及必要的数据,最后进行限速回填。
例如每轮只扫描一个分区、最多修复 100 个对象,并在下一轮从游标继续,这是一组可调整的实验限流值,不是通用产品默认值。对 tag 来说,A、B 的版本都是 v1,C 无记录;反熵发现这个差集后,把完整的 v1 写给 C,再比较摘要确认收敛。单靠检查版本不够稳妥:同版本不同内容也应检查校验和并报错。
避免错误覆盖与删除复活
本例用单写入权威的整数版本排序,因此 v2 可以安全压过 v1。多主写入若各自生成“v2”,两个内容可能处于并发关系而不是新旧关系;不能随意选一个覆盖另一个,应采用因果版本信息、冲突保留或业务合并策略。程序对“同版本不同值”主动抛错,就是避免静默丢数据。
删除也必须作为带更高版本的墓碑记录传播。例如删除 doc 应产生 v3 墓碑,而不是直接从 A 删除键;否则后台看到 B 的 v2 时,可能把已经删除的对象重新复制回来。墓碑只能在确认旧副本不会再带回早期版本后安全清理。
验收时分别核对两个时刻:读修复后 C 的 doc 为 v2、tag 仍缺失;反熵后 C 同时拥有 doc v2 和 tag v1。若无法判定唯一较新版本,宁可保留冲突等待协调,也不要把“副本最终相同”误当成“数据一定正确”。