
P2P 与分布式存储 / 系统课时
单机存储在哪些故障下不可用
单机存储在哪些故障下不可用
单机存储的问题不只是“磁盘坏了会丢数据”。同一份数据只有一个服务实例和一台机器承载时,磁盘、进程、主机与网络任一层故障,都可能让客户端无法访问。本篇用四种具体故障拆开“数据是否还在”和“服务是否可用”,并据此定义后续分布式存储要解决的设计目标。
学习目标
- 区分磁盘损坏、进程退出、整机宕机和网络中断对应的故障域。
- 判断一次故障属于数据丢失、服务不可用,还是两者同时发生。
- 用容量、持久性、可用性和恢复时间描述一个存储系统的目标。
先把单机存储拆成四层
假设业务只有一台存储服务器 S1,内部运行一个存储进程,数据写在本地 SSD 上;客户端必须通过网络访问它。即使数据只有一份,这条访问链也至少包含四个独立环节:磁盘、进程、整机和网络。
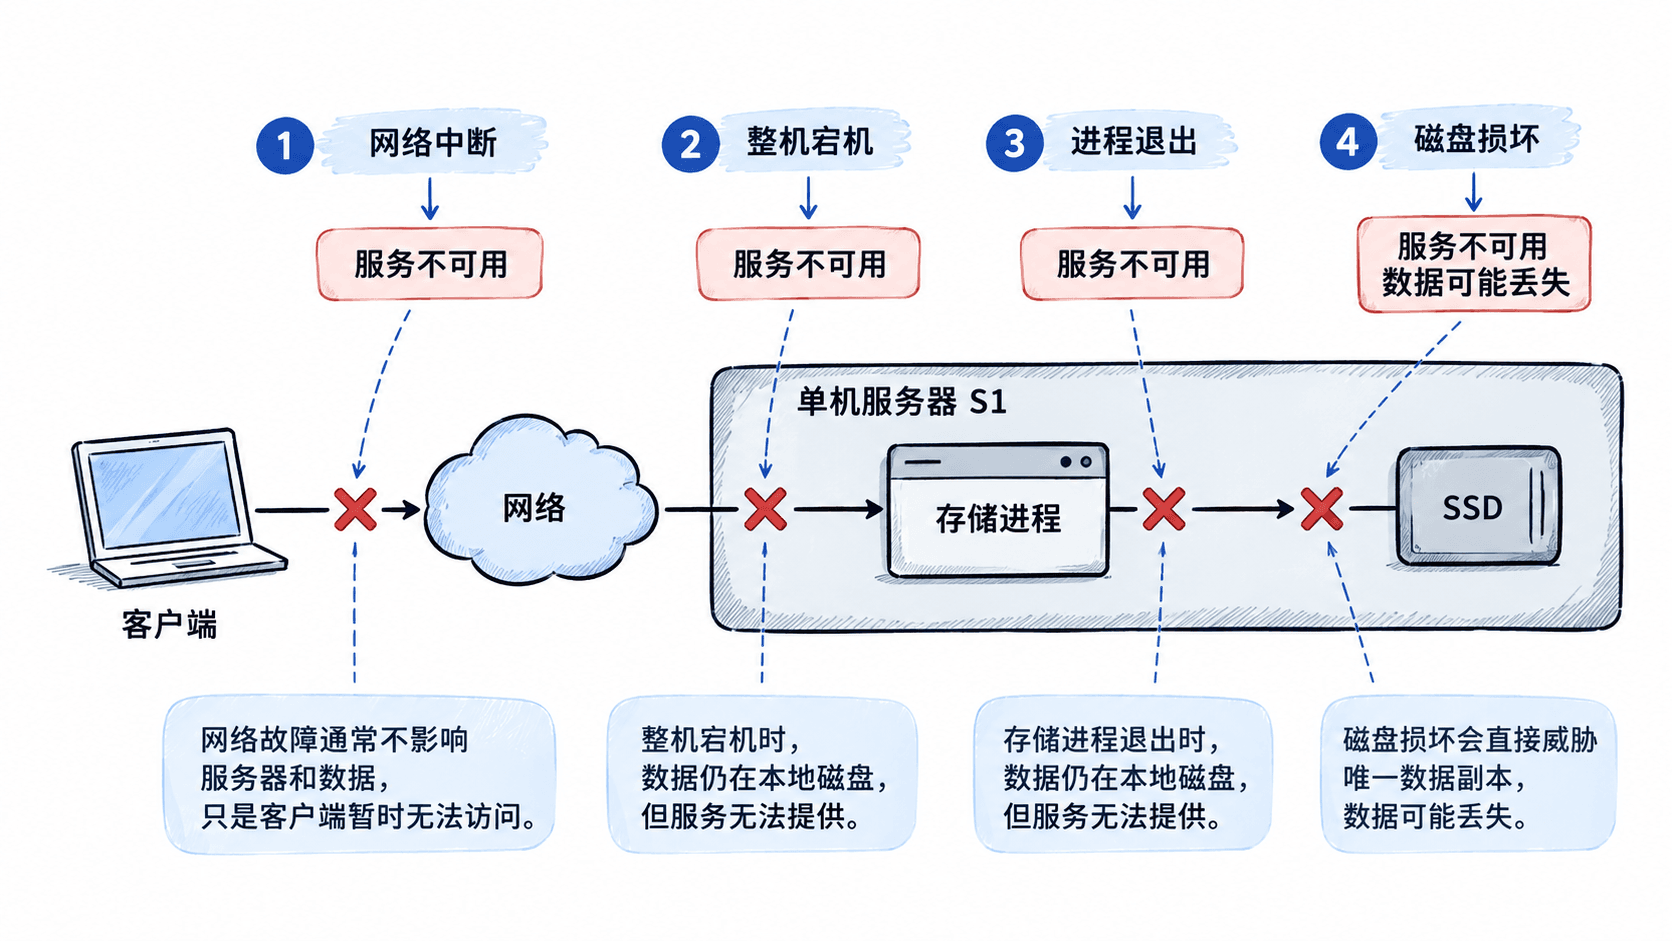
这四层不能混成一个“服务器挂了”。例如存储进程崩溃后,SSD 上的数据通常仍然存在;而 SSD 发生不可恢复的介质故障时,即使操作系统和网络完全正常,唯一副本仍可能永久消失。设计容错方案前必须先明确故障发生在哪一层。
区分数据丢失和服务不可用
以一个只有单节点 S1、没有远端副本的系统为例,可以直接用下面的判断表排查故障后果。
| 故障 | 数据是否可能仍在 | 客户端能否继续读写 | 典型恢复动作 |
|---|---|---|---|
| 存储进程退出 | 通常仍在本地磁盘 | 不能 | 重启进程,约数秒到数分钟 |
| 网络中断 | 通常仍在服务器 | 不能 | 恢复链路或路由 |
| 整机断电或宕机 | 通常仍在非易失介质 | 不能 | 重启主机并完成存储恢复 |
| SSD 不可恢复损坏 | 唯一副本可能丢失 | 不能 | 更换磁盘;无其他副本时无法恢复原数据 |
因此,“不可用”不等于“数据丢失”。例如一次 10 分钟的交换机故障可能让服务连续 10 分钟不可访问,但磁盘数据一字未丢;相反,如果唯一 SSD 损坏,服务即使 2 小时后重新启动,也无法凭空恢复已经失去的数据。
用四个指标描述设计目标
讨论存储可靠性时,至少要把容量、持久性、可用性和恢复时间分开。假设业务要保存 10 TB 数据,可以先写出一组可检查的目标,而不是笼统要求“高可靠”。
- 有效容量:用户实际可存 10 TB。若以后采用 3 副本,原始磁盘需求至少约为 30 TB,尚未计元数据和预留空间。
- 持久性:已经确认成功的数据,在故障后仍然存在。它关注“数据最终会不会丢”,不是请求能否立即返回。
- 可用性:请求在指定时间内能否获得服务。例如按月统计可用性 99.9%,30 天内允许的不可用时间约为 43.2 分钟。
- 恢复时间目标 RTO:发生故障后最多允许多久恢复服务。例如 RTO=5 分钟意味着从故障发生到重新提供服务应控制在 5 分钟内。
可用性 99.9% 的月度停机预算可直接按下面的关系计算:
这个数字能立刻暴露单机方案的问题:如果一次主机故障需要人工处理 2 小时,那么单次事故就已经超过整个月的 99.9% 可用性预算。
用故障矩阵检查单机方案
对一个没有副本的节点,可以用两个问题检查每种故障:数据还有没有别的独立副本,以及是否还有别的节点能接管请求。单机系统对这两个问题通常都回答“没有”。
例如,S1 的 SSD 损坏时,因为没有第二份数据,所以持久性目标失败;S1 只是进程崩溃时,数据虽然仍在,但没有第二个服务实例接管,因此可用性目标仍然失败。两种事故最终都表现为“客户端访问失败”,但后续解决方法完全不同:前者需要增加独立数据副本,后者需要增加可接管请求的服务节点和故障切换机制。
实际设计时可以先为每个故障域填写“允许损失”和“允许中断”。如果要求任意一块磁盘损坏时数据不能丢、任意一台机器宕机时服务仍可读写,那么单机模型天然无法满足要求,下一步就必须把数据和服务能力分散到多个独立节点,而不是继续提高单台机器的规格。