
P2P 与分布式存储 / 系统课时
尾延迟飙高时怎样定位热点与修复争用
尾延迟飙高时怎样定位热点与修复争用
当分布式存储的平均延迟变化不大、P99 却突然飙高时,问题可能来自少数分片的访问热点,也可能来自后台数据修复抢占磁盘和网络资源。本课通过一组模拟监控数据构造异常时间线,定位两类争用的证据,并设计可回滚的限流与负载调整实验。
学习目标
- 结合 P50、P95、P99 和节点资源指标还原性能异常发生的时间顺序。
- 利用分片请求量与后台修复吞吐区分访问热点和恢复争用。
- 通过单变量干预和连续观测验证修复是否有效。
先锁定受影响请求与时间窗口
尾延迟表示请求延迟分布中较慢的一部分。P99 为 520 ms,意味着约 99% 的请求在 520 ms 内完成,剩余约 1% 更慢。它不能说明所有请求都变慢,也不能单独证明磁盘已经饱和。
排查时先固定 1 分钟统计窗口,分别观察 GET、PUT 请求,再按节点、分片和请求来源拆分。每个窗口应记录请求数量;样本不足数千次时,P99 容易受到个别慢请求影响,可以适当合并窗口。
建议按下面的顺序收集证据:
- 前台请求:P50、P95、P99、错误率、超时率和吞吐量。
- 分片负载:每个分片的 QPS、请求字节数、所在节点以及最热分片与中位分片的负载比。
- 磁盘资源:读写吞吐、设备利用率、I/O 等待时间和队列积压。
- 网络资源:节点网卡收发速率,以及客户端流量和副本复制、修复流量的构成。
- 后台任务:修复读取与写入速率、并发任务数、待修复字节数及任务失败重试次数。
在安装了 sysstat 的 Linux 节点,可以运行 iostat -x -d 1 5 查看磁盘扩展统计,运行 sar -n DEV 1 5 查看网卡吞吐。预期分别能看到 %util、await 或读写等待字段,以及 rxkB/s、txkB/s 等字段;具体列名随 sysstat 版本变化,数值取决于实际负载。iostat 的首份报告通常是启动以来的累计平均,应优先比较后续采样。
构造异常发生前后的性能时间线
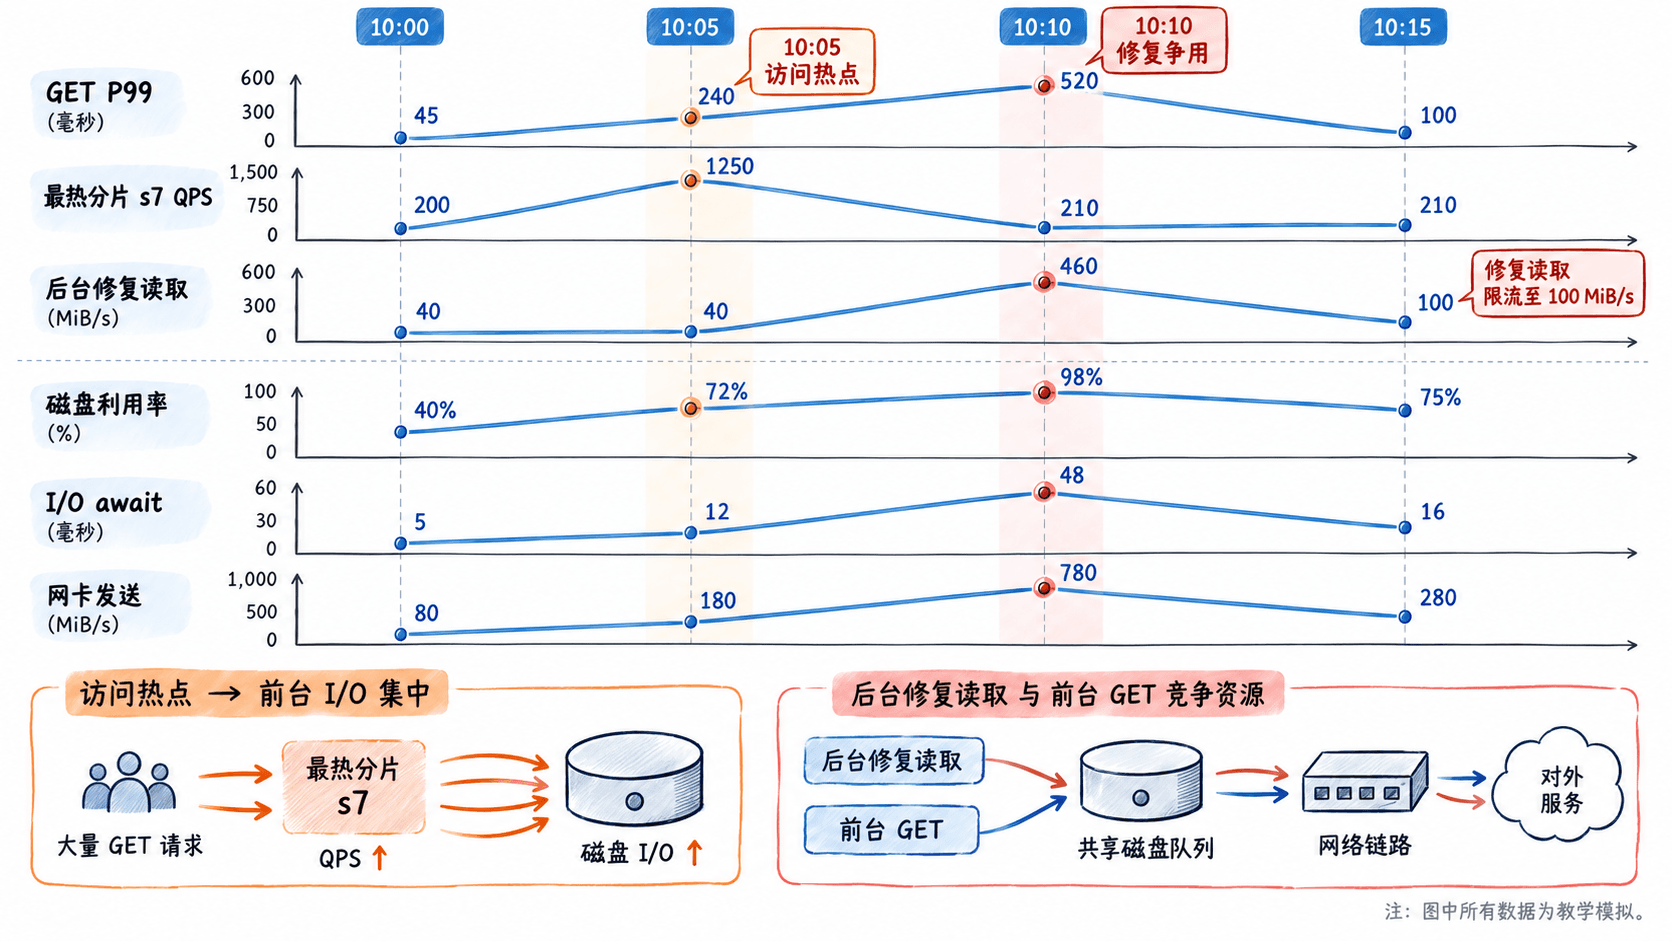
假设一个三副本对象存储集群在 10:05 出现 GET 尾延迟升高,10:10 进一步恶化。以下是同一受影响节点上连续采集的教学模拟数据,每行代表对应时刻附近的 1 分钟窗口。最热分片记为 s7,所有速率均为窗口平均值。
| 时间 | GET P50/P95/P99(ms) | s7 QPS | 修复读取(MiB/s) |
|---|---|---|---|
| 10:00 | 8 / 24 / 45 | 200 | 40 |
| 10:05 | 9 / 70 / 240 | 1250 | 40 |
| 10:10 | 12 / 165 / 520 | 210 | 460 |
| 10:15 | 9 / 40 / 100 | 210 | 100 |
与请求指标对齐的节点资源数据如下。10:15 是降低后台修复速率后的第一个观察窗口。
| 时间 | 磁盘 %util | I/O await(ms) | 网卡发送(MiB/s) |
|---|---|---|---|
| 10:00 | 40% | 5 | 80 |
| 10:05 | 72% | 12 | 180 |
| 10:10 | 98% | 48 | 780 |
| 10:15 | 75% | 16 | 280 |
10:05 的特征是 s7 请求量从 200 QPS 增加到 1250 QPS,增长 6.25 倍,而修复读取仍为 40 MiB/s。这支持访问热点假设。10:10 时 s7 已恢复到约 210 QPS,P99 却升至 520 ms,同时修复读取和磁盘等待明显增加,因此应优先调查修复争用。
用指标组合判断主要争用来源
访问热点通常表现为少数分片的 QPS 或请求字节数显著高于其他分片,且其所在节点的前台吞吐、队列等待或 CPU 使用率同步增加。如果最热分片 QPS 增加但请求字节数很小,还要排查锁竞争、元数据访问和单分片调度瓶颈。
后台修复争用则常见于节点失效后的副本重建。读取健康副本、跨节点传输和向目标节点写入都会消耗资源。即使前台 QPS 不变,修复任务也可能让共享磁盘的等待时间和网络带宽占用突然升高。
下面使用 Python 3 标准语法对上述模拟时间线做一次初筛。阈值是本案例基于健康窗口设定的诊断规则,不是通用的生产告警标准。
# 健康窗口的分片请求率和后台修复速率
baseline = {'hot_qps': 200, 'repair_mib_s': 40}
samples = [
    ('10:05', 240, 1250, 40, 72),
    ('10:10', 520, 210, 460, 98),
    ('10:15', 100, 210, 100, 75),
]

# 同时比较负载变化和资源占用,避免仅凭P99定因
for time, p99, qps, repair, util in samples:
    if qps >= baseline['hot_qps'] * 3 and repair < baseline['repair_mib_s'] * 2:
        result = '访问热点线索'
    elif repair >= baseline['repair_mib_s'] * 5 and util >= 90:
        result = '修复争用线索'
    else:
        result = '需结合干预记录复核'
    print(f'{time} p99={p99}ms | {result}')
预期输出:
10:05 p99=240ms | 访问热点线索
10:10 p99=520ms | 修复争用线索
10:15 p99=100ms | 需结合干预记录复核
初筛只能缩小调查范围,不能代替因果验证。如果分片负载与修复速率同时升高,应检查它们是否竞争同一个磁盘、网卡或线程池,不能按脚本中的判断顺序直接认定单一根因。
分别处理热点与修复争用
当证据指向访问热点时,优先查看请求类型和副本一致性要求。对于允许从多个健康副本读取的 GET,可以调整读路由或增加热点数据缓存;如果热点集中在某个对象或租户,还可以实施针对性的请求限速。调整后检查单分片 QPS 是否下降,以及请求是否只是转移到另一台过载节点。
对于必须经过主节点或所有者串行处理的写入,不能简单把写请求随机分发给其他副本。需要通过受控的分片拆分、写入调度或客户端限流来降低集中负载,不能破坏原有版本顺序和一致性协议。
当证据指向后台修复争用时,可以在存储系统支持的资源调度接口中限制修复并发与读取带宽。例如将该节点修复读取预算从 460 MiB/s 降为 100 MiB/s,并将最大并发修复任务从 8 调至 2。这里的数值是诊断实验参数,具体配置接口与可用范围必须以实际存储产品为准。
调整应保留原始参数和回滚方式,并继续监控剩余冗余度、待修复字节数与预计完成时间。已经低于安全冗余要求的对象应维持更高修复优先级,不能为了降低 P99 无限期暂停修复。
用连续窗口验证修复效果
单个改善窗口不能证明故障已消除。10:15 的模拟数据中,修复速率降至 100 MiB/s,磁盘利用率从 98% 降至 75%,P99 从 520 ms 降至 100 ms,这支持修复争用假设,但仍需要排除其他同期负载变化。
可以为本次实验设定以下示例验收条件:
- 连续 5 个一分钟窗口,GET P99 不超过 120 ms,错误率低于 0.1%。
- 受影响磁盘利用率回落至 85% 以下,I/O 等待时间不再持续上升。
- 前台吞吐没有因限流明显下降,其他副本节点也没有出现新的尾延迟峰值。
- 后台修复保持进展,待修复字节数总体下降,预计恢复时间满足故障风险要求。
若降低修复预算后 P99 改善,但恢复积压持续扩大,应逐步提高修复并发或把修复任务分散到其他有余量的节点,每次只调整一个变量,并观察至少数个完整统计窗口。
最终应保存异常前、异常中和干预后的同口径指标,以及配置变更时间。这样既能解释尾延迟为什么升高,也能判断改善是否来自真实的资源争用缓解,而不是访问热点恰好自然消退。