
P2P 与分布式存储 / 系统课时
故障恢复为何需要优先级和限速
故障恢复为何需要优先级和限速
当多个存储节点同时离线时,修复副本和重建纠删码分片会与正常读写争夺网络、磁盘及 CPU。本篇用一组可核算的故障数据,确定先修什么、允许同时修多少,以及前台业务变慢时如何自动收紧恢复速度。
学习目标
- 根据可恢复性、剩余容错次数和业务影响为恢复任务分级。
- 计算共享链路的恢复带宽预算,并限制后台并发任务数。
- 用 Python 模拟派发顺序,制定恢复过程中的降速与验收条件。
为什么同时修复会让故障扩大
假设一个 12 节点集群先后有 3 台节点离线,元数据统计出约 600 GiB 待重建数据。后台队列若同时启动 40 个任务,每个尝试传输 80 MiB/s,就会提出 3200 MiB/s 的带宽需求;而 10 Gb/s 链路的理论上限只有约 1192 MiB/s,还未扣除协议开销。
争抢链路会使前台读写延迟上升,恢复任务也因超时重试而进一步排队。纠删码重建还要读取多个存活分片,因此“待写回 600 GiB”不等于实际网络读取量。生产系统应先按故障域聚合任务,确认目标节点有足够空间,再分批放行。
先检查能不能修,再判断修复顺序
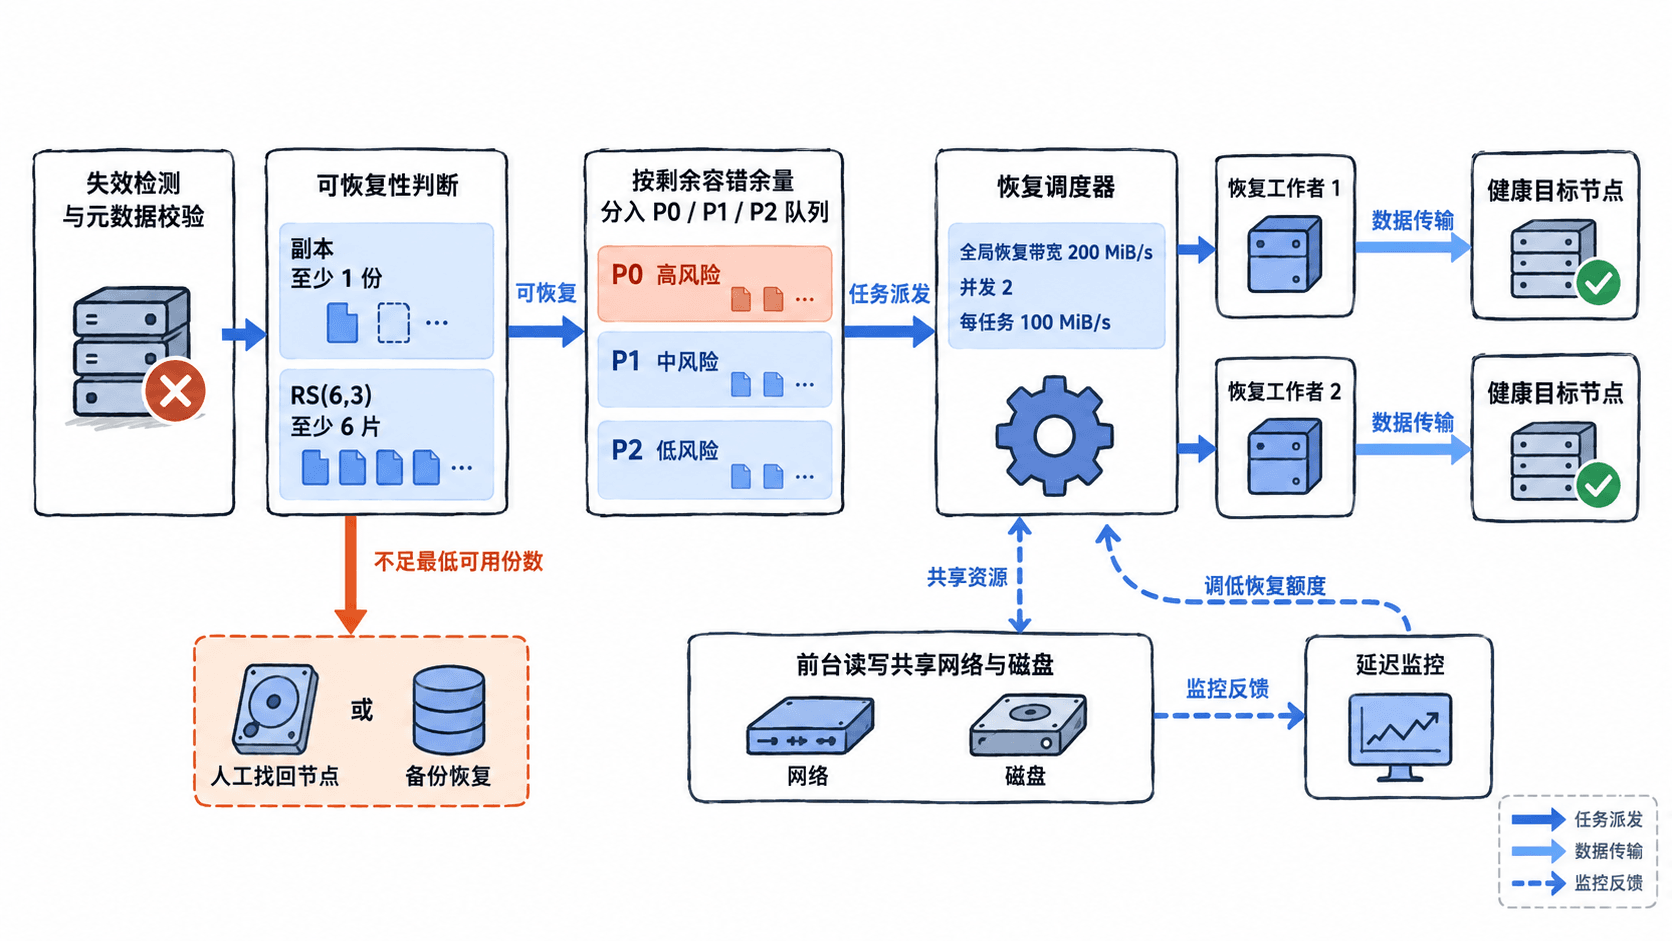
三副本对象只要还保有 1 份经过校验的完整副本,就可以复制恢复;RS(6,3) 条带通常至少需要 6 份可用且版本一致的分片才能解码。定义剩余容错余量为“可用份数 − 最低可恢复份数”:余量为 0 记 P0,余量为 1 记 P1,余量不小于 2 记 P2。余量为负的对象不得进入普通重建队列。
| 受损数据 | 可用/总份数 | 容错余量 | 处置 |
|---|---|---|---|
| 订单索引:三副本 | 1/3 | 0 | P0,立即恢复 |
| 媒体条带:RS(6,3) | 6/9 | 0 | P0,立即恢复 |
| 在线检索:RS(6,3) | 7/9 | 1 | P1,随后恢复 |
| 归档对象:三副本 | 2/3 | 1 | P1,随后恢复 |
| 历史损坏:RS(6,3) | 5/9 | -1 | 停止自动解码,找回节点或使用备份 |
同一级内先恢复影响在线交易、检索等关键业务的数据,再看等待时间和修复耗时。不要仅凭“缺了几份”排序:三副本只剩 1 份与 RS 条带只剩 6 片,都已经不能再承受一次对应分片丢失。若副本集中在同一机架,还必须按故障域重新评估风险。
给恢复流量和工作线程设置硬上限
以 10 Gb/s 机架出口为例,理论带宽约 1192 MiB/s。假设监控显示前台高峰占用 650 MiB/s,预留 250 MiB/s 应对流量波动,后台可用预算约为 292 MiB/s。先保守设置全局恢复上限 200 MiB/s、并发数 2、单任务额度 100 MiB/s,而不是放开 40 个任务。
这三个数必须在真实传输路径执行:所有恢复工作者共享网络令牌桶,并用工作者信号量限制并发;同时对源节点磁盘读、目标节点磁盘写及跨机架流量分别设预算。标准 RS(6,3) 单片修复可能读取 6 片才能生成 1 片,不能只统计目标写入字节。若简单把 600 GiB 都当作一次跨网复制,200 MiB/s 下的理想传输时间也有 51.2 分钟,实际通常更长。
模拟风险排序和配额派发
下图把故障检查、优先级队列、恢复调度器及资源反馈放在一条链路里。注意“不可解码”分支不能被高优先级标签误送进普通重建工作者。
以下程序适用于 Python 3.10 及以上,仅模拟任务挑选与额度分配,不会操作存储节点,也不会替真实传输执行限速。保存为 repair_queue.py,执行 python repair_queue.py。
from dataclasses import dataclass

@dataclass(frozen=True)
class Task:
    name: str
    live: int
    minimum: int
    total: int
    critical_business: bool

tasks = [
    Task("订单索引(三副本)", 1, 1, 3, True),
    Task("媒体条带(RS6+3)", 6, 6, 9, False),
    Task("在线检索(RS6+3)", 7, 6, 9, True),
    Task("归档对象(三副本)", 2, 1, 3, False),
    Task("历史损坏(RS6+3)", 5, 6, 9, True),
]

# 不可解码对象进入单独的人工恢复路径。
blocked = [t for t in tasks if t.live < t.minimum]
ready = [t for t in tasks if t.minimum <= t.live < t.total]

# 先比较容错余量,业务重要性只在同等风险下决定先后。
ready.sort(key=lambda t: (
    t.live - t.minimum, not t.critical_business, t.name
))

total_mib_s = 200
max_workers = 2
per_worker_mib_s = total_mib_s // max_workers

print("排队:")
for t in ready:
    slack = t.live - t.minimum
    level = f"P{min(slack, 2)}"
    print(f"{level} {t.name} {t.live}/{t.total}")
print("人工处置:")
for t in blocked:
    print(f"{t.name} {t.live}/{t.total}")

# 本轮最多派发两个任务,合计配额不超过全局预算。
print("派发:")
selected = ready[:max_workers]
for t in selected:
    print(f"{t.name}: {per_worker_mib_s} MiB/s")
print(f"预算: {len(selected) * per_worker_mib_s} MiB/s,{len(selected)} 个任务")
预期输出:
排队:
P0 订单索引(三副本) 1/3
P0 媒体条带(RS6+3) 6/9
P1 在线检索(RS6+3) 7/9
P1 归档对象(三副本) 2/3
人工处置:
历史损坏(RS6+3) 5/9
派发:
订单索引(三副本): 100 MiB/s
媒体条带(RS6+3): 100 MiB/s
预算: 200 MiB/s,2 个任务
真实系统应在每个修复分片完成后刷新可用份数、重新入队,并在恢复数据写盘且校验成功后才增加健康副本计数。程序打印的 100 MiB/s 是预算,不是实际限速证明。
用前台延迟反馈调整恢复速度
可将以下数值作为一次压测的初始策略,而非所有集群通用阈值:正常运行时前台写入 p99 约 25 ms;若连续 3 个一分钟窗口超过 50 ms,就把后台限速从 200 降到 100 MiB/s,并将并发从 2 降到 1;连续 5 个窗口低于 30 ms,再逐步恢复原配额,避免来回振荡。
验收时同时核对四项结果:前台 p99 未持续劣化;恢复实测跨网吞吐不超过 200 MiB/s;运行中的恢复任务不超过 2 个;P0 待修数量下降,且新副本落在独立故障域并通过校验。若 P0 数量反而增加,应优先排查新的磁盘故障、校验失败、目标容量不足或错误的任务重试,而不是直接解除限速。