
P2P 与分布式存储 / 系统课时
故障注入怎样检验 RPO 与 RTO
故障注入怎样检验 RPO 与 RTO
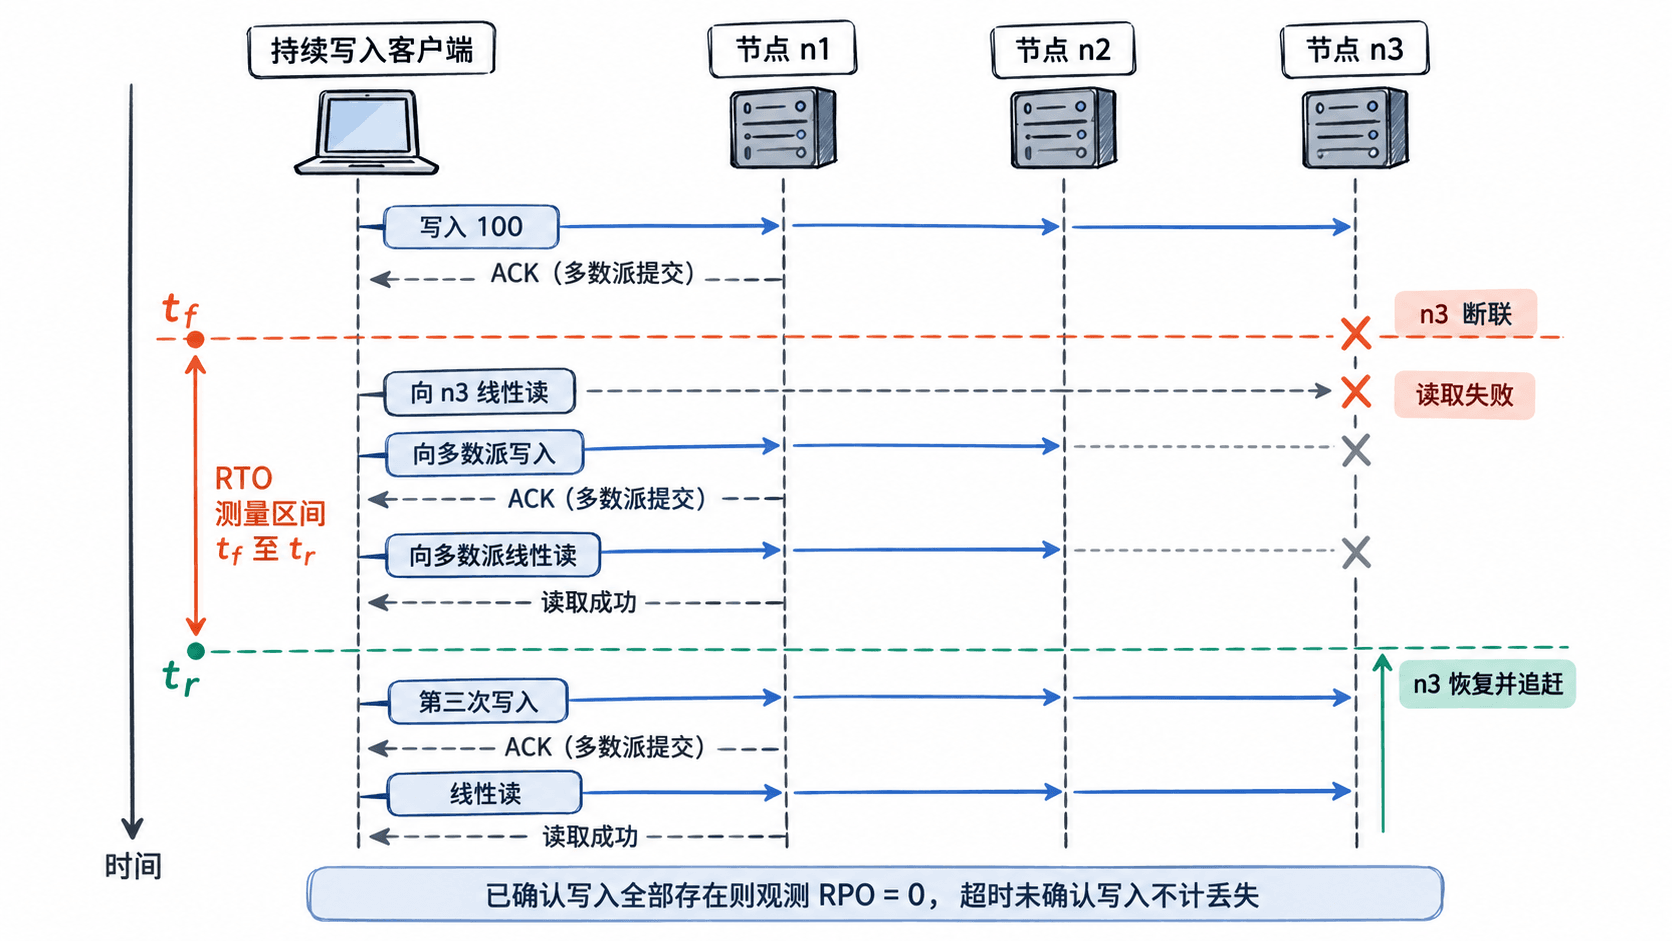
在三个 etcd 存储节点上连续写入编号数据,再注入节点宕机、网络隔离与离线数据损坏。记录客户端收到的写入确认、线性一致性读取和恢复时间,就能算出有多少已确认数据丢失,以及服务多久恢复到可持续读写。
学习目标
- 搭建可重复的三节点故障实验,区分多数派服务与单节点状态。
- 用写入确认日志核对 RPO,用连续读写探针测量 RTO。
- 对比三种故障的现象,并验证损坏节点修复后的数据一致性。
定义实验边界与通过条件
实验使用 Linux Bash、Docker Engine 和固定镜像 quay.io/coreos/etcd:v3.5.21。三个成员 n1、n2、n3 各有独立数据卷,使用 Raft 复制键值数据;三节点需要至少两票才能提交新写入。所有时间在同一宿主机采集,避免跨机器时钟误差。单机容器只模拟进程与网络故障,不代表跨机架容灾;明文 HTTP 也仅限隔离实验网络。
| 指标 | 本实验验收标准 | 证据 |
|---|---|---|
| RPO | 已收到成功确认的写入丢失 0 条 | ACK 序号与恢复后键值逐项核对 |
| 服务 RTO | 故障起至连续 3 次写入与线性读均成功,不超过 15 秒 | 故障时间及 READ_OK 时间戳 |
| 副本恢复 | 三节点重新健康且相同修订版本的 KV 哈希一致 | endpoint status 与 endpoint hashkv |
RPO 的 0 条是本实验对已确认写入的观察结果;超时但实际可能提交的写入另记为“结果未明”,不能直接记为丢失。若探针始终成功,只能报告“未观察到服务中断”,不能把单节点修复耗时冒充服务 RTO。
启动三节点并确认基线
以下命令在同一个 Bash 终端执行。镜像中的 etcdctl 作为独立客户端容器运行,避免要求宿主机额外安装 CLI。start_member 保留给后面的损坏修复使用;实验名称和数据卷必须是全新的。
# 私有实验网络及独立数据卷,避免触碰其他集群
docker network create rpo-lab
start_member() {
  local i="$1" state="${2:-new}"
  # 重建受损成员时将 state 从 new 改为 existing
  docker run -d --name "rpo-n$i" --network rpo-lab \
    -v "rpo-n$i:/etcd-data" quay.io/coreos/etcd:v3.5.21 \
    /usr/local/bin/etcd --name="n$i" --data-dir=/etcd-data \
    --listen-client-urls=http://0.0.0.0:2379 \
    --advertise-client-urls="http://rpo-n$i:2379" \
    --listen-peer-urls=http://0.0.0.0:2380 \
    --initial-advertise-peer-urls="http://rpo-n$i:2380" \
    --initial-cluster="n1=http://rpo-n1:2380,n2=http://rpo-n2:2380,n3=http://rpo-n3:2380" \
    --initial-cluster-token=rpo-lab-01 \
    --initial-cluster-state="$state" \
    --experimental-initial-corrupt-check
}
for i in 1 2 3; do
  docker volume create "rpo-n$i" >/dev/null
  start_member "$i" new
done
sleep 6
# 客户端单独运行,不依赖待注入故障的节点容器
ctl() {
  docker run --rm --network rpo-lab quay.io/coreos/etcd:v3.5.21 \
    /usr/local/bin/etcdctl --dial-timeout=2s --command-timeout=4s "$@"
}
ALL=http://rpo-n1:2379,http://rpo-n2:2379,http://rpo-n3:2379
TARGET=http://rpo-n2:2379
ctl --endpoints="$ALL" endpoint status -w table
ctl --endpoints="$TARGET" put /lab/boot ok
ctl --endpoints="$TARGET" get --print-value-only /lab/boot
预期结果:状态表出现三个成员,其中恰有一个领导者;最后两条命令依次输出 OK 和 ok。网络、容器及成员 ID 会随环境变化。若无领导者,先看 docker logs rpo-n1 等容器日志,检查三条 peer URL 与 initial-cluster 是否完全匹配。
持续记录确认写入和读取结果
客户端固定连接 n2,用于观察另一个节点 n3 故障时多数派是否仍可服务。写入键 /lab/item/序号,值为 v序号;每次成功写入单独记一条 ACK,随后进行线性一致性读取。写入失败时重试同一序号,避免把未知提交状态误作新业务写入。
printf 'epoch_ms,scenario\n' > faults.csv
(
  seq=1
  printf 'epoch_ms,seq,event\n'
  while :; do
    # 只有服务器返回成功才记 ACK;后续读取是独立检查
    if ctl --endpoints="$TARGET" put "/lab/item/$seq" "v$seq" >/dev/null 2>&1; then
      printf '%s,%s,ACK\n' "$(date +%s%3N)" "$seq"
      value=$(ctl --endpoints="$TARGET" get --consistency=l --print-value-only \
        "/lab/item/$seq" 2>/dev/null)
      if [ "$value" = "v$seq" ]; then
        printf '%s,%s,READ_OK\n' "$(date +%s%3N)" "$seq"
      else
        printf '%s,%s,READ_FAIL\n' "$(date +%s%3N)" "$seq"
      fi
      seq=$((seq + 1))
    else
      # 超时请求可能已提交:重试原键值,不直接计入 RPO
      printf '%s,%s,PUT_FAIL\n' "$(date +%s%3N)" "$seq"
    fi
    sleep 1
  done
) > probe.csv &
PROBE_PID=$!预期结果:probe.csv 包含 Unix 毫秒时间戳与成对的 ACK、READ_OK;故障期间也可能记录 PUT_FAIL、READ_FAIL。一次循环包含客户端容器启动开销,实际采样间隔须按日志计算,不能假定严格每秒一次。
依次注入宕机、隔离和损坏
每轮先确认三个成员健康,探针始终运行。先使用 docker kill 模拟 n3 进程突然退出,而不是用会优雅关闭的 docker stop。记录故障发生前的时间戳,保留八秒故障窗口,再启动该成员。
# 先记故障触发时间,得到保守的恢复时间上界
printf '%s,NODE_CRASH\n' "$(date +%s%3N)" >> faults.csv
docker kill --signal=KILL rpo-n3
sleep 8
docker start rpo-n3预期结果:n1 与 n2 仍具多数派;n3 重启后追赶数据。如果 n3 原本是领导者,探针可能短暂失败,待新领导者选出后恢复。用 ctl --endpoints="$ALL" endpoint health 确认三节点健康后再做下一轮。
接着仅断开 n3 的实验网络。多数派仍能读写,而孤立成员的线性读应在失去多数派后超时;不要用允许陈旧数据的 --consistency=s 读取冒充可用性。
# 隔离单节点,不同时切断另一票
printf '%s,NETWORK_ISOLATE\n' "$(date +%s%3N)" >> faults.csv
docker network disconnect -f rpo-lab rpo-n3
sleep 8
docker exec rpo-n3 /usr/local/bin/etcdctl \
  --endpoints=http://127.0.0.1:2379 --command-timeout=3s \
  get --consistency=l /lab/boot
docker network connect rpo-lab rpo-n3
预期结果:孤立成员的线性读报错或超时,而 TARGET 的持续探针可继续成功;第三条命令失败是预期故障现象,不代表实验失败。确认 n3 重新追赶后再继续。
最后只破坏已停止的 n3 数据卷。先保留故障前备份,再覆盖本地 bbolt 数据库的两个元数据页;此操作只能在可销毁的测试卷上执行,不能针对生产目录。
# 先停受害节点并保存原数据卷,禁止在线覆盖数据库
docker kill --signal=KILL rpo-n3
docker run --rm -v rpo-n3:/d -v "$PWD":/backup busybox:1.36 \
  tar czf /backup/n3-before-corruption.tar.gz -C /d .
# 覆盖 bbolt 双元数据页;这是破坏性实验,不是生产修复手段
printf '%s,DATA_CORRUPTION\n' "$(date +%s%3N)" >> faults.csv
docker run --rm -v rpo-n3:/d busybox:1.36 sh -c \
  'test -f /d/member/snap/db && dd if=/dev/zero of=/d/member/snap/db bs=4096 count=2 conv=notrunc 2>/dev/null'
docker start rpo-n3
docker logs --tail=25 rpo-n3预期结果:损坏成员可能启动失败或报告数据库错误;不可预设某一条固定日志,也不可把进程仍在运行当作数据正确。n1、n2 应保持多数派。此注入覆盖本地元数据损坏,不等于穷尽所有静默位翻转情形。
参考 etcd 3.5 的损坏成员恢复方式,停掉 n3、移走其 snap 目录,并以 existing 状态重新创建相同成员,让它从健康集群追赶;若无法恢复,应按官方流程移除并替换成员,不要同时清空另外两份数据。
# 保留 WAL 与成员身份,移走损坏快照后从健康集群追赶
docker rm -f rpo-n3
docker run --rm -v rpo-n3:/d busybox:1.36 sh -c \
  'mv /d/member/snap /d/member/snap.corrupt && mkdir -p /d/member/snap'
start_member 3 existing预期结果:n3 重新加入,最终三个端点均健康。若出现 CORRUPT 告警,先修复并核对数据,再按 etcd 数据损坏恢复说明 处理告警,不能直接清除告警当作修复。
从证据计算并复核 RPO 与 RTO
停止探针后,核对全部成功确认的写入,并在集群没有继续写入时比较修订版本与 KV 哈希。哈希必须在相同修订版本上比较;节点暂时落后时先等追赶,不应立即判为损坏。
# 先停止新写入,避免 KV 哈希比对受到修订版推进干扰
kill "$PROBE_PID"
wait "$PROBE_PID" 2>/dev/null || true
# 只核验客户端收到 ACK 的数据;超时不等于已确认写入
awk -F, '$3=="ACK"{print $2}' probe.csv | while read -r seq; do
  actual=$(ctl --endpoints="$TARGET" get --consistency=l --print-value-only \
    "/lab/item/$seq" 2>/dev/null)
  [ "$actual" = "v$seq" ] || printf 'MISSING_OR_BAD,%s\n' "$seq"
done
ctl --endpoints="$ALL" endpoint status -w table
ctl --endpoints="$ALL" endpoint hashkv -w table
预期结果:没有 MISSING_OR_BAD 行;三个成员恢复同一修订版本后,KV 哈希相等。若有缺失,先排除读取超时,再将确实丢失的 ACK 序号列为 RPO 违约;哈希不一致或成员不可达则不能宣布副本恢复通过。
按 faults.csv 的故障时间 t_f 找到 probe.csv 中故障后的首次连续三次 ACK 加 READ_OK,且中间没有失败事件,取第三次完成时刻 t_r,计算保守服务 RTO:(t_r - t_f) / 1000 秒。假设 t_f=100000ms、t_r=104200ms,则 RTO 为 4.2 秒;若故障前已确认序号 1~120 且恢复后全部可读,观测到的已确认写入丢失为 0,故 RPO 观测值为 0;若 118~120 丢失,故障前最后可恢复的已确认写入是 117,则还需用故障时刻减去 117 的确认时间,给出以秒表示的数据恢复点滞后量。此处数字只是计算示例,不是实测结果。
若全部探针始终成功,应报告“在本次采样粒度下未观测到服务中断”;如果单节点重建用了 30 秒,但多数派一直服务,30 秒是副本修复时间,不是服务 RTO。最终报告逐场景填写故障时刻、最后确认序号、失败请求、稳定恢复时刻、缺失序号及是否达到 0 丢失/15 秒目标。