
P2P 与分布式存储 / 系统课时
纠删码为什么放大小对象写入成本
纠删码为什么放大小对象写入成本
纠删码在完整条带上能显著节省存储空间,但碰到小对象和随机覆盖写时,分片请求、元数据维护与读改写会增加成本。用一个 4+2 编码算例,可以分别算清容量收益、写入放大,以及何时应该改用副本或聚合写入。
学习目标
- 算出 4+2 纠删码的满条带容量开销与小对象分片数量。
- 解释 4 KiB 覆盖写为什么可能触发整条带读改写。
- 用可运行脚本核对放大倍数,并制定冷热数据分层策略。
满条带的容量收益从哪里来
假设采用 Reed–Solomon 4+2:每个编码组有 4 个数据片和 2 个校验片,允许任意 2 个片丢失后重建。约定每片为 1 MiB,则一个完整条带承载 4 MiB 业务数据,占用 6 MiB 原始片空间,冗余系数为 。同样的 4 MiB 数据如果保存三副本,则需要 12 MiB,冗余系数为 3。
这里的 1.5 倍只是理想数据片容量开销,尚未计入对象索引、片定位记录、对齐填充与额外日志。编码计算和故障修复流量属于运行成本,需要另外衡量。实际空间开销应使用底层已分配字节数除以业务逻辑字节数来测量。
小对象为什么增加请求与元数据成本
假设 64 KiB 对象独立编码、支持变长分片且不与其他对象合并:4 个数据片各 16 KiB,2 个校验片也各 16 KiB,纯数据占用 96 KiB;三副本需要 192 KiB。虽然纠删码仍节省数据空间,一次写入却要放置 6 个片,而三副本只放置 3 份副本。
如果每个片都需要独立记录,那么连续写入 1024 个这样的对象,就会产生 6144 条片记录,而三副本对应 3072 份副本记录。实际元数据模型因产品而异,但更多的寻址、提交和故障修复工作不会被 1.5 倍公式体现。
随机覆盖写怎样变成读改写
现在把 4 MiB 数据组织为 4 个 1 MiB 数据片和 2 个 1 MiB 校验片。客户端只覆盖其中 4 KiB,旧校验值立即失效;仅把新字节写入一个数据片,不能保持条带可恢复。
一种容易实现但成本较高的全条带读改写路径是:
- 读取旧的 4 个数据片,合计 4 MiB。
- 在内存里替换目标位置的 4 KiB。
- 重新计算 2 个校验片。
- 将新版本的 6 个片全部写回,合计 6 MiB,并按系统的提交协议发布新版本。
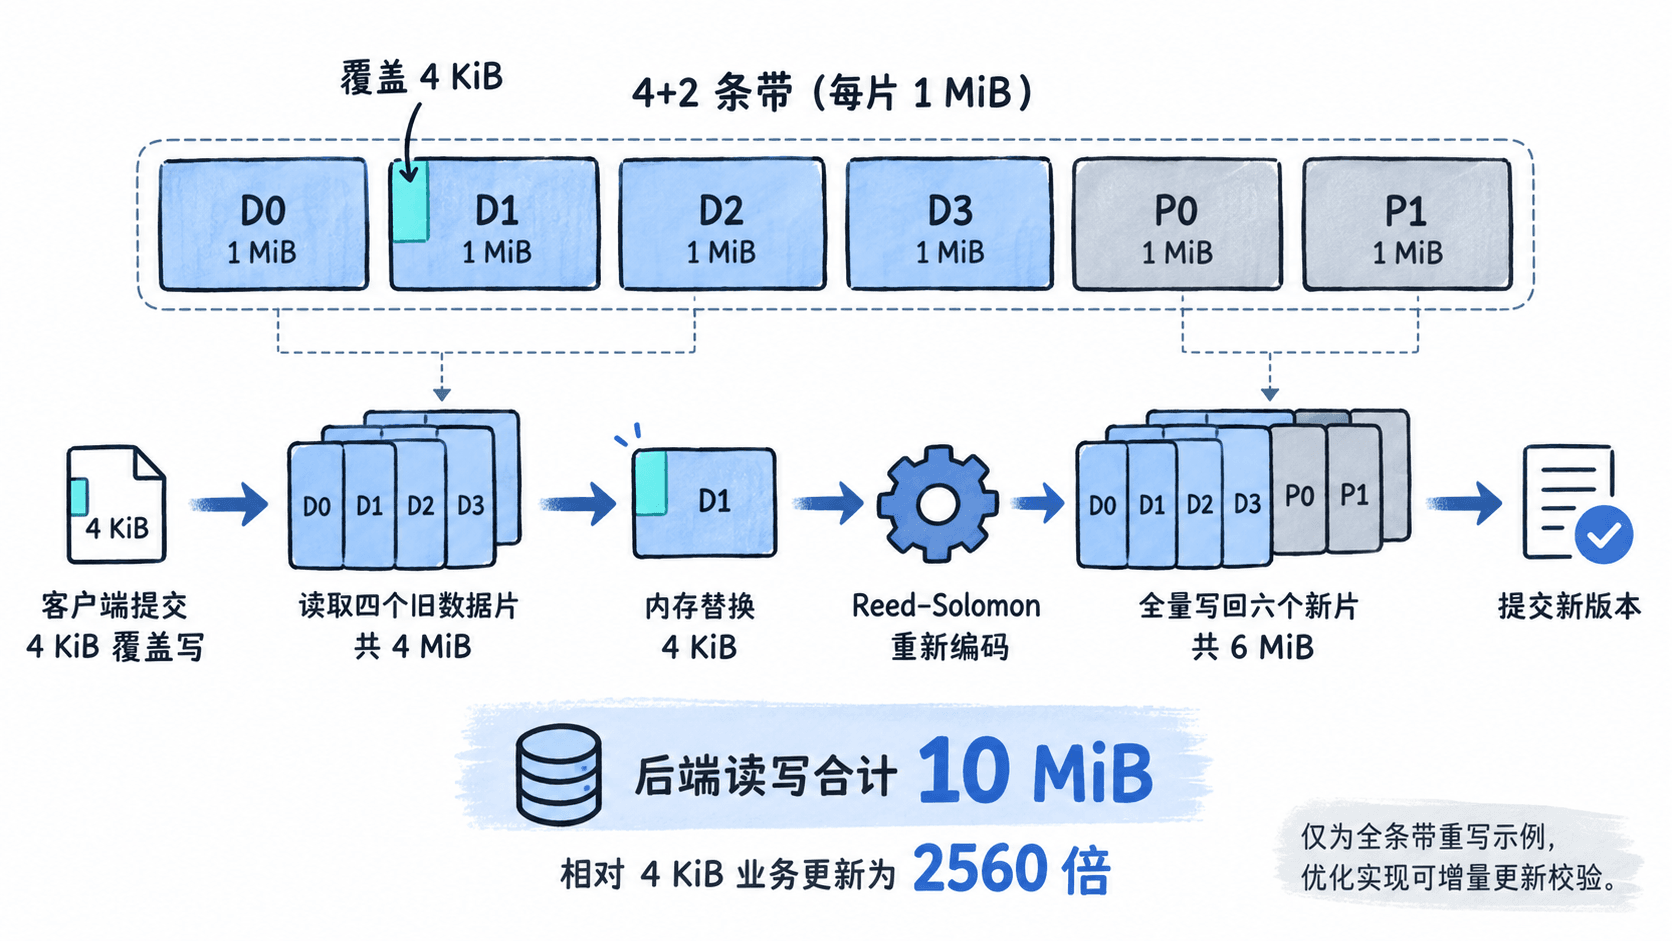
这个示例的后端读写总量为 10 MiB,相对于 4 KiB 业务更新放大 2560 倍;如果只统计写入字节,则为 1536 倍。它是全条带重写路径的算例,不是每个纠删码产品的固定放大倍数。
有的实现通过读取旧数据与旧校验片,计算差量并局部更新校验片,以减少 I/O;是否生效取决于块对齐、存储接口、缓存和原子提交机制。不能只依据编码比例推断随机写延迟。
用 Python 核对这两个算例
以下脚本可在 Python 3.8 及以上版本直接运行;小对象部分假设变长等长分片,覆盖写部分假设完整读取 4 片并重写全部 6 片。
k, m = 4, 2
chunk_kib = 1024
object_kib, patch_kib = 64, 4

# 小对象单独编码,不跨对象聚合,按数据片数向上取整
small_shard_kib = (object_kib + k - 1) // k
print(f"小对象: EC={small_shard_kib * (k + m)} KiB, 三副本={object_kib * 3} KiB")

# 采用全条带读取、六片全量重写的保守路径
read_kib = k * chunk_kib
write_kib = (k + m) * chunk_kib
print(f"覆盖 {patch_kib} KiB: 读={read_kib} KiB, 写={write_kib} KiB")
print(f"总I/O字节放大={(read_kib + write_kib) // patch_kib} 倍")
预期输出:
小对象: EC=96 KiB, 三副本=192 KiB
覆盖 4 KiB: 读=4096 KiB, 写=6144 KiB
总I/O字节放大=2560 倍
上述数字只表示模型中的数据量,不含 RPC 固定开销、校验计算时间、真实磁盘写入合并或持久化日志,因此不能直接换算成写入耗时。
怎样决定哪些对象使用纠删码
对这个 4 MiB 满条带配置,可先把大、冷、写后基本不改的对象交给 4+2 纠删码;把频繁覆盖的 64 KiB 热对象保留在三副本或追加日志中。待多个小对象聚合到约 4 MiB,或将日志压实为不可变数据后,再批量编码。跨对象聚合要同时保存对象到条带偏移的索引,并考虑删除和单对象读取成本。
验收时设计两组相同环境的负载:先写入 10000 个 64 KiB 对象,再对 4 MiB 对象执行 10000 次随机 4 KiB 覆盖。分别在三副本与 4+2 下记录写入 p95 延迟、后端读写总字节数、片级请求数、编码 CPU 占用、元数据条数和实际已分配空间。若业务要求写入 p95 不超过 50 ms,就以这个指标和实测总成本选择方案,而不是只看 1.5 倍的理想容量系数。