
P2P 与分布式存储 / 系统课时
范围分片如何引发顺序写入热点
范围分片如何引发顺序写入热点
使用连续增长的对象键模拟写入请求,观察为什么三个分片中只有末端分片持续繁忙。通过 Python 实验比较分片切分前后的流量分布,再使用哈希路由进行对照,理解范围边界、访问模式和写入热点之间的关系。
学习目标
- 根据范围边界判断对象键所属的分片,解释递增键造成写入热点的原因。
- 运行三分片写入实验,观察在线切分后热点为什么可能继续移动。
- 根据顺序写入与范围查询需求,选择范围分片、哈希分片或混合方案。
连续增长的键为什么集中到末端分片
范围分片(Range Partitioning)将有序键空间划分为多个连续区间。每个区间由一个分片负责,路由器比较对象键与分片边界,选择对应分片。
假设对象键采用固定六位数字编号,例如 obj-000200,三个分片分别部署在不同存储节点上,采用左闭右开的范围边界:
| 分片 | 对象键范围 | 本次新增写入数 |
|---|---|---|
| S1 | [obj-000000, obj-000100) |
0 |
| S2 | [obj-000100, obj-000200) |
0 |
| S3 | [obj-000200, +∞) |
120 |
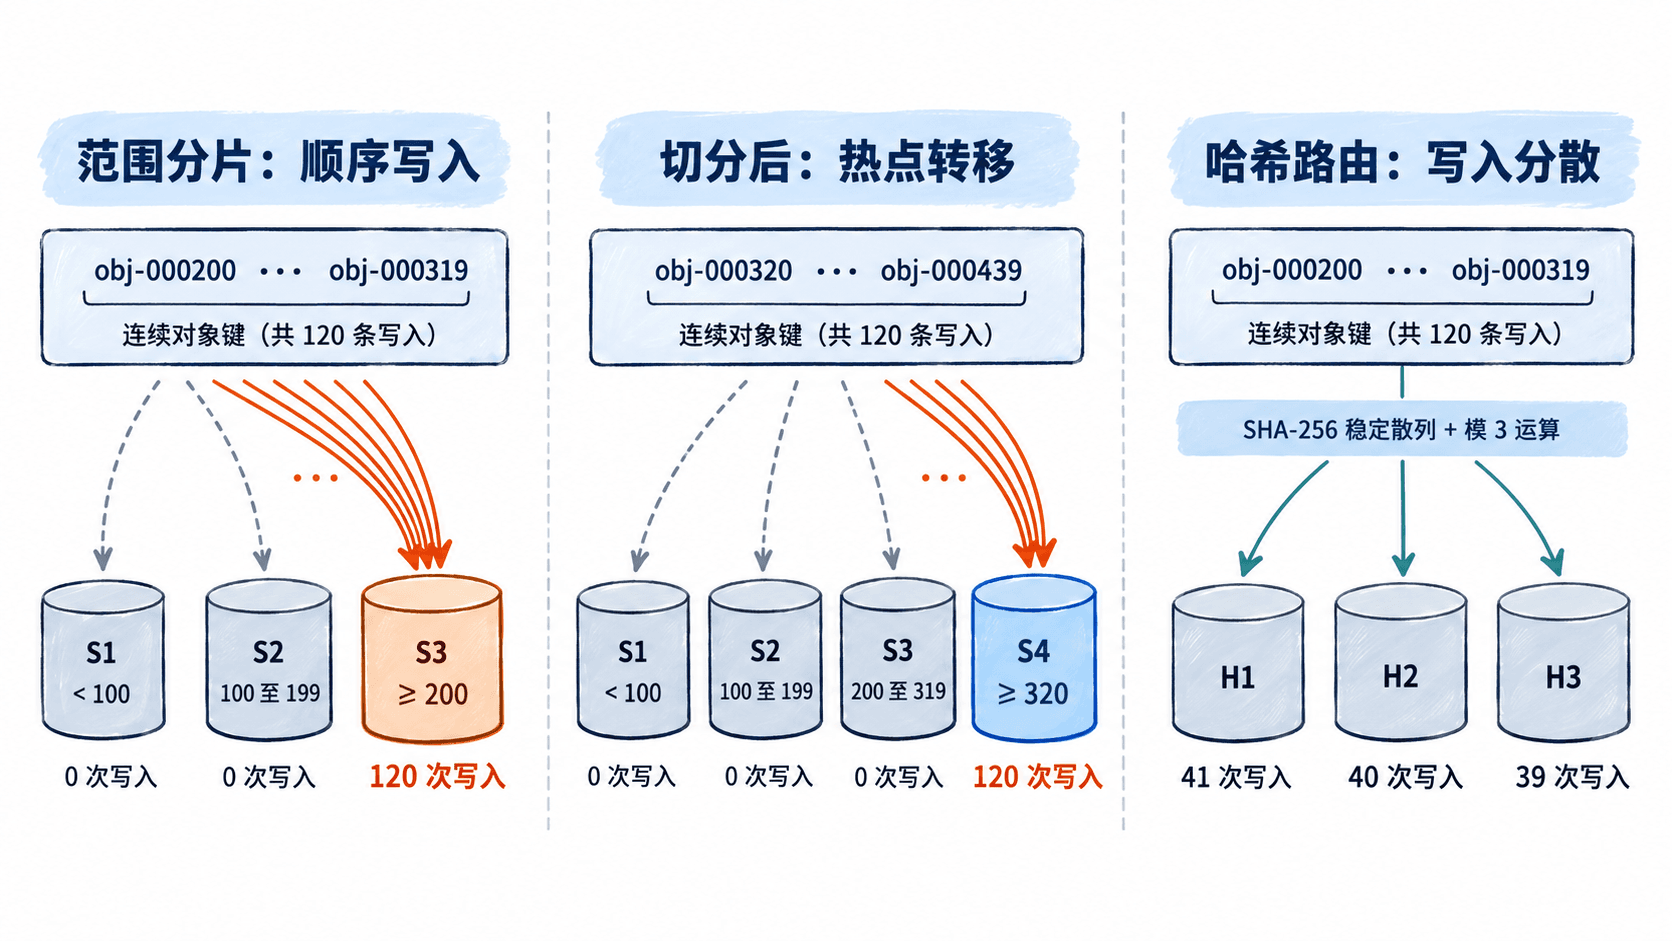
客户端连续写入 obj-000200 至 obj-000319,总计 120 个不同对象。由于所有对象键均大于或等于 S3 的起始边界,它们全部被路由到 S3。
S1、S2 可能存放大量历史对象,但这些历史数据不会自动帮助 S3 分担当前新增写入。若每个分片分别由一台机器处理,S3 的磁盘写入、CPU、写入队列和响应延迟就可能率先达到瓶颈。
这里需要区分两个概念:数据分布均匀不代表请求分布均匀。即使三个分片存储的数据量接近,短时间内的新增请求仍可能集中到同一个分片。
用 Python 观察分片请求分布
下面用 Python 3.9 或更新版本的标准库构建最小路由模拟器。对象键的数字部分作为范围比较依据,哈希方案则对完整对象键计算稳定散列值。
实验分为三个观察场景:切分前写入编号 200~319;将 S3 在编号 320 处切分后写入编号 320~439;最后对第一批对象键执行三桶哈希路由。每个场景均有 120 次写入。
将代码保存为 hotspot.py,执行 python hotspot.py:
from collections import Counter
import hashlib


def route_range(object_id: int, split: bool = False) -> str:
    if object_id < 100:
        return "S1"
    if object_id < 200:
        return "S2"
    # 在320处切分,历史键留在S3,后续新键进入S4
    if split and object_id >= 320:
        return "S4"
    return "S3"


def route_hash(object_id: int) -> str:
    key = f"obj-{object_id:06d}".encode("ascii")
    digest = hashlib.sha256(key).digest()
    # 使用稳定散列,避免Python内置hash()的随机化影响
    return f"H{int.from_bytes(digest[:8], 'big') % 3 + 1}"


def show(title: str, ids: range, route, shard_names: list[str]) -> None:
    count = Counter(route(i) for i in ids)
    print(title + ":" + ",".join(f"{s}={count[s]}" for s in shard_names))


if __name__ == "__main__":
    show("切分前", range(200, 320), route_range, ["S1", "S2", "S3"])
    show("切分后", range(320, 440), lambda i: route_range(i, True), ["S1", "S2", "S3", "S4"])
    show("哈希路由", range(200, 320), route_hash, ["H1", "H2", "H3"])
预期输出:
切分前:S1=0,S2=0,S3=120
切分后:S1=0,S2=0,S3=0,S4=120
哈希路由:H1=41,H2=40,H3=39
第一行证明当前写入集中于 S3。第二行说明切分之后,新的递增对象键继续集中到新分片 S4。第三行则表明,将对象键映射为稳定哈希值后,同一批写入可以分散到三个哈希桶。
哈希实验中的 41、40、39 是这批固定输入与当前算法得到的确定结果,不代表任意 120 个键都恰好均匀分布。实际部署还需要将哈希桶分配到具备独立处理能力的物理节点。
为什么切分范围不一定能消除热点
假设 S3 原来负责 [obj-000200, +∞)。在编号 320 处切分后,两个分片的边界变为:
| 分片 | 切分后负责的范围 | 下一批120次写入 |
|---|---|---|
| S3 | [obj-000200, obj-000320) |
0 |
| S4 | [obj-000320, +∞) |
120 |
切分操作可以重新分配已有数据和存储负担,却无法改变新键持续增长的访问模式。所有未来编号大于或等于 320 的写入仍然落入最后一个开放区间。
可以用一个容量算例判断后果:假设每个分片独立处理写入的稳定能力为每秒 60 次,业务入口每秒产生 120 次连续编号写入。若没有限流、丢弃或其他背压机制,热点分片理论上每秒增加约 60 个待处理请求,10 秒就可能积压约 600 个。
分片切分后,原本集中在 S3 的新增负担只是移动到了 S4。这个现象通常称为移动热点(Moving Hotspot)。
诊断此类热点时,至少记录每个分片最近 60 秒的写入 QPS、待处理队列长度、写入延迟 p95 和磁盘使用情况。若只有末端分片的 QPS 与延迟持续增长,而其他分片保持空闲,优先检查键生成规则与范围边界,而不是直接增加副本数量。
什么时候保留范围分片,什么时候改变路由
范围分片的优势是保持键的顺序,使区间扫描容易定位到相关分片。例如查询 obj-000120 至 obj-000180,只需要访问负责该区间的 S2,而不必扫描所有哈希桶。
不同策略解决的问题并不相同:
| 路由策略 | 递增键写入 | 连续范围查询 |
|---|---|---|
| 纯范围分片 | 容易集中到末端 | 可定位相交区间,效率较高 |
| 纯哈希分片 | 多个不同键通常分散 | 通常需要跨桶查询与合并 |
| 哈希前缀加局部范围 | 可将不同键分散到多个桶 | 每桶内有序,跨桶查询需要归并 |
如果对象存储主要按对象 ID 执行单点 PUT、GET,而没有按 ID 连续扫描的要求,使用稳定哈希进行分片通常更容易分散递增键写入。
如果业务必须按时间范围查询,例如查询某天的全部事件,可以考虑按 tenantId 划分较高层的分片,再在租户内部按时间排序。但这种方式只有在多个租户同时活跃时才能有效分散写入,单个超高流量租户仍可能形成热点。
对于单租户的大量递增事件,可以为对象键加入由对象 ID 散列计算的 8 桶前缀,将写入分布到 8 个独立范围。代价是原来一次范围查询可能需要访问 8 个桶,再按时间顺序归并结果,同时维护各桶的分页位置。
还要注意,不同键的顺序写入热点与单个键的访问热点不是同一个问题。哈希路由可以分散大量不同对象键,但如果大量请求全部访问同一个对象键,它们仍会被路由到同一个哈希位置,需要通过缓存、请求合并或业务层拆分另行处理。
最终应使用实际峰值时间窗口验证路由效果:比较各分片的写入 QPS、队列增长和 p95 延迟,确认热点负载确实得到分散。如果只看到历史数据容量变得均匀,而最新写入仍集中到末端分片,就不能把此次切分视为写入热点已经解决。