
P2P 与分布式存储 / 系统课时
重建纠删码分片会消耗哪些资源
重建纠删码分片会消耗哪些资源
一块纠删码分片损坏后,系统通常要从多台健康节点读取其他分片,再计算出缺失内容,而不是直接复制现成副本。本课以 RS(6,3) 为例,逐项核算磁盘 I/O、跨节点网络和计算开销,并估算修复吞吐的瓶颈。
学习目标
- 计算单片重建的读盘量、网络传输量、写盘量及读取放大倍数。
- 根据各阶段吞吐量估算理想修复耗时,找出最慢环节。
- 用相同业务数据比较不同编码参数的空间成本和修复压力。
一个缺失分片怎样重建
以常规 Reed–Solomon 纠删码为例,RS(6,3) 把一个条带划为 6 个数据片和 3 个校验片。只要还保留任意 6 个有效编码片,就可以恢复原始数据。每片为 64 MiB 时,业务数据为 6 × 64 = 384 MiB,实际存储为 9 × 64 = 576 MiB,空间放大为 1.5 倍。
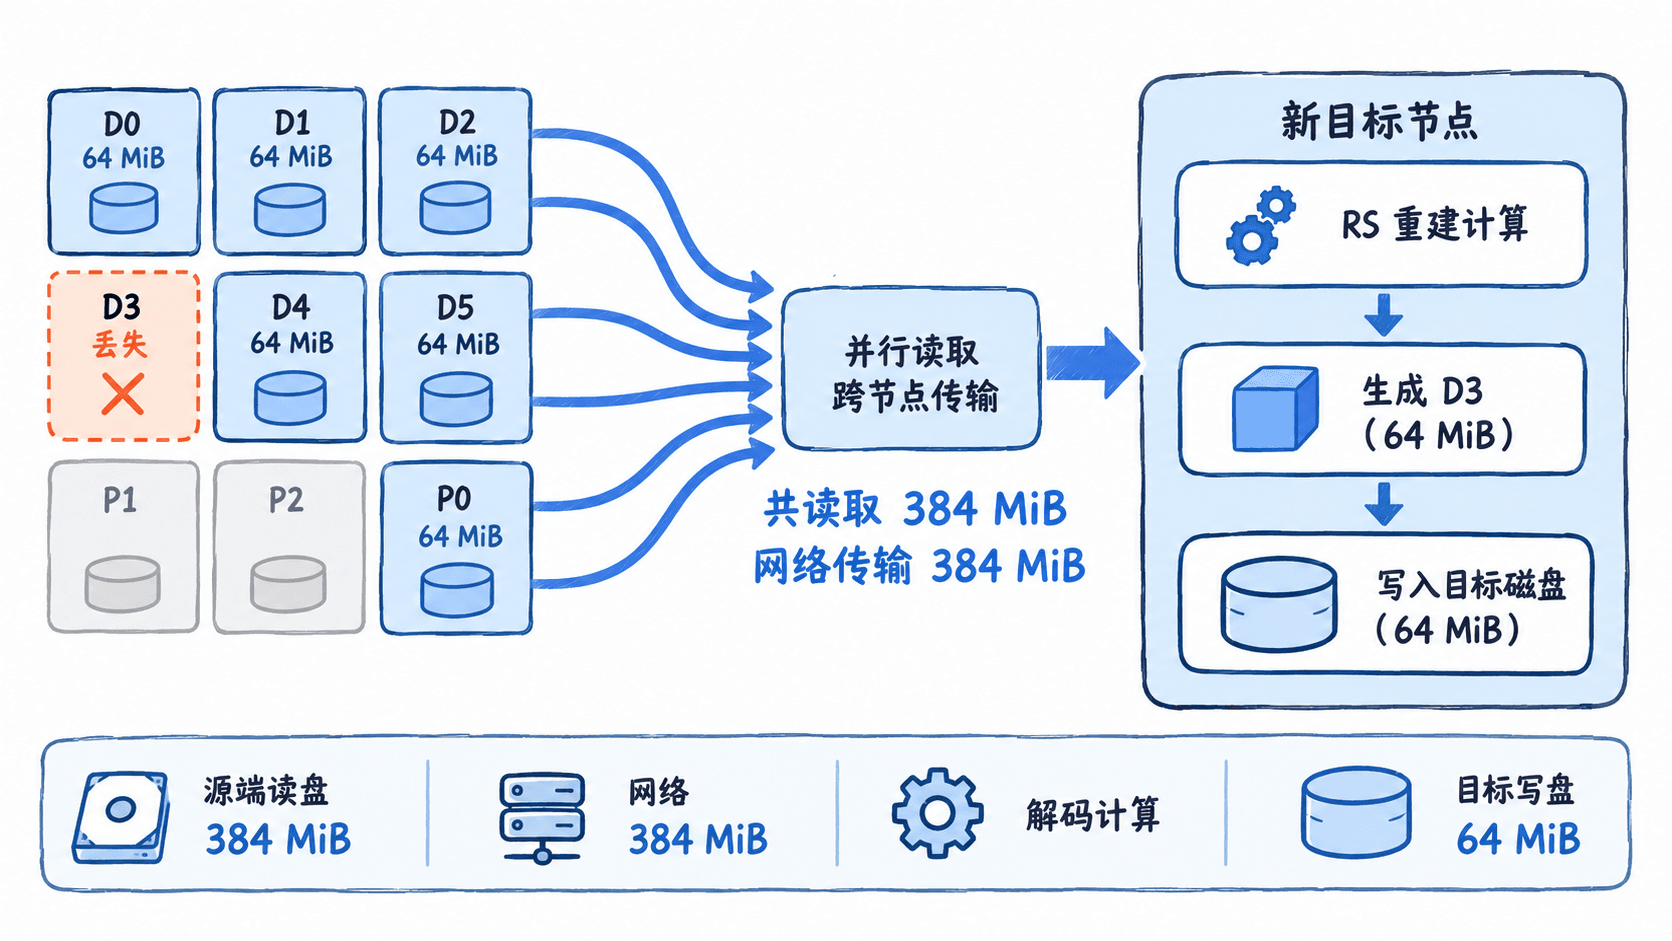
假设 9 片分别放在不同节点,数据片 D3 所在节点故障。修复协调器从剩余 8 片中选择 6 片,例如 D0、D1、D2、D4、D5、P0;各源节点读出 64 MiB,传给新目标节点。目标节点通过有限域编码运算重建 D3,只写回缺失的 64 MiB,随后更新分片位置记录。这里无需把全部 9 片重新写一遍。
将一次修复换算为资源量
对读取完整幸存片的常规 RS 重建,设数据片数量为 ,每片大小为 ,单片修复通常读取 ,写入 。如果修复目标没有该条带的本地幸存片,且所选源节点都在远端,网络接收量也约为 。
| 资源 | RS(6,3),每片 64 MiB | 负载位置 |
|---|---|---|
| 源节点读盘 | 6 × 64 = 384 MiB | 6 个源节点各读 64 MiB |
| 网络传输 | 384 MiB | 源端发送、目标端接收 |
| 重建计算 | 处理 6 片输入,生成 1 片 | 目标节点 CPU 与内存 |
| 目标节点写盘 | 64 MiB | 新节点本地磁盘 |
| 合计物理磁盘 I/O | 448 MiB | 读盘与写盘相加 |
因此,这次修复的源端读取放大为 6 倍:每恢复 1 MiB 丢失内容,需要读取 6 MiB 健康分片。表中的网络量不含协议开销、重传和跨机架额外链路占用;448 MiB 也未包含元数据日志、校验和及可能的临时落盘。重建运算量取决于编码实现,不能简单等同于一次 64 MiB 的内存复制。
用吞吐约束估算修复时间
假设 6 个源节点可以同时读取,各有 80 MiB/s 可用读吞吐;共享修复网络入口为 120 MiB/s;目标节点实测重建输出速率为 40 MiB/s,持续写入速率为 100 MiB/s。下面的 Python 3 脚本只计算资源预算,不执行纠删码解码。
# 六个源节点并行读取;所有所选分片都经网络送到新节点。
k, m, shard_mib = 6, 3, 64
donor_read_mibps = 80
repair_link_mibps = 120
decode_output_mibps = 40
target_write_mibps = 100

read_mib = k * shard_mib
network_mib = read_mib
write_mib = shard_mib

# 理想流水线中,各阶段耗时的最大值构成总耗时下界。
stage_seconds = {
    "源端读盘": shard_mib / donor_read_mibps,
    "网络接收": network_mib / repair_link_mibps,
    "重建计算": write_mib / decode_output_mibps,
    "目标写盘": write_mib / target_write_mibps,
}
bottleneck = max(stage_seconds, key=stage_seconds.get)
print(f"RS({k},{m}) 读盘={read_mib}MiB 网络={network_mib}MiB 写盘={write_mib}MiB")
print(f"理想下界={stage_seconds[bottleneck]:.2f}s 瓶颈={bottleneck}")
预期输出:
RS(6,3) 读盘=384MiB 网络=384MiB 写盘=64MiB
理想下界=3.20s 瓶颈=网络接收
读盘阶段理想耗时 0.8 秒,重建计算为 1.6 秒,写盘为 0.64 秒,网络阶段为 3.2 秒。只有分块读取、计算与写入充分重叠时,总耗时才可能接近 3.2 秒;排队、磁盘寻道、拥塞和校验会拉长实际时间。不要把这个下界当作生产环境修复时延承诺。
编码参数改变了哪些压力
为避免比较时数据量不同,固定每个条带承载 600 MiB 业务数据,并采用同样的整片读取修复算法:
| 指标 | RS(6,3) | RS(10,4) |
|---|---|---|
| 单片大小 | 100 MiB | 60 MiB |
| 总存储量 | 900 MiB | 840 MiB |
| 存储放大 | 1.50 倍 | 1.40 倍 |
| 单片修复读取量 | 600 MiB | 600 MiB |
| 单片修复写入量 | 100 MiB | 60 MiB |
| 读取量 / 恢复量 | 6 倍 | 10 倍 |
| 可容忍的缺失片数 | 3 | 4 |
在业务条带大小固定时,两个方案读取的总字节数恰好相同,但 RS(10,4) 需要联系 10 个源片,扇出更多;单片写入较少、每恢复 1 MiB 的读放大却更高。若固定的是单片大小而不是原始数据量,增加 会使一次修复的总读取量随之上升。增加校验片数 能提高可容忍的分片丢失数,但需要额外存储;具体重建 CPU 开销仍应实测。
故障期间怎样限制修复对业务的冲击
如果一次节点故障损失了合计 1 TiB 的编码片,且每个条带都只丢失一片,按 RS(6,3) 的上述算法,约需从健康节点读取 6 TiB、传输 6 TiB、写入 1 TiB。若所有任务只能共享 120 MiB/s 的修复入口,仅网络传输的理论下界就约为 14.6 小时,而不是按丢失的 1 TiB 来估算。
实际修复可按以下顺序验收:
- 在故障注入前记录健康节点读盘余量、跨机架出口流量、修复节点 CPU、前台读请求 p99 时延。
- 先用 2 个并发修复条带和 60 MiB/s 的全局修复网络限额试跑;这些数值是实验起点,不是存储产品的通用配置项。此时单个 384 MiB 输入的网络下界为 6.4 秒。
- 逐步增加并发,核对总体修复完成量是否提高;若网络始终打满而前台 p99 明显恶化,应降低修复限额,不能只靠增加工作线程。
- 对修复片执行校验和核对,并确认新片已经写入独立故障域、分片位置记录已持久化,才将任务标为完成。
判断修复策略时,应同时看修复完成速率、源节点读盘、共享网络利用率和前台延迟;只看“每秒修复多少 MiB”会漏掉健康节点为重建付出的数倍读取成本。