
操作系统 / 系统课时
理解上下文切换保存了什么
理解上下文切换保存了什么
上下文切换不是把“整个进程”复制一遍,而是让 CPU 暂停任务 A,并保存足够的信息,使它稍后能从原位置继续,再恢复任务 B 的执行现场。本篇拆开寄存器、内核栈、地址空间和调度状态,并说明频繁切换的直接与间接成本。
学习目标
- 说清一次任务切换必须保存和恢复的核心执行现场。
- 区分线程切换与跨进程切换在地址空间处理上的差异。
- 能用 Linux 计数器观察上下文切换,并正确判断“切换多”是否真的构成性能问题。
切换的核心是恢复可继续执行的现场
CPU 执行任务 A 时,程序计数器、栈指针和通用寄存器共同决定“下一条指令是什么、当前函数调用到哪里、局部计算进行到哪一步”。发生调度时,内核必须把这些关键执行状态保存到与任务相关的内核数据结构中,再装入任务 B 对应的状态。
任务在内核态执行时还依赖自己的内核栈。调度器同时维护任务的运行队列位置、优先级、调度实体统计等信息,用来决定谁下一次获得 CPU。它们并非全部在切换瞬间逐字复制,但共同构成“能够正确暂停并继续”的调度上下文。
一次切换保存与恢复什么
| 类别 | 切换时发生什么 | 容易误解的点 |
|---|---|---|
| CPU 寄存器 | 保存 A 的关键寄存器,恢复 B 的寄存器 | 这是恢复指令执行位置的核心 |
| 内核栈 | 切到 B 对应的内核栈上下文 | 不是复制整块栈内存 |
| 地址空间 | 跨进程时可能切换页表上下文;同进程线程通常共享地址空间 | 线程切换不等于完整进程切换 |
| 调度状态 | 更新运行队列、时间统计和任务状态 | 这些状态决定后续调度行为 |
| 缓存与 TLB | 不按“保存文件”方式复制,可能失去命中或需要刷新、重标记 | 代价常来自微体系结构副作用 |
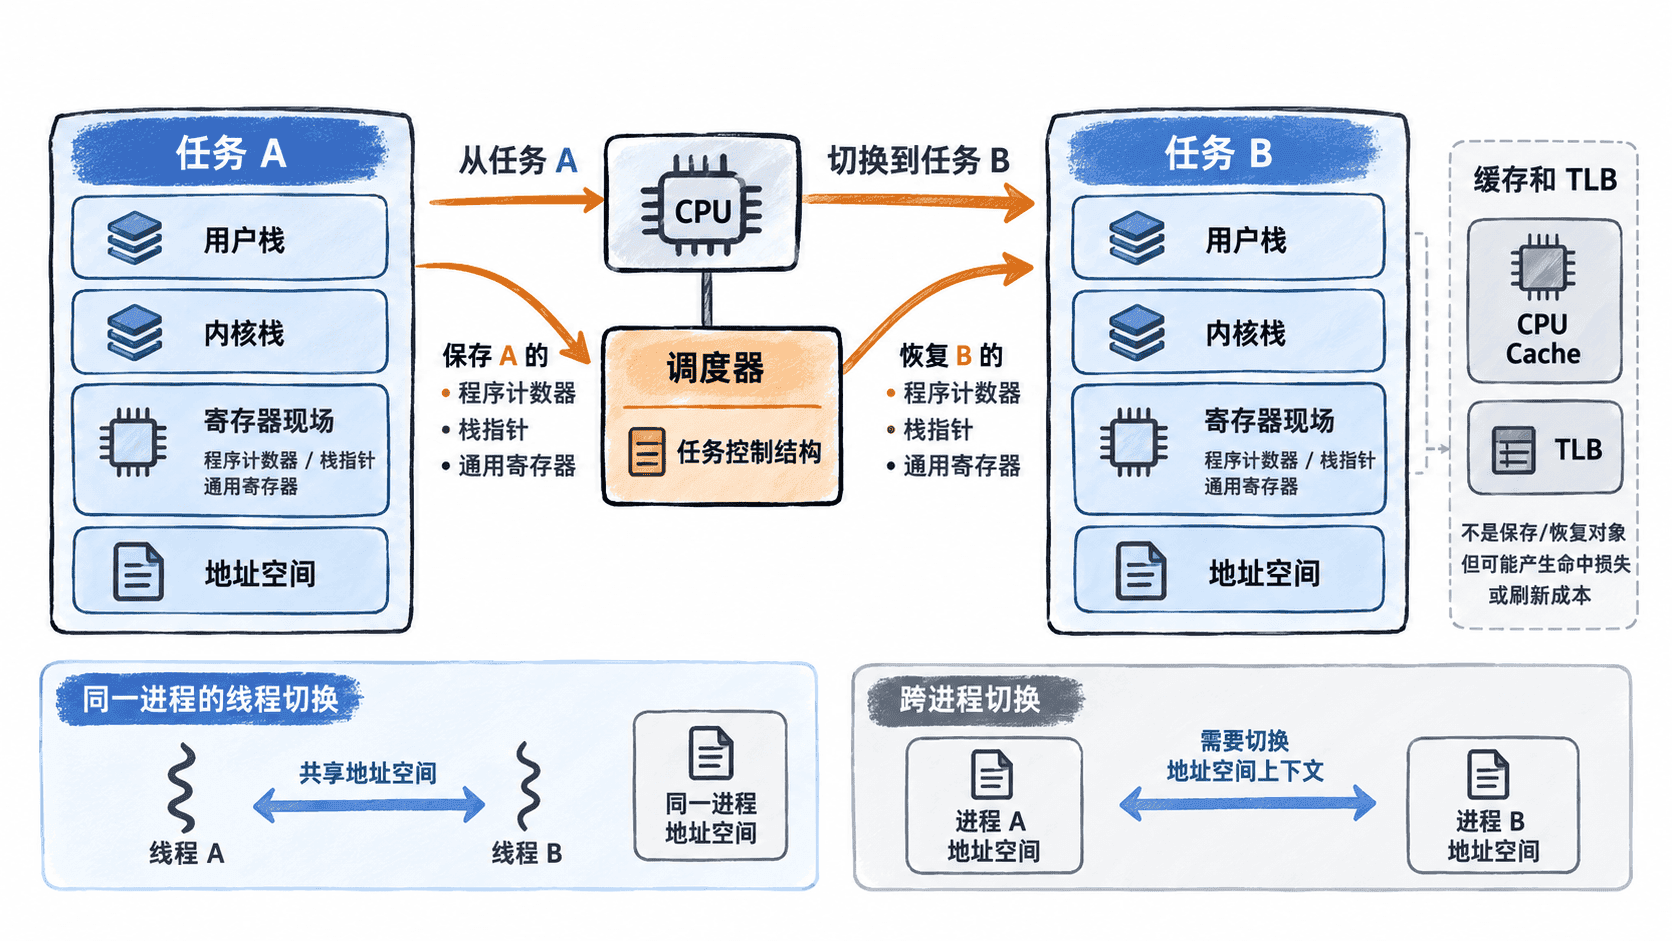
现代处理器还包含浮点、向量等扩展寄存器,操作系统会按体系结构规定管理这些执行状态。具体保存策略会随 CPU 和内核版本变化,但判断原则不变:只要某段硬件状态会影响任务恢复后的正确执行,就必须由内核保证其一致性。
用系统计数器观察切换
Linux 的 /proc/stat 中有累计的 ctxt 计数。下面读取两次并计算约一秒内发生的上下文切换次数,不依赖额外性能工具。
A=$(awk '/^ctxt / {print $2}' /proc/stat)
sleep 1
B=$(awk '/^ctxt / {print $2}' /proc/stat)
echo "context_switches_in_1s=$((B-A))"
预期输出,计数会随机器负载变化:
context_switches_in_1s=<COUNT>这是全系统计数,只能告诉你“切换发生得多不多”,不能直接指出哪个线程造成了切换。进一步分析线程时,可以查看 /proc/<PID>/task/<TID>/status 中的 voluntary_ctxt_switches 与 nonvoluntary_ctxt_switches:前者多见于主动阻塞等待,后者更多来自时间片用尽、抢占或 CPU 竞争。
为什么频繁切换会有额外成本
直接成本包括进入调度路径、保存与恢复寄存器、更新调度数据以及可能的地址空间切换。单次开销通常很小,但当线程数量和切换频率持续上升时,这些固定成本会累积。
更隐蔽的是间接成本。任务 B 接管 CPU 后,A 留在缓存中的工作集可能不再有用;跨地址空间执行还可能降低 TLB 命中率。现代 CPU 可用 ASID、PCID 等机制减少部分刷新,但无法保证不同任务的工作集都保持热状态,因此切换过密可能把时间消耗在“重新变热”而不是业务计算上。
判断切换是否值得优化
先把切换类型和业务现象对应起来。voluntary switch 高而 CPU 不满,通常说明线程频繁阻塞在 I/O、条件变量或锁等待;nonvoluntary switch 高且运行队列持续增长,更像 CPU 竞争或调度抢占。若吞吐和延迟都正常,仅凭切换计数高就减少线程,反而可能破坏并发能力。
真正值得优化的是“无效切换”:例如过多工作线程争抢少量 CPU、细粒度锁让线程反复睡眠与唤醒、任务切得太碎导致缓存工作集持续失效。把计数与 CPU 利用率、运行队列、锁等待和延迟一起看,才能判断上下文切换是正常并发行为,还是性能瓶颈的证据。