
操作系统 / 系统课时
理解日志文件系统的崩溃一致性
理解日志文件系统的崩溃一致性
日志文件系统解决的核心问题不是“永不丢数据”,而是避免一次更新做到一半时把文件系统结构留在自相矛盾的状态。本篇用事务记录、提交标记、检查点和崩溃恢复串起完整过程,并分析断电落在不同阶段时系统会看到什么。
学习目标
- 解释日志事务从记录、提交到检查点的基本生命周期
- 判断崩溃发生在提交前、提交后和检查点后的恢复结果
- 区分元数据日志、ordered 模式与数据日志对文件内容的不同保证
日志保护的是更新过程
一次文件操作往往会同时修改多个持久化结构,例如 inode、目录项、空闲块位图和数据块。如果直接原地覆盖,断电可能发生在任意两次写之间,于是出现“目录说文件存在,但 inode 或块分配状态还没跟上”的不一致。
日志文件系统把需要原子保护的一组更新组织成事务。典型流程是先把将要生效的更新写入日志区域,再写入提交记录;提交成功后,这个事务才被视为可恢复。之后系统再把已提交内容写回它们在文件系统中的正式位置,这一步通常称为 checkpoint。
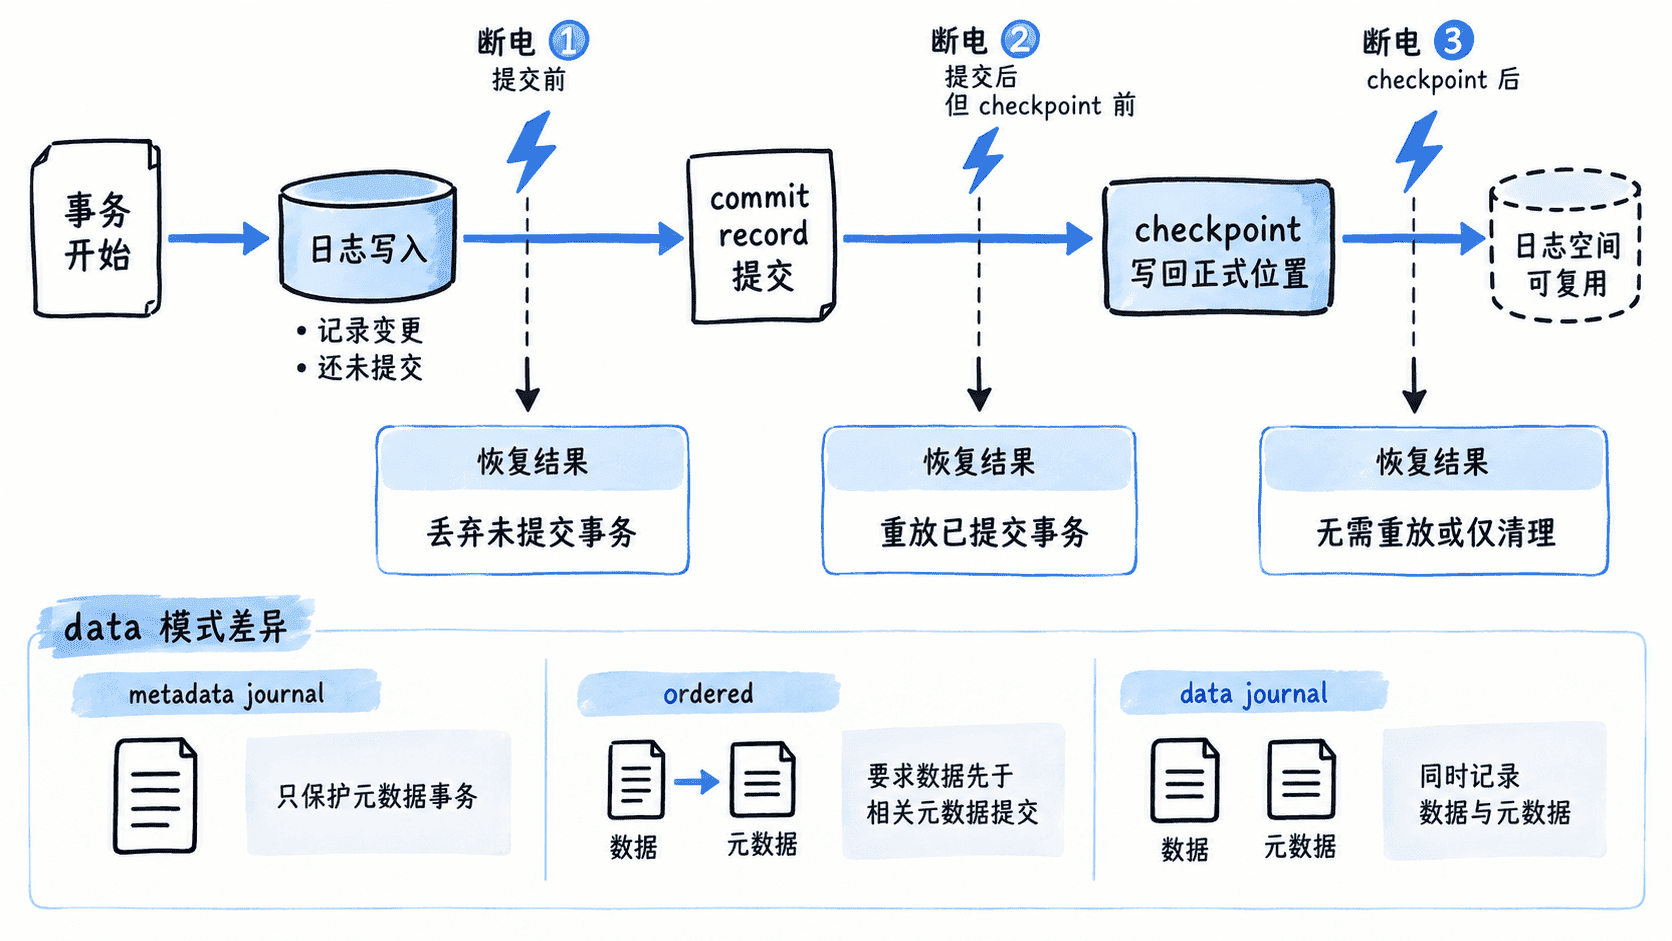
日志不是备份副本。它更像一段短期的、可判定“这组修改是否完整提交”的恢复证据;事务安全落到正式位置后,对应日志空间就可以循环复用。
三个崩溃点决定恢复动作
如果断电发生在提交记录落盘之前,恢复程序看不到完整提交证据,通常会丢弃这笔未提交事务,继续使用旧的一致状态。这样可能损失最近操作,但不会把一半元数据更新硬拼进文件系统。
如果断电发生在提交已经持久化、但 checkpoint 尚未完成时,日志里存在完整事务。挂载或恢复阶段会重放这笔已提交更新,把正式位置补齐到新状态。因此“提交完成”是崩溃恢复中的关键分界线。
如果 checkpoint 已完成,正式位置已经包含新状态,日志只等待回收或覆盖。此时即使再次崩溃,恢复也不需要依赖旧事务来重建这些修改。
用 ext4 镜像确认日志特性
在 Linux 且安装 e2fsprogs 的环境中,可以创建一个临时 ext4 镜像并检查文件系统特性。该操作只写普通镜像文件,不需要挂载文件系统。
img=/tmp/anystack-ext4-journal.img
truncate -s 64M "$img"
mkfs.ext4 -F "$img" >/dev/null 2>&1

if dumpe2fs -h "$img" 2>/dev/null | grep -q 'has_journal'; then
  echo "journal=enabled"
else
  echo "journal=disabled"
fi

rm -f "$img"
预期输出:
journal=enabled这个结果只确认该 ext4 文件系统包含日志能力,不代表“所有文件数据都写入日志”。真正的数据保护范围还取决于文件系统与挂载模式。
元数据一致不等于文件内容最新
日志文件系统最常见的目标是优先保护元数据一致性。以 ext4 的常见 ordered 语义为例,文件数据块本身通常不写进日志,但相关数据会先于使其可见的元数据提交,从而降低“元数据已经指向新块,而新块内容尚未写出”的风险。
数据日志模式则可以把数据和元数据都纳入日志事务,恢复语义更强,但写放大和提交成本也更高。反过来,只做元数据日志时,崩溃后的目录和 inode 可能完全一致,某个最近写入文件的内容却仍可能是旧值或缺少最后一部分数据。
判断崩溃后会看到什么
分析崩溃一致性时,不要只问“写成功了吗”,而要依次确认:哪些数据已进入日志,提交记录是否已持久化,正式位置是否已 checkpoint,以及文件数据是否属于该日志模式的保护范围。只要这四件事明确,断电后的可见状态通常就能推导出来。
日志文件系统的价值在于把“任意时刻断电”转换成有限的恢复分支:未提交事务回退,已提交事务重放,已 checkpoint 的事务直接采用正式状态。它保证的是结构可恢复和事务边界可判定,而不是自动替应用定义每一条业务数据的持久化时刻。