
操作系统 / 系统课时
理解 DMA 如何减少 CPU 搬运
理解 DMA 如何减少 CPU 搬运
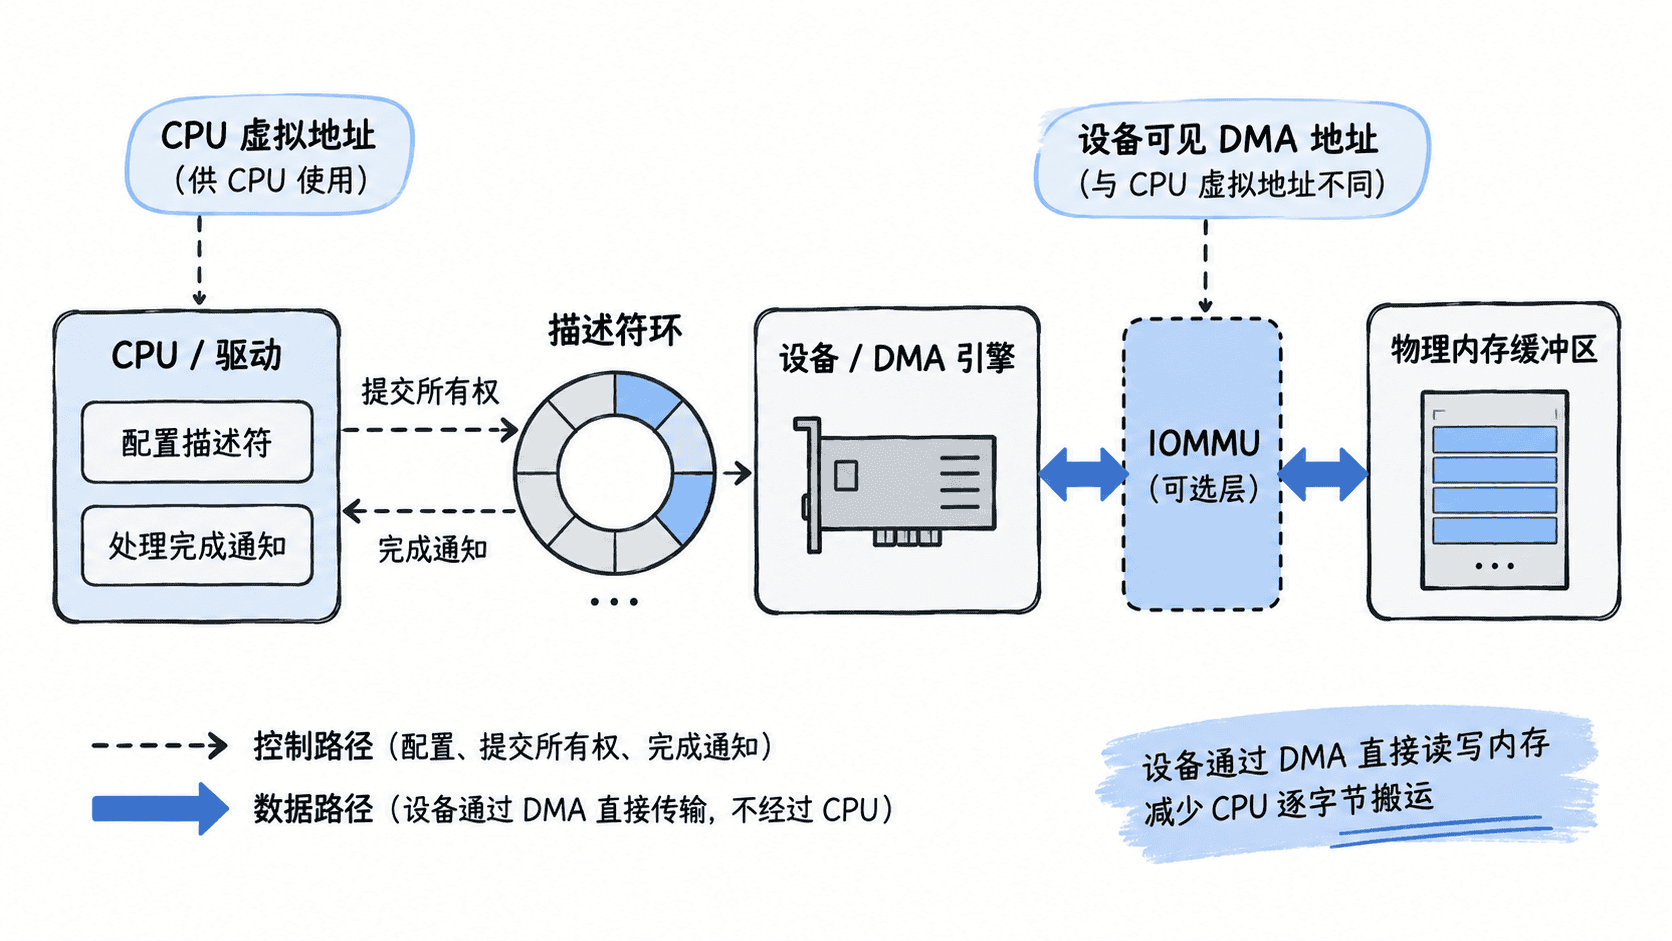
DMA 的价值不是让 CPU 完全退出 I/O,而是把“大块数据搬运”从 CPU 指令循环中移走。CPU 负责准备缓冲区和描述符,设备或 DMA 引擎负责传输,完成后再由 CPU 接手处理结果。
学习目标
- 说明 DMA 传输中 CPU、设备和内存各自承担的职责
- 理解 DMA 地址、缓冲区所有权和完成通知之间的关系
- 区分缓存一致性问题与“CPU 不再搬运数据”这两个概念
CPU 不再逐字节搬运什么
没有 DMA 时,CPU 可以通过程序控制的 I/O 反复从设备寄存器读取数据,再写入内存。数据量一大,CPU 时间就被“搬字节”消耗掉。DMA 把这一步交给设备自带的 DMA 引擎或平台 DMA 控制器:CPU 只描述“从哪里、到哪里、传多少”,真正的数据流不再逐字节经过 CPU 寄存器。
DMA 并不意味着没有 CPU 工作。驱动仍要分配缓冲区、建立描述符、把缓冲区映射成设备可使用的 DMA 地址、把描述符交给设备,并在完成后回收或继续处理这些缓冲区。
一次接收 DMA 是怎样完成的
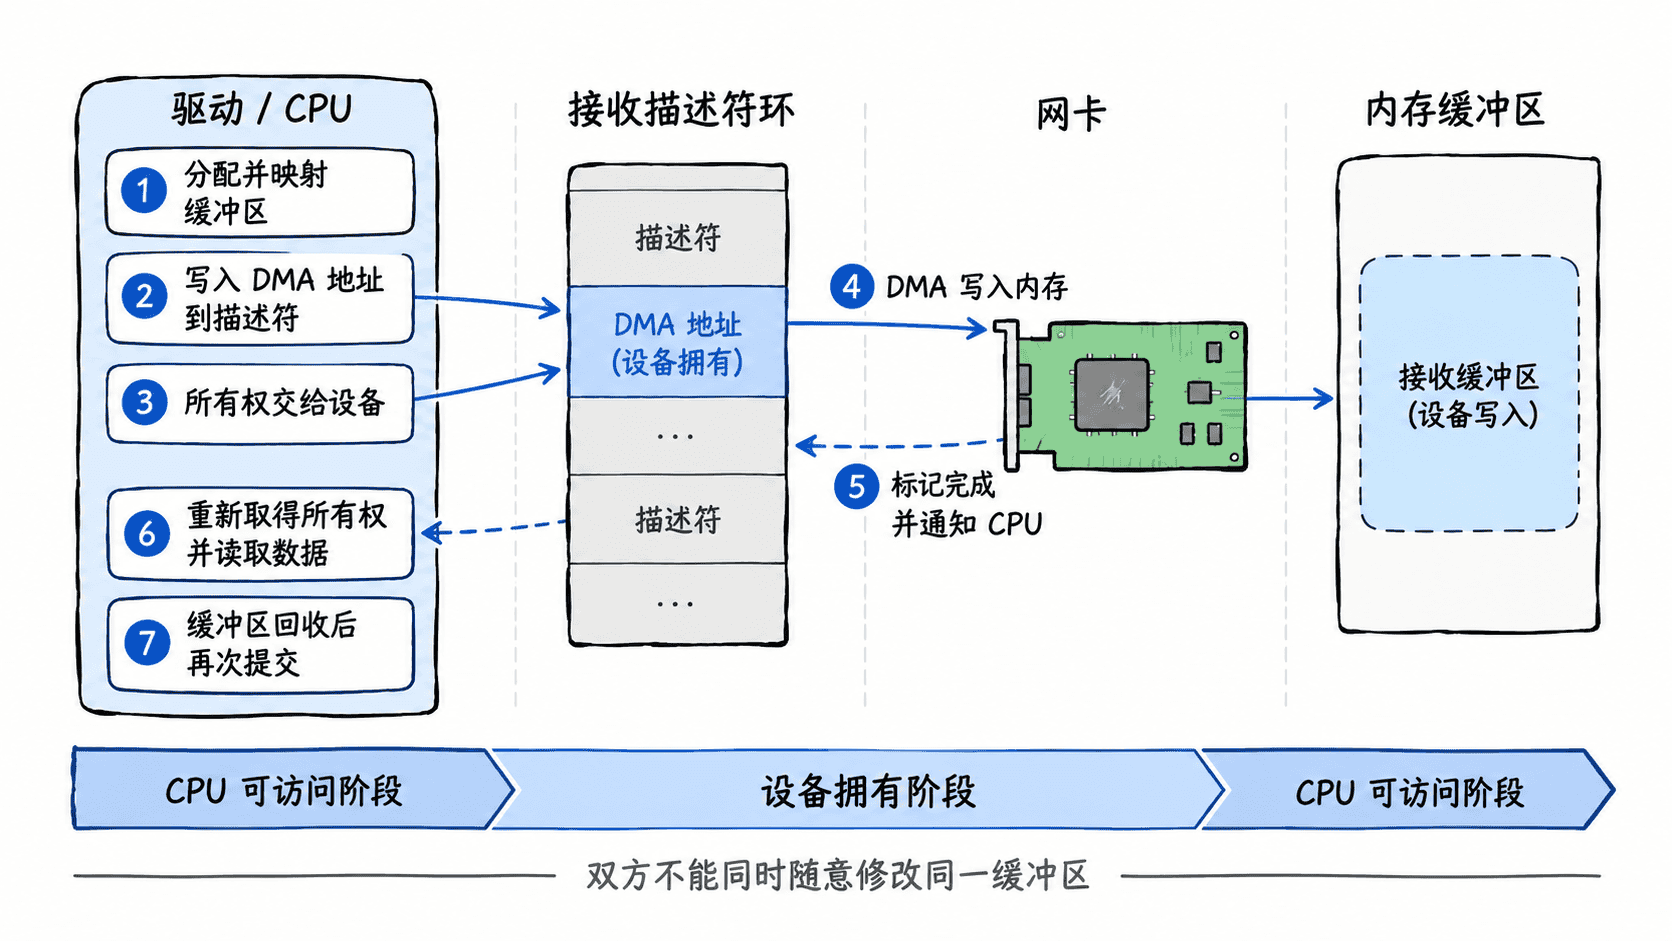
以网卡接收为例,驱动先准备一批可写入的内存缓冲区,并把它们对应的 DMA 地址放入接收描述符环。随后把这些描述符的所有权交给网卡。网卡收到报文后,通过 DMA 把数据写入指定缓冲区,再更新描述符状态并触发完成通知。
CPU 收到中断或进入 NAPI 轮询后,检查哪些描述符已经完成,确认缓冲区重新归 CPU 所有,然后把其中的数据交给协议栈。处理结束后,驱动可以重新映射或回收缓冲区,再次把描述符交还给设备。
DMA 地址为什么不等于普通指针
驱动在 CPU 上操作的是虚拟地址,但设备发起总线事务时使用的是 DMA 地址。两者可能因为 IOMMU、总线地址空间或体系结构限制而不同,所以驱动不能简单把普通内核指针直接写给设备。
Linux 的 DMA API 负责把 CPU 可访问的内存映射为设备可用的地址,并处理体系结构差异。驱动应保存 DMA API 返回的地址,用它填写设备描述符;完成后再按对应接口解除映射或同步,而不是自行假设物理地址关系。
缓存一致性为什么仍然关键
“数据由 DMA 搬运”不代表 CPU 缓存天然知道内存已经被设备修改。在缓存一致的体系结构上,硬件会让 CPU 缓存与 DMA 写入保持一致;在非一致体系结构上,内核 DMA API 需要执行必要的缓存清理或失效操作。
因此 DMA 常见两类内存语义:描述符等长期共享结构适合使用一致性 DMA 内存;大块数据缓冲区则常使用流式映射,在 CPU 与设备交接所有权时进行同步。即使平台具备硬件缓存一致性,驱动仍要遵守内存顺序要求,避免先把“描述符已就绪”暴露给设备,却让描述符内容本身还没有按预期可见。
缓冲区所有权是最重要的边界
DMA 驱动最容易出错的地方,不是“复制得够不够快”,而是 CPU 与设备同时碰同一块缓冲区。只要缓冲区已经交给设备,CPU 就不应继续改写其中的数据;只有设备报告完成并完成必要同步后,CPU 才能安全读取或复用。
这种所有权模型也解释了为什么高性能驱动常使用环形描述符和预分配缓冲区:它们把“谁现在可以访问哪一块内存”变成明确的状态转换,减少频繁分配和同步成本。
DMA 不等于零 CPU 开销
DMA 省掉的是数据搬运指令,不是整个 I/O 路径。CPU 仍然要管理队列、处理完成事件、运行协议栈、进行校验和或加解密,并可能把内核缓冲区的数据复制到用户空间。只有结合中断合并、NAPI、零拷贝或硬件卸载等机制,整个路径的 CPU 成本才会继续下降。
判断 DMA 是否真正带来收益时,应把注意力放在“每字节 CPU 开销是否下降”和“队列、缓存同步、完成处理是否成为新的瓶颈”,而不是只看设备是否宣称支持 DMA。