
操作系统 / 系统课时
用写时复制解释 fork 成本
用写时复制解释 fork 成本
fork 看起来会得到一份完整的子进程地址空间,但内核通常不会在调用返回前复制父进程的全部物理页。写时复制让父子进程先共享页面,只在某一方真正写入时再复制。本篇通过页表变化和可运行实验解释 fork 为什么开始很快,却可能在后续写入阶段增加缺页、内存和延迟成本。
学习目标
- 说明
fork后父子进程如何共享物理页而保持独立地址空间语义 - 跟踪一次写入触发 COW 缺页、页面复制和页表更新的过程
- 判断
fork的初始成本与后续内存压力分别来自哪里
fork 后真正复制了什么
调用 fork 后,子进程获得独立的虚拟地址空间视图,但“独立”不要求立即复制所有物理页内容。内核需要创建子进程自身的进程与内存管理元数据,并建立能够描述其虚拟地址空间的页表结构;父进程已经驻留的普通私有页面则可以暂时由父子共同引用。
为了保持“修改互不影响”的语义,这些可写私有页不会继续允许双方直接原地写入。相关页表项会以只读等方式参与 COW 管理。当父进程或子进程试图修改共享页时,处理器因写权限不满足而触发缺页异常,内核再判断这是不是一个可以通过写时复制修复的访问。
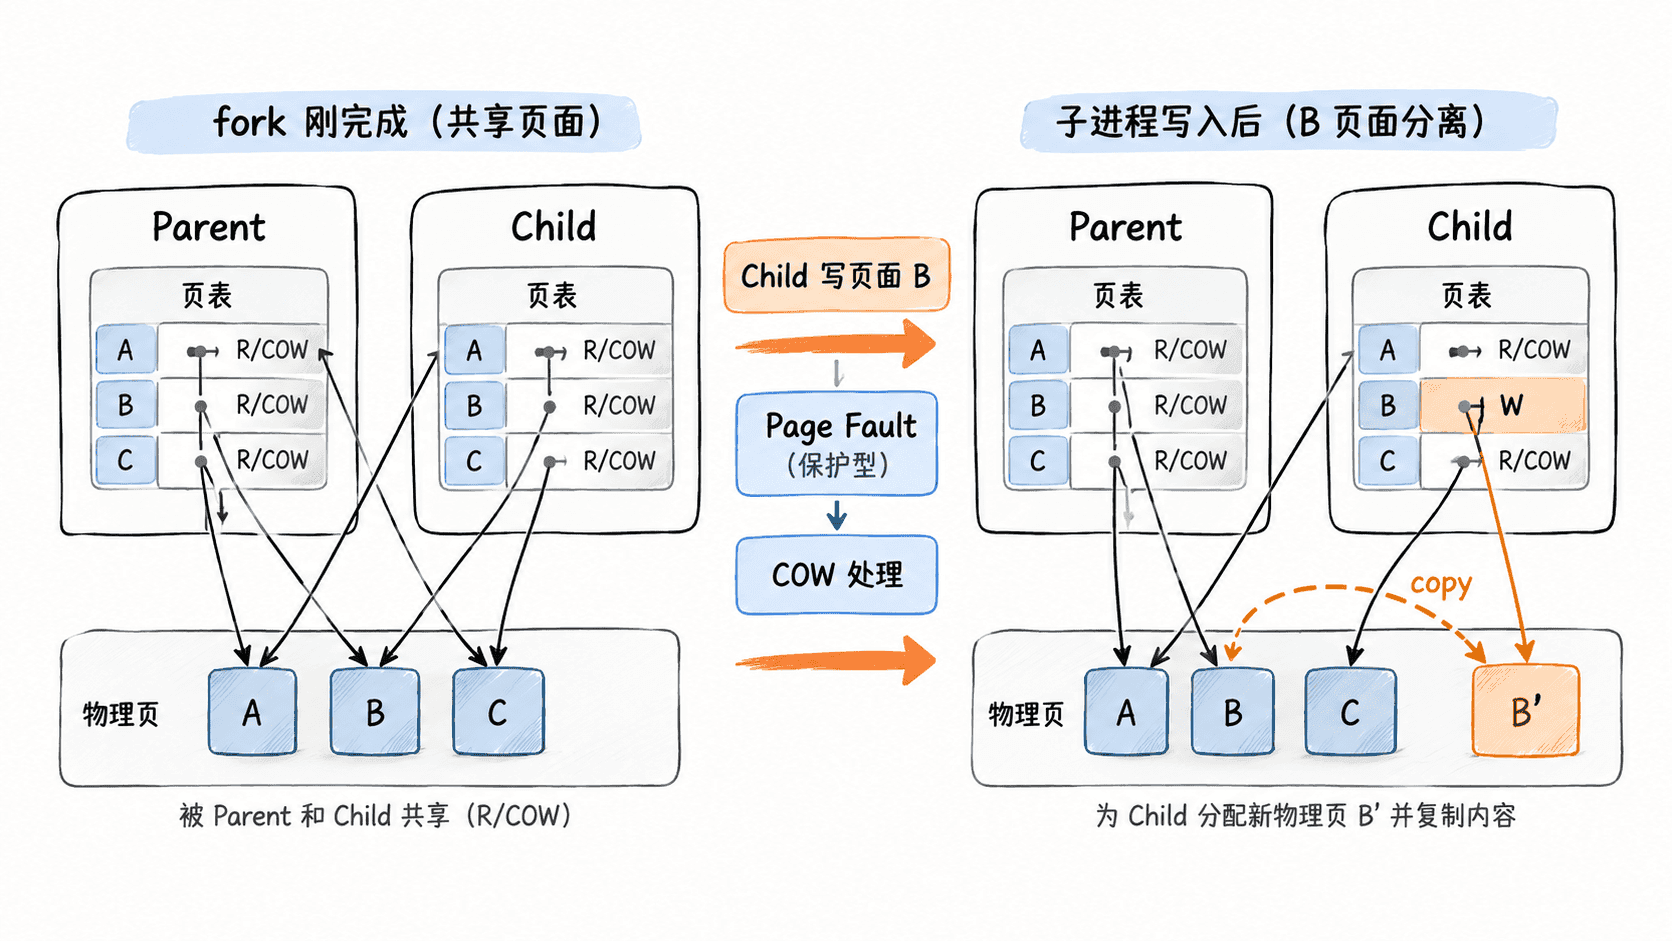
所以 fork 并不是零成本:创建子进程、复制或建立必要的地址空间元数据和页表结构都需要时间,映射越复杂,相关管理工作通常越多。但它避免了在调用当下复制所有用户数据页,这正是大型进程也能较快完成 fork 的核心原因。
写入为什么会触发页面复制
假设父子进程刚完成 fork,两边的虚拟页 B 都指向同一个物理页。子进程第一次写这个页面时,处理过程可以概括为:
- CPU 根据子进程页表发现目标页当前不可直接写,于是产生缺页异常。
- 内核确认地址有效,并识别该页属于写时复制共享页,而不是非法写入。
- 内核获得一个新的物理页,把旧页内容复制过去。
- 子进程页表改为指向新页,并获得正常写权限;父进程仍指向旧页。
- 异常返回后,原来的写指令重新执行,这次修改只落在子进程的新页面上。
如果父子从不写某个共享页,这个页就可以一直共享,不需要复制。若子进程很快执行 exec 替换整个地址空间,大量旧页面也就没有复制的必要,这使 fork 加 exec 成为写时复制特别有价值的场景。
用程序观察 COW 缺页
下面的 Linux 程序先建立 4096 个页面并在父进程中逐页写入,使它们已经拥有实际内容。随后调用 fork。子进程再次逐页写入这些私有页面时,会为大量页面触发 COW;父进程等待子进程结束后检查自己的首字节,验证子进程的修改没有回写到父进程视图。
#define _GNU_SOURCE
#include <stdio.h>
#include <stdlib.h>
#include <sys/mman.h>
#include <sys/resource.h>
#include <sys/wait.h>
#include <unistd.h>

static long minor_faults(void) {
    struct rusage usage;
    if (getrusage(RUSAGE_SELF, &usage) != 0) {
        perror("getrusage");
        exit(1);
    }
    return usage.ru_minflt;
}

int main(void) {
    long page_size = sysconf(_SC_PAGESIZE);
    size_t pages = 4096;
    size_t bytes = (size_t)page_size * pages;

    unsigned char *p = mmap(NULL, bytes, PROT_READ | PROT_WRITE,
                            MAP_PRIVATE | MAP_ANONYMOUS, -1, 0);
    if (p == MAP_FAILED) {
        perror("mmap");
        return 1;
    }

    /* 先由父进程触碰全部页面,使 fork 时存在可共享的私有页。 */
    for (size_t i = 0; i < pages; ++i) {
        p[i * (size_t)page_size] = 1;
    }

#ifdef MADV_NOHUGEPAGE
    madvise(p, bytes, MADV_NOHUGEPAGE);
#endif

    pid_t pid = fork();
    if (pid < 0) {
        perror("fork");
        munmap(p, bytes);
        return 1;
    }

    if (pid == 0) {
        long before = minor_faults();

        /* 每页写一次,使子进程取得自己的可写副本。 */
        for (size_t i = 0; i < pages; ++i) {
            p[i * (size_t)page_size]++;
        }

        long after = minor_faults();
        dprintf(STDOUT_FILENO, "child_pid=%ld\n", (long)getpid());
        dprintf(STDOUT_FILENO, "child_first_byte=%u\n", p[0]);
        dprintf(STDOUT_FILENO, "minor_fault_delta=%ld\n", after - before);
        _exit(0);
    }

    if (waitpid(pid, NULL, 0) < 0) {
        perror("waitpid");
        munmap(p, bytes);
        return 1;
    }

    printf("parent_first_byte=%u\n", p[0]);
    printf("parent_done child_pid=%ld\n", (long)pid);
    munmap(p, bytes);
    return 0;
}
预期结果:子进程把自己的首字节从 1 改成 2,而父进程等待子进程结束后仍读到 1。子进程逐页写入期间的次缺页计数会明显增加;具体差值可能受页大小、透明大页、内核实现和进程本身的额外缺页影响。
将程序保存为 cow_fork.c 后编译并运行:
gcc -O0 -Wall -Wextra cow_fork.c -o cow_fork
./cow_fork
预期输出:
child_pid=<ID>
child_first_byte=2
minor_fault_delta=<COUNT>
parent_first_byte=1
parent_done child_pid=<ID>
<ID> 是实际子进程 PID,<COUNT> 是本次运行观测到的次缺页增量。在普通 4 KiB 页面环境中,它通常会随被写入的页面数量增长,但不应把某个固定计数当作跨系统保证。
fork 为什么先快后可能变贵
写时复制把成本分成了两个阶段。fork 当下主要承担子进程创建、地址空间元数据和页表相关工作,而不是立即复制全部私有物理页;后续只有真正发生写入的共享页面才逐页产生 COW 处理和数据复制。
| 使用方式 | COW 行为 | 主要成本 |
|---|---|---|
fork 后很快 exec |
大多数旧页来不及被写 | 初始进程与页表管理成本为主 |
| 子进程只修改少量页面 | 少量共享页被复制 | 少量次缺页与复制开销 |
| 父子都大量修改原有堆内存 | 大量页面逐渐失去共享 | 缺页、内存带宽和物理内存占用明显增加 |
因此,评价 fork 成本不能只看系统调用返回用了多久。对于拥有巨大可写工作集的进程,更重要的是随后有多少共享页会被修改:只读页能够继续共享,而被写脏的私有页越多,写时复制越会把原本推迟的成本转化为真实的页面复制和额外内存压力。