
操作系统 / 系统课时
分清缓冲、回写与 fsync
分清缓冲、回写与 fsync
一次 write() 返回成功,并不等于数据已经落到掉电后仍存在的介质。本篇把用户态缓冲、内核页缓存、后台回写与 fsync 串成一条写入路径,并说明同步持久化为什么会把设备抖动直接暴露成尾延迟。
学习目标
- 区分用户缓冲、页缓存、后台回写与同步刷盘各自负责的阶段
- 解释
write()、后台回写和fsync()返回时分别能保证什么 - 判断哪些场景需要同步持久化,以及它为什么容易放大尾延迟
四个阶段不要混为一谈
应用写文件时,数据可能先停在语言运行库或标准库的用户态缓冲中;只有缓冲被刷新后,系统调用才把字节交给内核。对普通缓冲 I/O,内核通常把数据放进页缓存并把对应页面标记为脏页,此时 write() 就可能返回。
脏页不会一直留在内存。内核会依据脏页比例、时间阈值和内存压力等条件安排后台回写,把数据送到文件系统、块层和设备。后台回写的目标是逐步清理脏页,不等于应用获得了某个事务点的持久化确认。
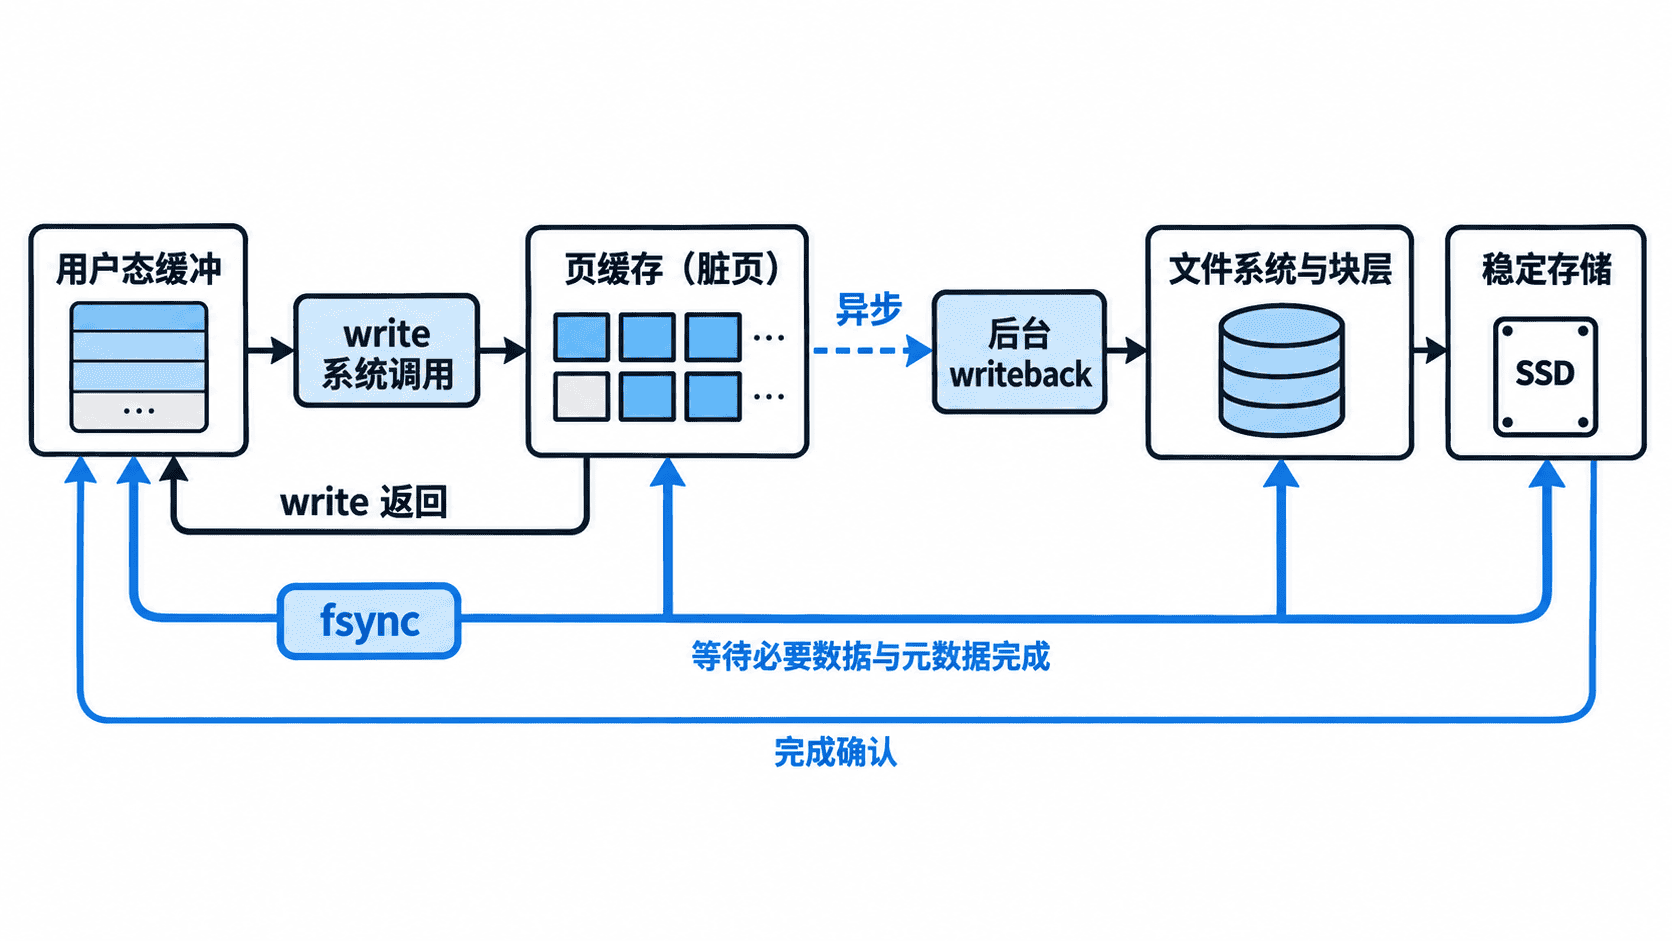
可以把四层保证理解为:用户缓冲决定“数据是否已经进入内核”,页缓存决定“内核是否已接收并暂存”,回写决定“脏数据是否被异步送出”,fsync 则用于在调用点等待该文件所需的数据与元数据完成同步。
用一个最小程序观察 fsync 边界
下面示例关闭 Python 文件对象的用户态缓冲,先执行一次写入,再显式调用 os.fsync()。它不能模拟突然断电,但可以准确展示两个不同的完成点。
from pathlib import Path
import os

path = Path("/tmp/anystack-fsync-demo.txt")

with path.open("wb", buffering=0) as f:
    f.write(b"record-1\n")
    print("write=done")

    # 等待该文件需要同步的数据与元数据完成持久化路径。
    os.fsync(f.fileno())
    print("fsync=done")

path.unlink()
预期输出:
write=done
fsync=done
write=done 只说明字节已经被内核接受;fsync=done 才代表调用方得到了同步完成确认。实际设备、文件系统和虚拟化层仍可能影响延迟,因此不要把两行输出之间的时间差当成固定值。
为什么 fsync 容易抬高尾延迟
异步写入可以把许多小写合并,让内核和设备自行选择更高效的时机;fsync 则在请求路径上建立等待点。只要此前积累了较多脏页、文件系统需要提交日志事务、设备队列拥塞,或底层介质发生内部整理,这次调用就可能等待更久。
因此平均延迟很低也不能说明同步写入稳定。数据库 WAL、消息日志和关键配置落盘更关心 P99、P999,因为一次慢 fsync 就可能直接变成一次慢提交。把每条业务记录都单独同步,通常比“批量写入后一次同步”产生更多设备屏障和提交开销。
fsync 也有边界
fsync(fd) 主要针对这个已打开文件。若程序刚创建文件或通过 rename() 原子替换文件,还要考虑父目录中的目录项是否需要单独同步;否则文件内容已经同步,并不自动等于“新名字在崩溃后一定存在”。
还要区分“操作系统已经把请求同步到存储设备”和“硬件在彻底掉电后一定保留数据”。现代设备通常有自己的缓存与持久化语义,可靠系统需要依赖设备正确实现刷新命令,并结合掉电保护、控制器配置和文件系统语义评估端到端保证。
选择同步策略时,关键不是“越多 fsync 越安全”,而是把业务提交点、文件系统持久化点和性能预算对齐:允许丢少量最近数据的日志可以批量同步,事务提交记录则应在对外确认成功之前完成所需的持久化。