
操作系统 / 系统课时
完成一次服务延迟分层诊断
完成一次服务延迟分层诊断
高延迟服务往往同时出现 CPU 波动、上下文切换、缺页、磁盘队列和系统调用等待。有效排查不是把所有工具都跑一遍,而是按层建立假设、采集同一时间窗口的证据,再用排除法把问题缩到真正的瓶颈层。
学习目标
- 按 CPU、调度、内存、磁盘、系统调用五层组织延迟诊断。
- 用一组短时采样保存可复查的原始证据,而不是凭单个指标下结论。
- 通过交叉验证和修复前后对比,把相关性提升为可验证的根因判断。
先建立分层假设
服务请求从用户态代码进入内核后,可能消耗 CPU,也可能在运行队列、缺页换入、块设备队列或系统调用里等待。排查顺序应从“资源是否真的忙”开始,再进入更细的等待原因;否则很容易把同时出现的次要指标当成根因。
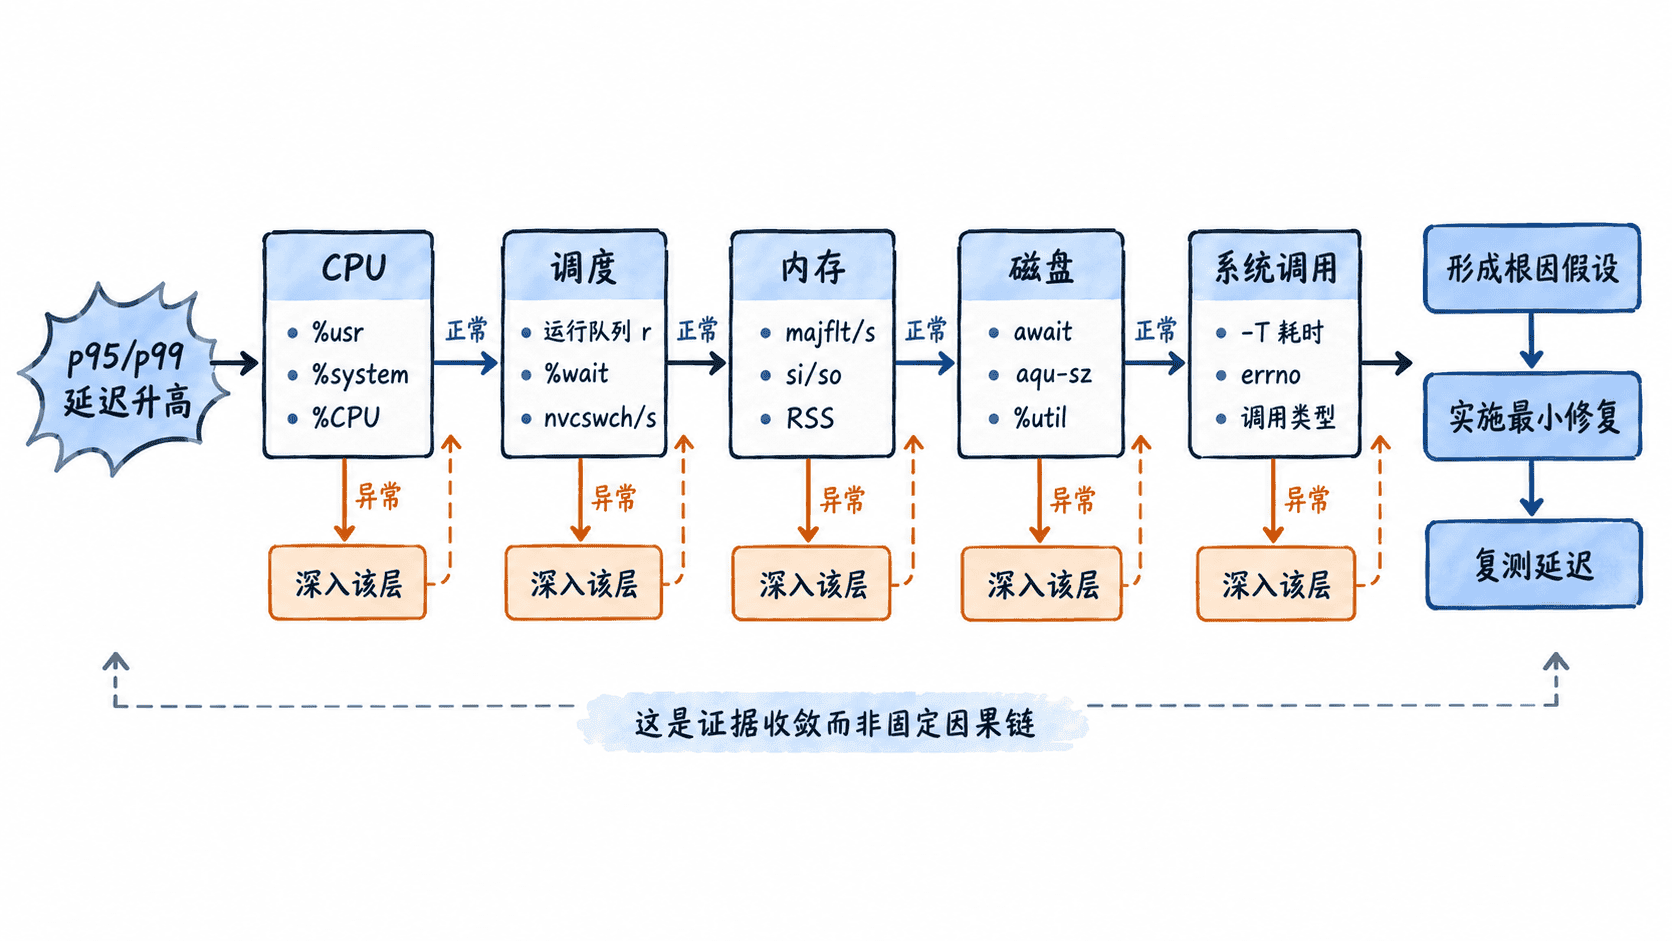
这个顺序不是说后面的层一定比前面的层“更深”,而是让每一步都回答一个明确问题:CPU 是否饱和、线程是否抢不到运行时间、内存是否发生回收或换页、存储是否排队、线程最终阻塞在哪个内核接口。
采集一组可复查的证据
下面的脚本要求系统已安装 sysstat 与 strace,并把代码中的 <ID> 替换为目标服务 PID;也可以预先通过环境变量 PID 传入。它在同一诊断阶段分别保存 CPU、调度、内存、磁盘和系统调用跟踪,避免终端滚屏后失去原始证据。
PID="${PID:-<ID>}"
if ! [[ "$PID" =~ ^[0-9]+$ ]]; then
  echo "请把 <ID> 替换为目标服务的实际 PID" >&2
  exit 2
fi
out=$(mktemp -d)

sudo -v

pidstat -u -p "$PID" 1 5 >"$out/cpu.txt" & p1=$!
pidstat -w -p "$PID" 1 5 >"$out/sched.txt" & p2=$!
pidstat -r -p "$PID" 1 5 >"$out/mem.txt" & p3=$!
vmstat 1 5 >"$out/vmstat.txt" & p4=$!
iostat -xz 1 5 >"$out/disk.txt" & p5=$!
sudo timeout --signal=INT 5s strace -tt -T -f   -e trace=futex,connect,recvfrom,sendto,read,write,fsync,fdatasync,poll,ppoll,epoll_wait   -p "$PID" 2>"$out/strace.txt" & p6=$!

wait "$p1" "$p2" "$p3" "$p4" "$p5"
wait "$p6" || true

printf 'evidence_dir=%s\n' "$out"
printf '%s\n' "$out/cpu.txt" "$out/sched.txt" "$out/mem.txt" \
  "$out/vmstat.txt" "$out/disk.txt" "$out/strace.txt"
预期输出
evidence_dir=<PATH>
<PATH>/cpu.txt
<PATH>/sched.txt
<PATH>/mem.txt
<PATH>/vmstat.txt
<PATH>/disk.txt
<PATH>/strace.txt
实际目录、指标数值和 strace 汇总内容取决于现场。脚本的目标不是自动给结论,而是固定采样窗口和证据位置,便于把服务延迟时间点与系统指标对齐。
按证据逐层排除
| 层次 | 主要证据 | 更可靠的判断方式 |
|---|---|---|
| CPU | pidstat -u 的 %usr、%system、%CPU |
持续接近可用 CPU 上限才支持“算力饱和”;只看瞬时尖峰不够 |
| 调度 | pidstat -w 的自愿/非自愿切换,vmstat 的 r |
高运行队列并伴随任务等待运行,才更像 CPU 争抢或调度压力 |
| 内存 | pidstat -r 的缺页,vmstat 的 si、so |
持续 major fault 或换入换出比单纯 RSS 大更值得警惕 |
| 磁盘 | iostat -xz 的 await、aqu-sz、吞吐与 %util |
延迟和队列同时升高更有意义;高速 NVMe 上不能只凭 %util 判饱和 |
| 系统调用 | strace -T 的单次耗时、返回值和调用类型 |
长等待集中在 futex、I/O 或网络相关调用时,再回到具体资源验证 |
一个常见误区是把单个“高”指标直接当根因。例如上下文切换高可能只是高并发的结果,RSS 大也不代表正在换页。只有指标和请求延迟同步变化,并且其他层没有更强证据时,才值得继续深入。
把相关性升级成因果判断
假设 CPU 并不饱和,运行队列也不长,si/so 接近零,磁盘 await 稳定,但 strace 反复出现长耗时 futex。这时合理结论不是“系统慢”,而是“线程同步等待值得优先验证”。下一步应定位热点线程和锁持有者,再通过降低竞争、缩短临界区或修正并发度做最小改动。
反过来,如果 iostat 的队列和 await 与延迟同时抬升,而 strace 中 fsync、read 等调用耗时也同步增加,存储瓶颈的证据链就更完整。真正的定位应至少满足三点:现象与指标同窗出现、两个独立观测指向同一层、针对该层的改动能显著改变延迟。
用复测完成验收
修复后使用相同流量条件和相近采样窗口复测 p95/p99 延迟,同时重新采集对应层指标。如果延迟下降而目标指标按预期改善,且其他资源没有出现新的排队,根因判断才算闭环;如果只改善了指标却没有改善用户侧延迟,应撤回该假设并继续检查下一层。