
操作系统 / 系统课时
用 strace 判断系统调用阻塞
用 strace 判断系统调用阻塞
程序“卡住”时,真正需要确认的不是进程有没有响应,而是线程正在等待哪个内核接口。通过 strace 的调用耗时、返回值和频率,可以把网络、文件、锁与事件等待落到具体系统调用上,再决定下一步该查哪一层。
学习目标
- 用
-tt与-T区分调用发生时间和单次系统调用耗时。 - 根据
futex、connect、read、fsync、epoll_wait等调用判断等待对象。 - 结合错误码与调用频率,避免把正常等待误判为性能瓶颈。
先看时间,不要先猜原因
strace 观察的是用户态与内核态之间的系统调用边界。对阻塞问题最有价值的两个维度是:某个调用一次等了多久,以及同类调用在采样窗口内出现了多少次。-tt 给每行加时间戳,-T 在返回值后显示本次调用耗时;多线程服务通常还需要 -f 跟踪新线程或子进程。
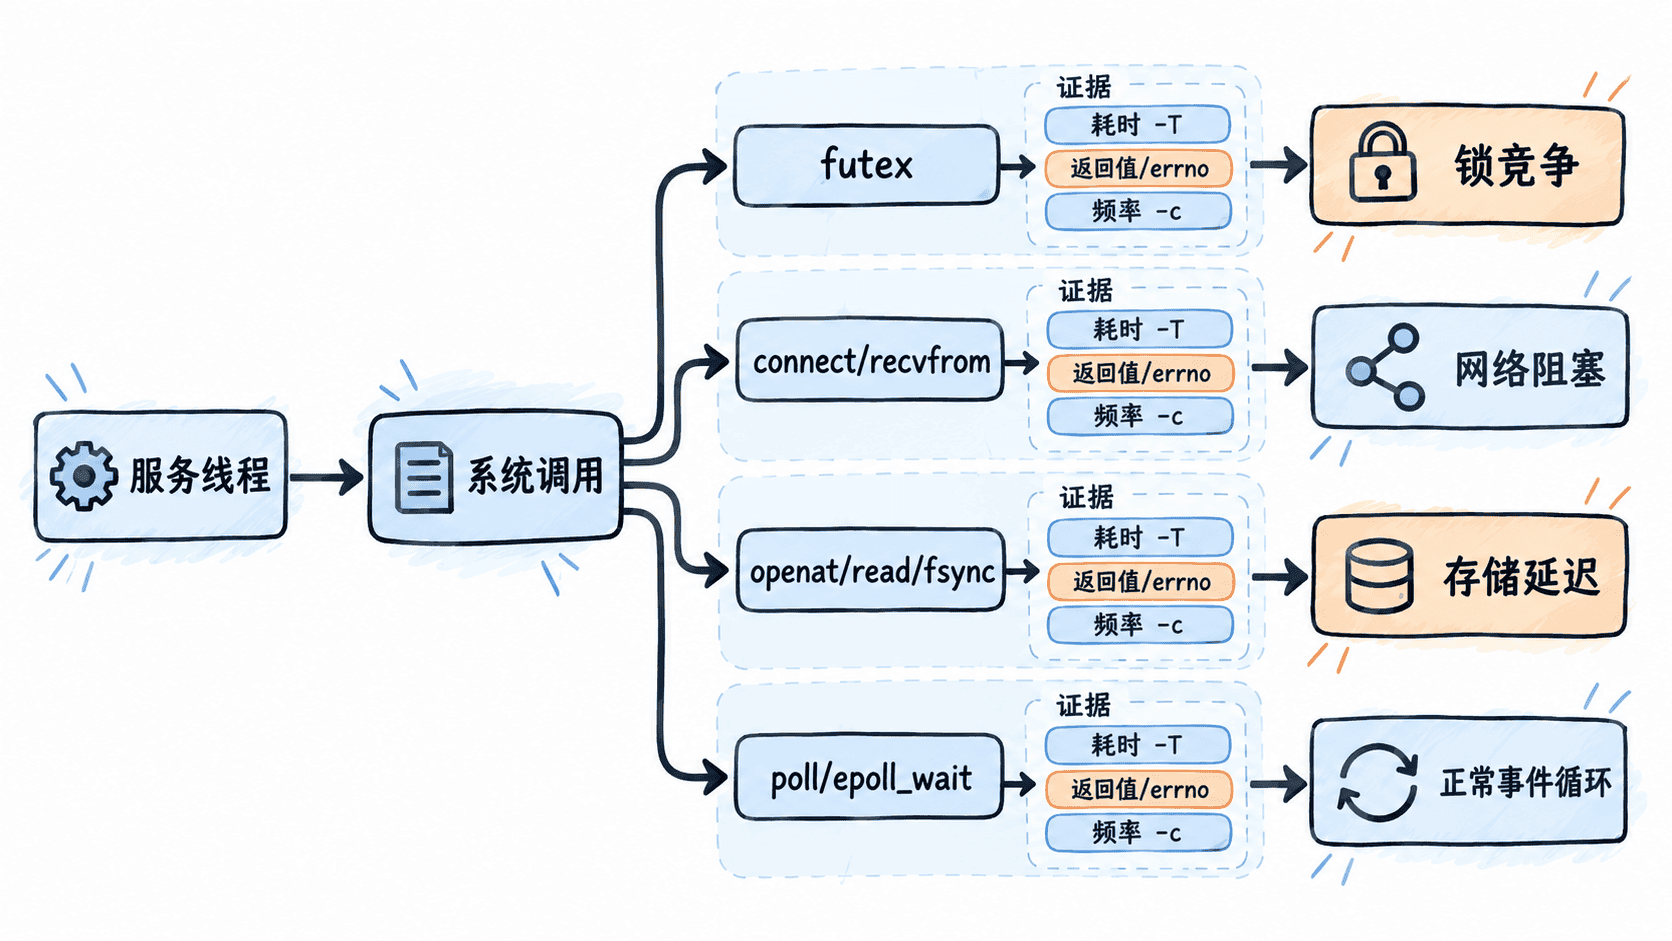
长耗时本身还不能直接等于“异常”。例如事件循环中的 epoll_wait 本来就应该休眠;只有当等待形态与请求延迟、线程状态和业务预期不一致时,它才是线索。
用一个可控阻塞读懂 -T
下面用 FIFO 制造一次约 1 秒的阻塞打开。写端故意延迟 1 秒启动,cat 在打开 FIFO 时会等待对端出现,因此能直观看到 openat 的耗时。
dir=$(mktemp -d)
fifo="$dir/fifo"
mkfifo "$fifo"
( sleep 1; printf x >"$fifo" ) &
strace -tt -T -e trace=openat,read -o "$dir/trace.log" cat "$fifo" >/dev/null
grep "$fifo" "$dir/trace.log"
rm -rf "$dir"
预期输出
<TIME> openat(AT_FDCWD, "<PATH>/fifo", O_RDONLY) = <FD> <1.00...>实际时间、临时路径和文件描述符会不同,但关键特征一致:调用直到约 1 秒后才返回。现场服务中同样先找“耗时明显高于同类调用”的行,再看它在等待什么对象。
把调用形态映射到资源
| 典型系统调用 | 常见含义 | 还需要确认什么 |
|---|---|---|
futex |
互斥锁、条件变量或运行库同步等待 | 哪个线程持锁,等待是否集中在少数线程 |
connect |
建连、路由、握手相关等待 | 目标地址、超时策略、网络丢包与对端状态 |
read、recvfrom |
等文件数据、管道数据或网络数据 | fd 对应的真实资源,以及是否应当阻塞 |
fsync、fdatasync |
等待脏数据持久化 | 存储延迟、写入队列和同步写频率 |
poll、epoll_wait |
等事件到达 | 事件循环是否本来就应该空闲等待 |
如果需要识别 fd 指向什么资源,可在现场额外关注 -yy 展示的描述符信息;如果需要看“谁最耗时间”,再用汇总模式统计调用次数与总耗时,而不是只盯一条慢调用。
用返回值和频率补齐证据
错误码要结合调用语义判断。非阻塞 I/O 中的 EAGAIN 可能完全正常;持续出现 ETIMEDOUT、ECONNREFUSED 或同一路径上的 ENOENT 才更像故障信号。高频短调用也可能形成系统调用风暴:单次只有几十微秒,但每秒数万次时,累计开销仍然可观。
排查时按这个顺序收敛:先找与延迟窗口重合的长耗时调用,再确认 fd、路径或目标地址,随后检查 errno,最后才比较调用频率。这样能避免看到 futex 就断言“锁竞争”,或看到 epoll_wait 很长就误判线程被卡死。
当调用耗时、等待对象和错误码能同时指向同一资源时,strace 才完成了它最重要的任务:把“服务很慢”转换成一个可以继续验证的内核接口级假设。