
操作系统 / 系统课时
用 iostat 识别存储瓶颈
用 iostat 识别存储瓶颈
磁盘利用率接近 100% 并不能直接证明存储已经饱和,尤其是支持并行 I/O 的 SSD 和 NVMe。可靠的判断需要同时观察吞吐、请求延迟、队列深度和设备忙碌程度。本节用 iostat 连续采样这些指标,并把设备繁忙与真正影响请求延迟区分开。
学习目标
- 使用扩展模式读取设备吞吐、等待时间、队列与利用率指标
- 联合
await、aqu-sz和%util判断 I/O 请求是否正在设备前排队 - 避免仅凭
%util或吞吐量对 HDD、SSD、NVMe 作出错误的饱和结论
获取可用于诊断的连续样本
iostat 由 sysstat 工具包提供。排查实时瓶颈时应启用扩展设备统计,并按固定周期连续采样。下面的 -y 会跳过自系统启动以来的第一份累计统计,-z 会隐藏完全空闲的设备,便于聚焦当前负载。
LC_ALL=C iostat -d -x -z -y 1 5预期输出
Device            r/s     rkB/s   rrqm/s  %rrqm  r_await  rareq-sz     w/s     wkB/s   wrqm/s  %wrqm  w_await  wareq-sz  aqu-sz  %util
nvme0n1          82.00  10496.00     2.00   2.38     8.20    128.00   95.00  15360.00     6.00   5.94    18.40     161.68    2.42   91.20

Device            r/s     rkB/s   rrqm/s  %rrqm  r_await  rareq-sz     w/s     wkB/s   wrqm/s  %wrqm  w_await  wareq-sz  aqu-sz  %util
nvme0n1          91.00  11648.00     1.00   1.09    10.60    128.00  103.00  16896.00     5.00   4.63    23.10     164.04    3.16   96.40
实际设备名、数值和列集合会随内核、sysstat 版本及设备类型变化,但诊断逻辑相同:不要只读取某一列,而要比较多个采样周期的变化趋势。
先看请求有没有变慢
扩展统计中最值得优先检查的是等待时间。r_await 和 w_await 分别表示读、写请求从提交到完成的平均时间,通常以毫秒计;某些版本还会提供综合 await。
延迟必须结合设备基线解释。机械硬盘随机 I/O 的正常等待时间可能远高于 NVMe,因此不存在适用于所有设备的统一“超过多少毫秒就是故障”阈值。更可靠的方式是与该设备平时的正常值比较,并确认升高是否与业务延迟同时发生。
吞吐量同样不能单独证明饱和。rkB/s、wkB/s 高说明设备正在搬运大量数据,但如果 await 仍然稳定、队列没有增长,设备可能只是高效地处理顺序或并行 I/O。
用队列判断设备是否来不及处理请求
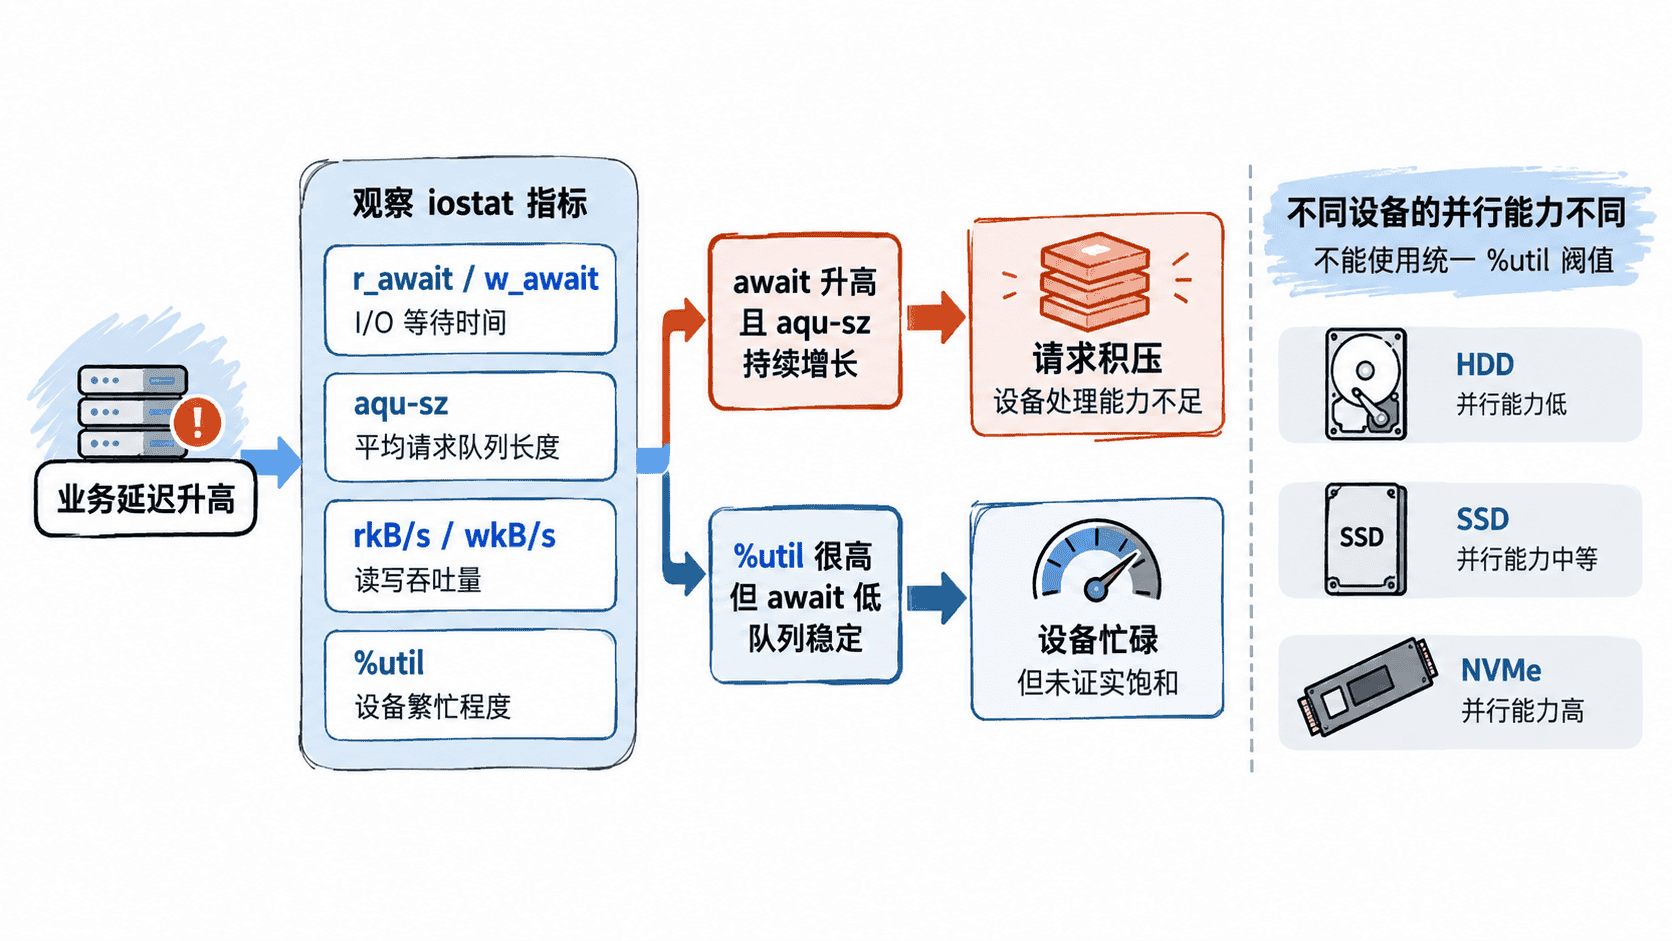
aqu-sz 表示采样周期内设备队列中请求数量的平均水平。它持续增加时,说明请求进入设备的速度正在超过完成速度。此时再结合等待时间,才能判断排队是否已经变成性能问题。
| 现象 | 更可能的解释 |
|---|---|
吞吐高、await 稳定、aqu-sz 稳定 |
设备负载高,但仍能及时完成请求 |
await 升高、aqu-sz 持续增长 |
请求开始积压,存储很可能成为瓶颈 |
%util 高、await 仍低 |
设备持续忙碌,但不能据此确认已经饱和 |
| 写延迟高而读延迟正常 | 优先排查写入路径、刷盘、文件系统或后端介质 |
正确理解设备利用率
%util 表示采样周期内设备至少有 I/O 请求处于处理状态的时间比例。对串行能力有限的传统磁盘,它长期接近 100% 且同时出现高延迟和长队列时,往往是很强的饱和信号。
但现代 SSD、NVMe 和多队列块设备可以并行处理大量请求。设备几乎整个采样周期都处于忙碌状态,并不意味着内部所有通道都已经用尽。因此 %util 必须作为辅助证据,而不能替代延迟和队列指标。
按证据链定位瓶颈
发现接口、数据库或文件服务变慢后,可以按固定顺序缩小范围:
- 观察多个周期的
r_await、w_await,确认设备响应时间是否明显偏离正常基线。 - 检查
aqu-sz是否随负载持续增长,判断请求是否排队。 - 查看
r/s、w/s与rkB/s、wkB/s,分清瓶颈对应随机请求数量还是大块吞吐。 - 最后使用
%util判断设备是否长期忙碌,并结合设备类型解释该值,而不是单独依据它下结论。
如果等待时间和队列持续升高,而业务延迟与之同步变化,就已经具备较强的存储瓶颈证据;接下来应继续定位具体进程、文件系统、数据库刷盘或底层设备。反过来,如果只是吞吐和 %util 很高,而延迟与队列稳定,则更像是设备正在高负载但健康地工作。