
操作系统 / 系统课时
理解 TLB 与大页的性能取舍
理解 TLB 与大页的性能取舍
这一节把“页越大越快”拆成可以判断的条件:TLB 为什么会限制地址翻译,大页怎样扩大一次缓存的覆盖范围,以及它为什么又可能带来碎片、整理和延迟成本。读完后,你能用系统指标判断大页是否真的值得启用。
学习目标
- 区分 TLB miss、页表遍历与真正的缺页异常
- 用页数量和工作集大小解释大页为何能减少地址翻译压力
- 根据访问密度、内存压力与延迟目标选择普通页、透明大页或显式大页
TLB 缓存的到底是什么
CPU 发出的地址通常是虚拟地址,真正访问内存前必须翻译成物理地址。TLB 是处理器中的地址翻译缓存,保存近期使用的“虚拟页号到物理页框号”以及权限信息。命中时可以跳过大部分页表遍历,未命中时则要重新查询页表。
TLB miss 不等于 page fault。TLB 没命中但页表项有效时,硬件或内核只需完成页表遍历并把结果重新放进 TLB;只有页表表明目标页尚未建立有效驻留映射等情况,才会进入真正的缺页异常处理。
可以把 TLB 的粗略覆盖能力理解为“可用翻译条目数 × 每个条目覆盖的页大小”。实际处理器通常还有多级 TLB、不同页大小的独立结构和组相联限制,因此这个关系用于建立直觉,不应当当成某款 CPU 的精确容量公式。
大页如何扩大翻译覆盖范围
以 1 GiB 连续工作集为例,如果使用 4 KiB 页,需要 262144 个页;如果使用常见的 2 MiB 大页,只需要 512 个页。工作集没有变,但需要管理的虚拟页数量下降了 512 倍,页表项数量也随之显著减少。
| 页大小 | 1 GiB 工作集对应页数 | 主要影响 |
|---|---|---|
| 4 KiB | 262144 | 粒度细、利用率高,但翻译项很多 |
| 2 MiB | 512 | 翻译项大幅减少,页表更小 |
| 1 GiB | 1 | 覆盖极大,但对对齐、连续内存和使用场景要求更高 |
页数减少并不意味着“数据缓存变大”。大页优化的是地址翻译和页表管理,L1/L2/L3 数据缓存容量不会因此增加。如果程序本身受内存带宽、缓存未命中或锁竞争限制,单纯切换大页可能几乎没有收益。
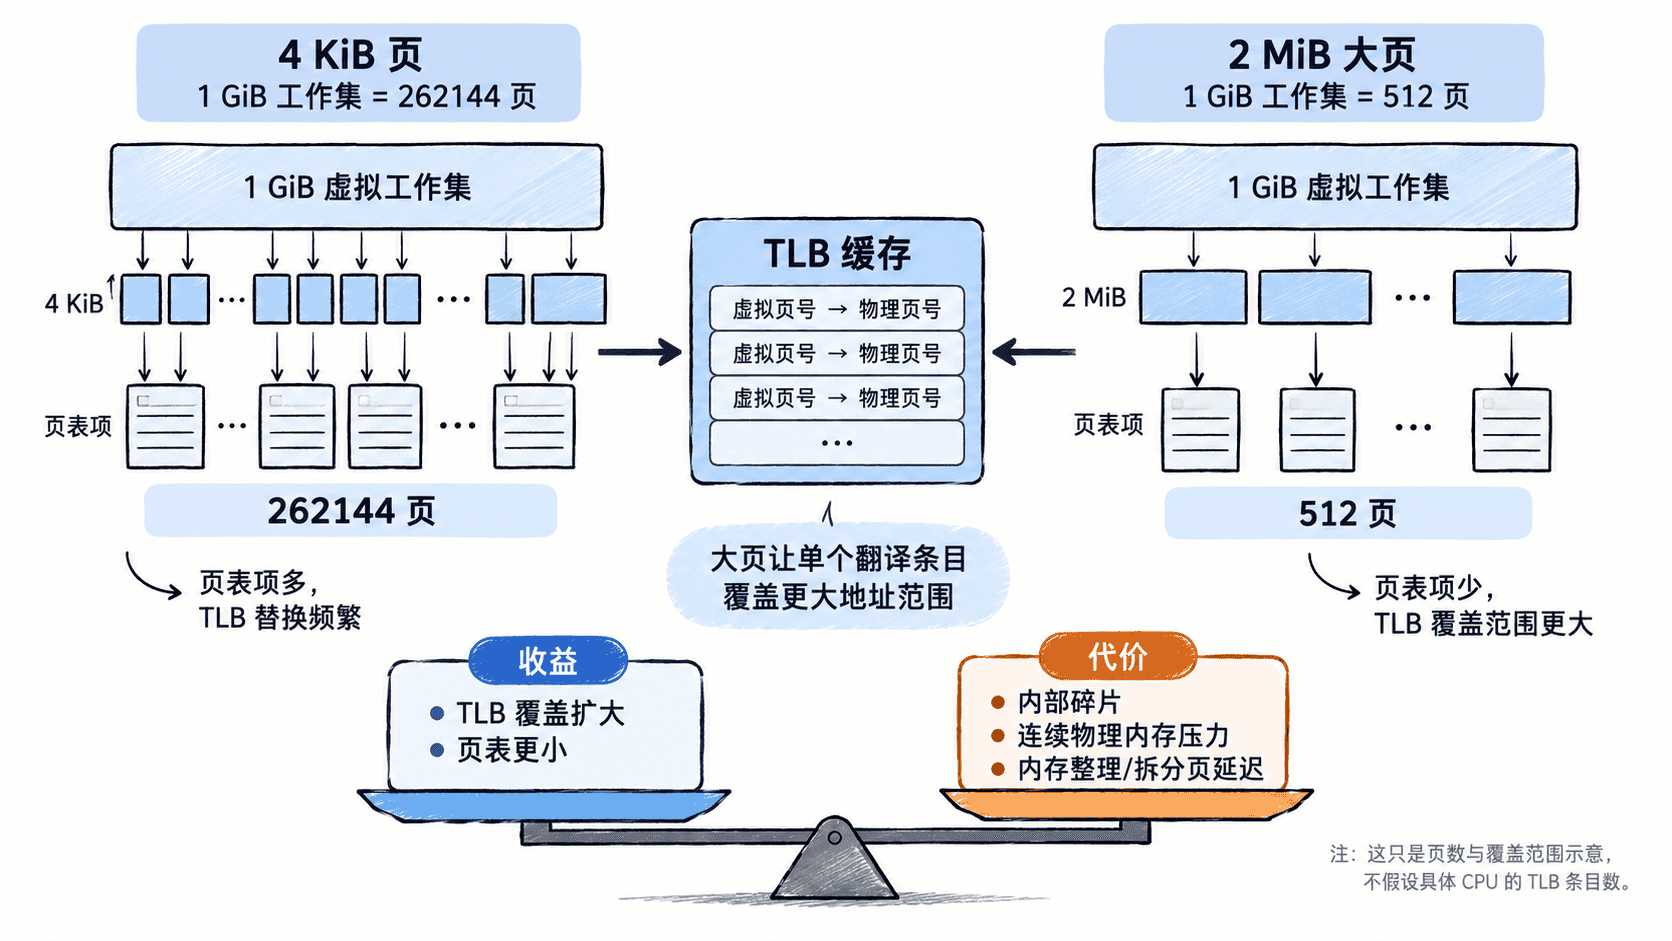
大页换来的成本
第一类成本是内存利用率。页粒度越大,应用若只稀疏触碰其中一小部分区域,就越容易浪费已经组织成大页的物理内存。对于大量小对象、稀疏映射或生命周期很短的分配,这种内部碎片可能抵消 TLB 收益。
第二类成本是物理内存管理。传统 2 MiB THP 或 HugeTLB 页通常需要更大的连续物理块;系统运行一段时间后,如果可用内存高度碎片化,内核可能需要做内存整理、回收、回退到小页,或者在后续发生大页拆分。追求极低尾延迟的服务必须把这些抖动纳入评估。
第三类成本出现在写时复制、迁移和回收等路径。大页覆盖范围更大,某些操作可能需要拆分大页或处理更大的物理区域,所以“平均吞吐提高”并不自动代表“高分位延迟更好”。
先用系统信息确认现状
在 Linux 上,可以先检查基础页大小、显式 HugeTLB 池和透明大页状态。下面命令不会修改系统配置。
getconf PAGESIZE
grep -E '^(AnonHugePages|ShmemHugePages|HugePages_Total|HugePages_Free|Hugepagesize):' /proc/meminfo
cat /sys/kernel/mm/transparent_hugepage/enabled
预期输出(实际数值会随机器状态变化)
4096
AnonHugePages:     <KB> kB
ShmemHugePages:    <KB> kB
HugePages_Total:   <N>
HugePages_Free:    <N>
Hugepagesize:      2048 kB
always [madvise] never
<KB> 和 <N> 会随机器实时状态变化,方括号包围的 THP 策略也可能不同。PAGESIZE 表示基础页大小;AnonHugePages 反映当前匿名透明大页占用;HugePages_Total 和 HugePages_Free 属于显式 HugeTLB 池,不能把它们与 THP 混为一谈。
什么时候值得用大页
大页最适合“大、长寿命、访问密集”的工作集,例如连续扫描或高频随机访问的大型内存区域。此时 TLB miss 和页表开销更可能进入性能热点,而且大部分大页内容都会被真正使用,碎片成本较低。
对于内存稀疏、对象很小、频繁 fork/写时复制、系统内存压力高或极度敏感于尾延迟的负载,应谨慎扩大页粒度。更稳妥的方式是先固定同一工作负载,用 perf stat 等工具比较 TLB miss、CPU 周期和实际延迟,再决定是否启用或扩大大页使用范围。
选择大页的目标不是“让页尽可能大”,而是让地址翻译成本与内存管理成本同时下降。只看到 TLB 命中率而忽略碎片、整理和延迟抖动,往往会把局部优化变成整体退化。