
操作系统 / 系统课时
用 perf 找出 CPU 热点
用 perf 找出 CPU 热点
CPU 使用率很高只说明“处理器忙”,并不能说明时间花在哪里。本篇用 perf record 采样指令位置和调用栈,再用 perf report 聚合热点,区分用户态计算、锁竞争和内核路径;最终能从函数级证据决定该优化算法、同步策略还是系统调用。
学习目标
- 理解
perf采样分析的工作方式,并知道它与逐条跟踪的区别 - 用
perf record -g采集调用栈,用perf report找出热点函数 - 根据符号和调用栈识别计算热点、锁等待与内核态消耗
先确认采样环境
多数发行版将 perf 放在内核工具包中,运行 perf --version 应能得到版本信息。若普通用户采样时报 Permission error 或 No permission to enable cycles event,先查看 cat /proc/sys/kernel/perf_event_paranoid,再按发行版安全策略授予权限;不要为了方便直接长期关闭限制。
分析时还需要符号信息。自己编译的程序建议保留调试符号并避免省略帧指针,例如 GCC 使用 -g -fno-omit-frame-pointer。生产程序如果经过 strip,应准备对应的调试符号包,否则报告可能只能看到地址或不完整的函数名。
采集一个可控的 CPU 热点
下面构造一个故意消耗 CPU 的 C 程序。hot_loop 被禁止内联,便于 perf 在报告中稳定显示它;示例使用 -O0 只是为了教学观察,不能当作生产构建优化建议。
cat >/tmp/perf_hotspot.c <<'EOF'
#include <stdint.h>
#include <stdio.h>

__attribute__((noinline))
static uint64_t hot_loop(uint64_t n) {
    volatile uint64_t sum = 0;
    for (uint64_t i = 0; i < n; ++i) {
        sum += (i * 33u) ^ (i >> 3);
    }
    return sum;
}

int main(void) {
    uint64_t value = 0;
    for (int round = 0; round < 40; ++round) {
        value ^= hot_loop(5000000);
    }
    printf("%llu\n", (unsigned long long)value);
    return 0;
}
EOF
gcc -O0 -g -fno-omit-frame-pointer /tmp/perf_hotspot.c -o /tmp/perf_hotspot
perf record -F 99 -g -o /tmp/perf.data -- /tmp/perf_hotspot >/tmp/perf-run.out 2>/tmp/perf-record.log
perf report --stdio --no-children -i /tmp/perf.data --sort comm,dso,symbol | grep -m 1 hot_loop
预期输出
<PERCENT>% perf_hotspot perf_hotspot [.] hot_loop<PERCENT> 会随 CPU、内核和采样次数变化,但 hot_loop 应出现在主要热点中。若完全看不到采样,优先检查 perf_event_paranoid、容器权限、虚拟机 PMU 支持以及程序是否运行得太短。
从采样到热点的工作机制
perf record 不是记录每一条指令,而是按事件或频率周期性打断执行,读取当时的指令位置;加上 -g 后,还会采集调用栈。大量样本聚合后,某个函数被采中的比例越高,通常说明 CPU 时间越集中在该函数或其子调用路径。
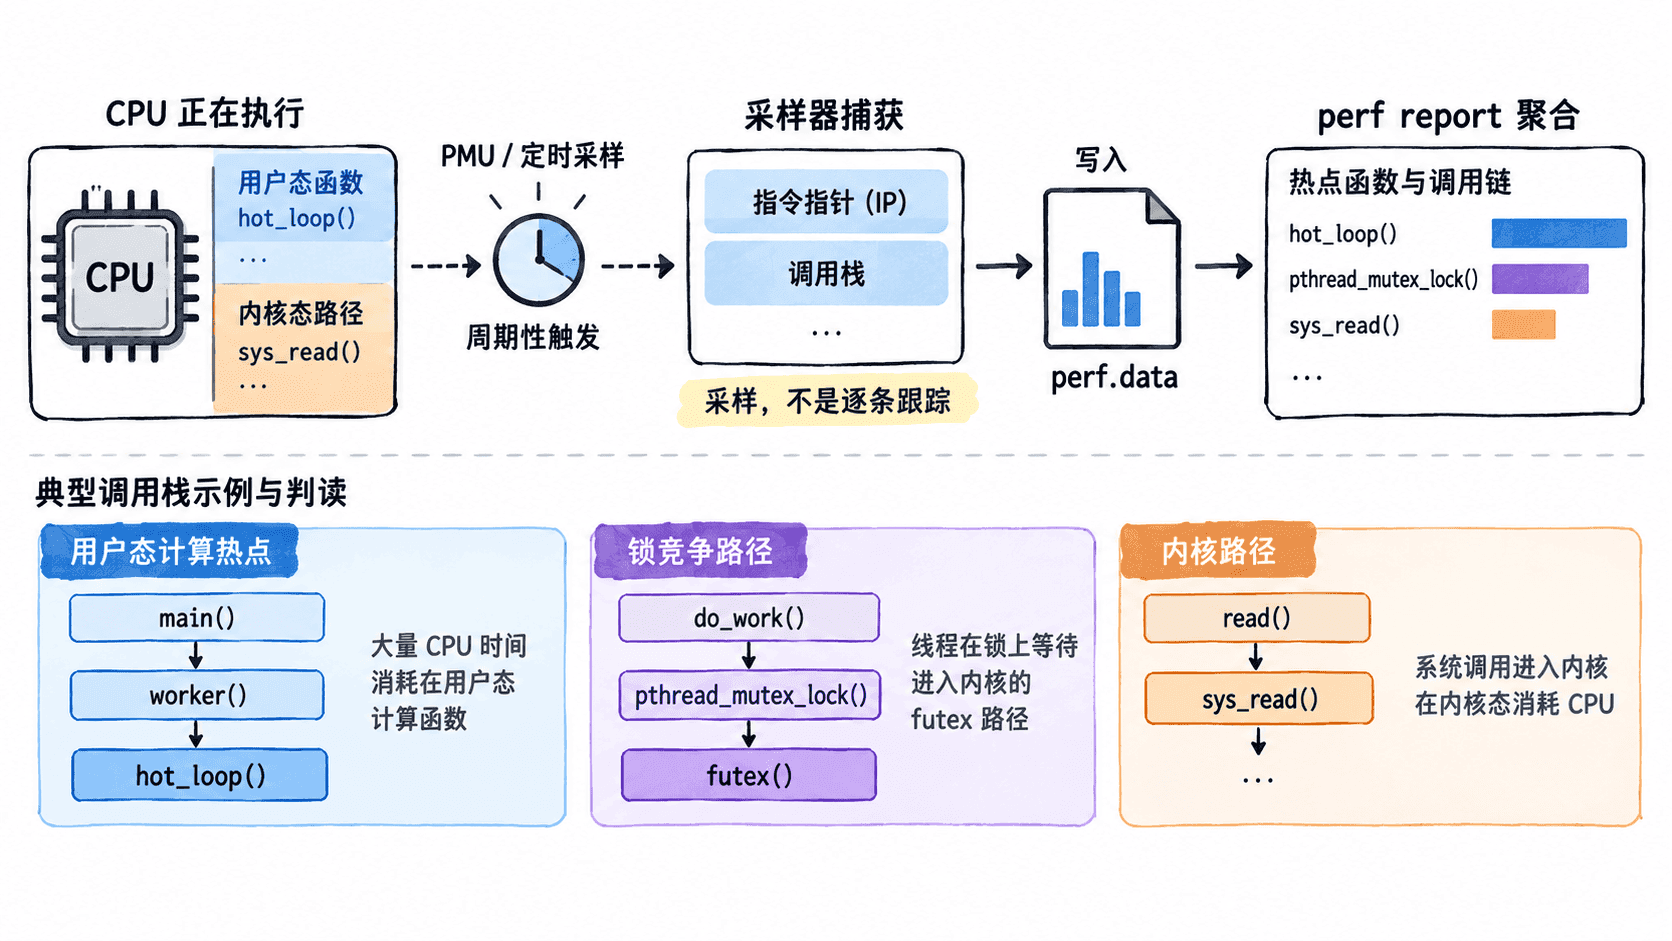
采样的优势是开销通常低于完整跟踪,适合回答“CPU 时间主要落在哪些函数”。代价是它是统计结果:短暂尖峰可能被漏采,百分比也会因采样事件、频率和运行时间不同而变化。因此要先保证采样窗口覆盖故障时段,再解释比例。
用调用栈判断瓶颈类型
仅看最热函数名容易误判。计算密集型程序通常会在业务函数、编解码、压缩、排序等用户态符号上积累大量样本;如果热点集中在 pthread_mutex_lock、futex 或自旋锁相关路径,说明 CPU 可能消耗在同步与争用;如果大量样本进入 read、write、网络协议栈或文件系统函数,则应继续追踪内核路径和 I/O 行为。
perf report 的 Children 视图能把子调用成本向父调用累计,适合找“哪条调用链把 CPU 带到热点”;Self 更接近函数自身消耗。优化前先确认你讨论的是哪一种比例,否则很容易把一个只是“调用热点函数很多次”的上层函数误判为真正耗时位置。
验证优化是否真的有效
找到热点后,先形成可验证假设,例如“循环计算占用过高”“锁竞争让多个线程反复进入 futex”或“内核协议栈消耗异常”。修改后必须在相近负载、相同采样事件和近似采样窗口下重新执行 perf record,比较热点占比、总运行时间和吞吐量。
如果某个函数占比下降但总耗时没有改善,成本可能只是迁移到了别处;如果锁函数占比下降同时吞吐提升,才说明同步优化产生了实际收益。perf 的价值不在于给出一个百分比,而在于把“CPU 很高”变成可重复采样、可定位调用链、可前后对比的证据。