
架构与系统设计 / 系统课时
用排队页平滑瞬时并发
用排队页平滑瞬时并发
当秒杀入口瞬时到达量远高于后端处理能力时,直接把所有请求送入下单链路只会迅速耗尽线程、连接和数据库资源。本节用排队、限速放行和状态轮询把尖峰摊平,让系统按自己能够承受的节奏处理请求。
学习目标
- 理解排队页为什么能够把瞬时并发转换为可控吞吐
- 设计等待、放行、超时和重复请求的基本处理链路
- 根据后端安全处理能力设置放行速率并验证削峰效果
排队页解决的是到达速率失配
假设入口一秒收到 10 万个请求,而库存与下单链路稳定只能处理每秒 5000 个请求。单纯扩充 Web 线程并不会增加数据库、缓存或库存服务的真实容量,反而会让更多请求同时占用连接和内存,最终把可恢复的拥塞变成级联故障。
排队页的核心不是让用户“多等一会”,而是把进入核心链路的速率限制在安全范围。入口先完成活动资格、基础风控等低成本判断,再为可继续参与的请求生成排队凭证。只有获得放行资格的请求才能进入库存与下单路径,其余请求停留在等待页或通过低频接口查询状态。
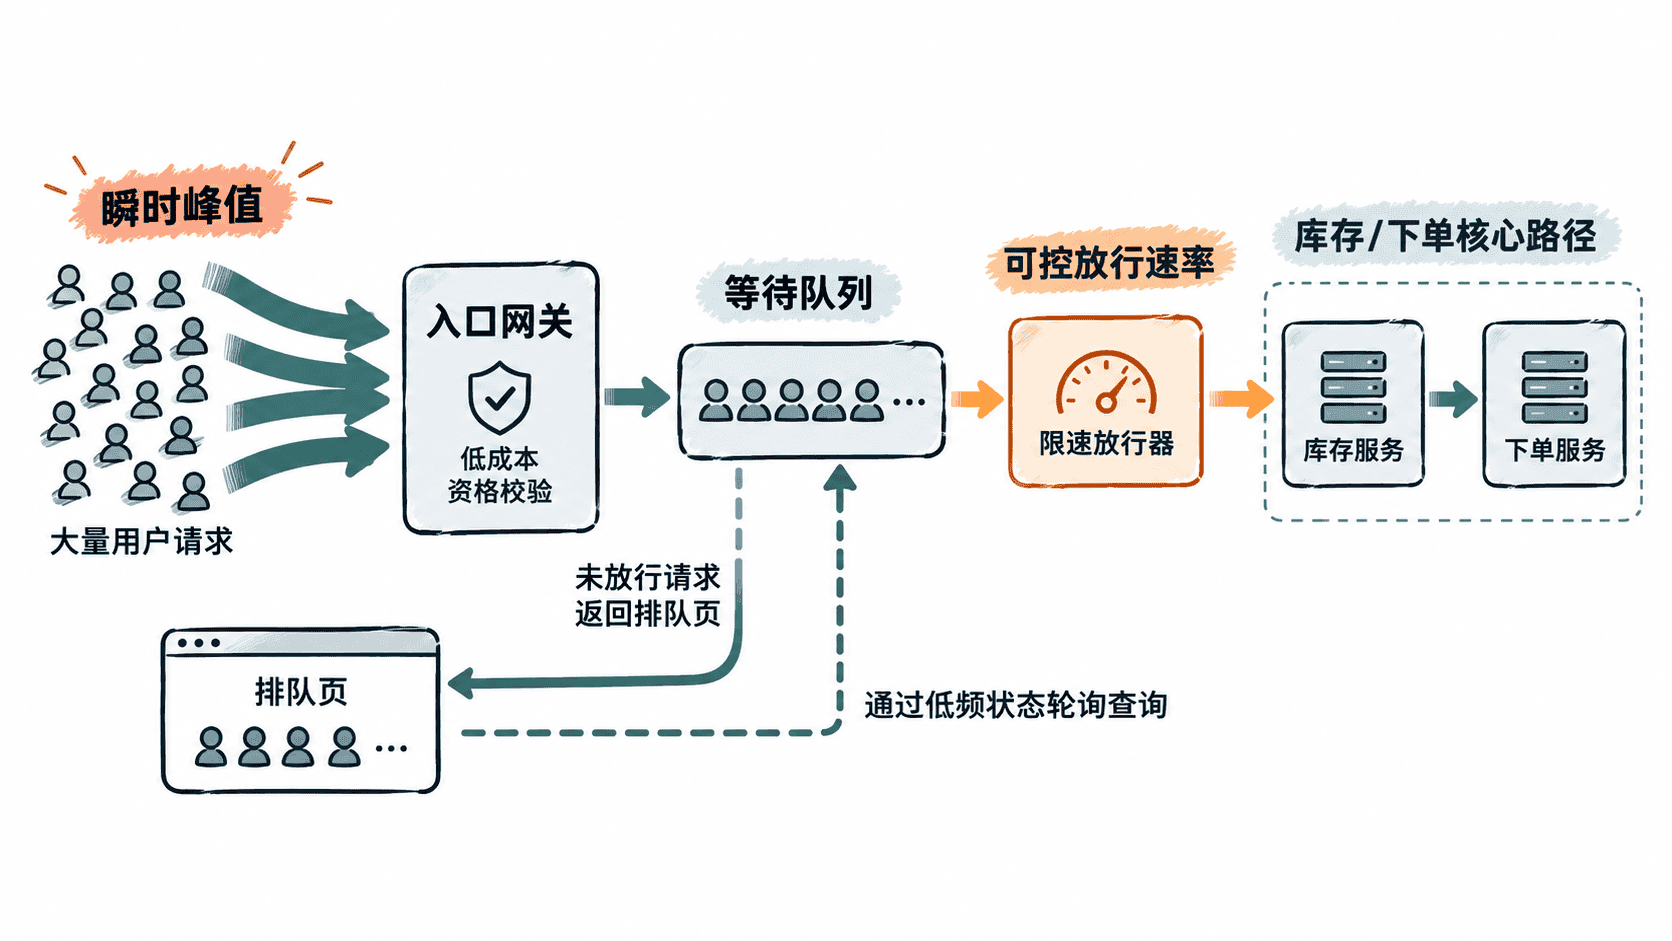
用放行速率约束核心链路
放行上限应来自核心链路已经验证过的安全吞吐,而不是入口理论并发。例如压测确认下单链路在每秒 5000 请求时仍有恢复余量,可以先把排队系统的放行速率设为更保守的每秒 4000~4500,再根据延迟、错误率和资源水位动态调整。
下面用一个最小程序模拟每个时间片最多放行 3 个请求。它没有实现分布式队列,只用于观察“到达很多、分批进入核心链路”的效果。
waiting = [f"user-{i}" for i in range(1, 9)]
release_per_tick = 3
tick = 1

while waiting:
    released = waiting[:release_per_tick]
    waiting = waiting[release_per_tick:]
    print(f"tick={tick} released={released} waiting={len(waiting)}")
    tick += 1
预期输出
tick=1 released=['user-1', 'user-2', 'user-3'] waiting=5
tick=2 released=['user-4', 'user-5', 'user-6'] waiting=2
tick=3 released=['user-7', 'user-8'] waiting=0
真实系统不能把等待队列只放在单个进程内存中。排队凭证、排队状态和放行结果需要能够跨实例识别,并且要为同一用户或同一请求设置稳定身份,避免刷新页面或重复轮询制造多个排队项。
把等待路径与核心路径隔离
排队页本身也可能成为新的热点,因此等待路径应尽量便宜。静态页面可以由 CDN 承载,状态查询接口只返回排队状态、预计等待区间或是否已放行等必要信息,不要在每次轮询时同步查询库存、订单和推荐服务。
轮询频率必须受控。服务端可以返回建议的下一次查询间隔,并对过快轮询继续限速。已经放行的凭证还应设置较短有效期,例如要求用户在限定时间内进入下单流程,超时后释放名额,避免大量“已放行但不行动”的请求占住处理窗口。
设计放行与退出规则
一个可上线的排队方案至少要明确四种结果:等待、放行、失败和过期。等待状态继续停留在低成本路径;放行状态获得一次性的进入凭证;活动结束、资格失效或队列达到上限时应尽快失败;长时间未获放行的请求则按超时策略退出。
放行速率也不宜只靠固定常量。可以根据核心链路的 P95/P99 延迟、错误率、数据库连接占用和库存服务负载逐级收紧。当核心指标持续恢复后再缓慢提高速率,给缓存、连接池和数据库留下恢复余量,而不是指标刚好转就一次性清空积压请求。
验收排队方案时,应确认入口峰值继续升高时,库存与下单链路的实际到达速率仍被限制在安全范围,同时等待接口本身没有产生新的高频数据库访问。做到这一点,排队才真正承担了削峰,而不是把拥塞从一个接口搬到了另一个接口。