
架构与系统设计 / 系统课时
隔离压测数据与生产数据
隔离压测数据与生产数据
生产压测只有穿过真实网关、服务、数据库和消息链路,才能暴露真实容量问题;但压测订单又不能扣减真实库存、触发真实支付或污染运营报表。本节建立一条从请求标识到存储、消息和下游消费的完整隔离链路,并用可执行示例验证生产数据保持不变。
学习目标
- 设计只能由可信压测入口写入并在服务间持续传播的压测标识
- 使用影子表、独立 Topic 和下游阻断共同隔离订单、库存、消息与支付
- 通过数据对账验证压测请求确实走完整链路且没有污染生产数据
隔离必须覆盖整条调用链
只给订单表增加一张影子表并不够。如果订单写入影子表,但库存仍扣生产库存、消息仍进入生产 Topic,最终依然会污染业务。隔离边界必须随着请求上下文传播到每一个有副作用的组件。
推荐把压测标识在可信入口转换成内部上下文,例如 loadTest=true。公网客户端提交的同名 Header 应先被网关删除,只有压测平台经过鉴权的请求才能获得内部标识,避免普通用户通过伪造 Header 进入影子链路。
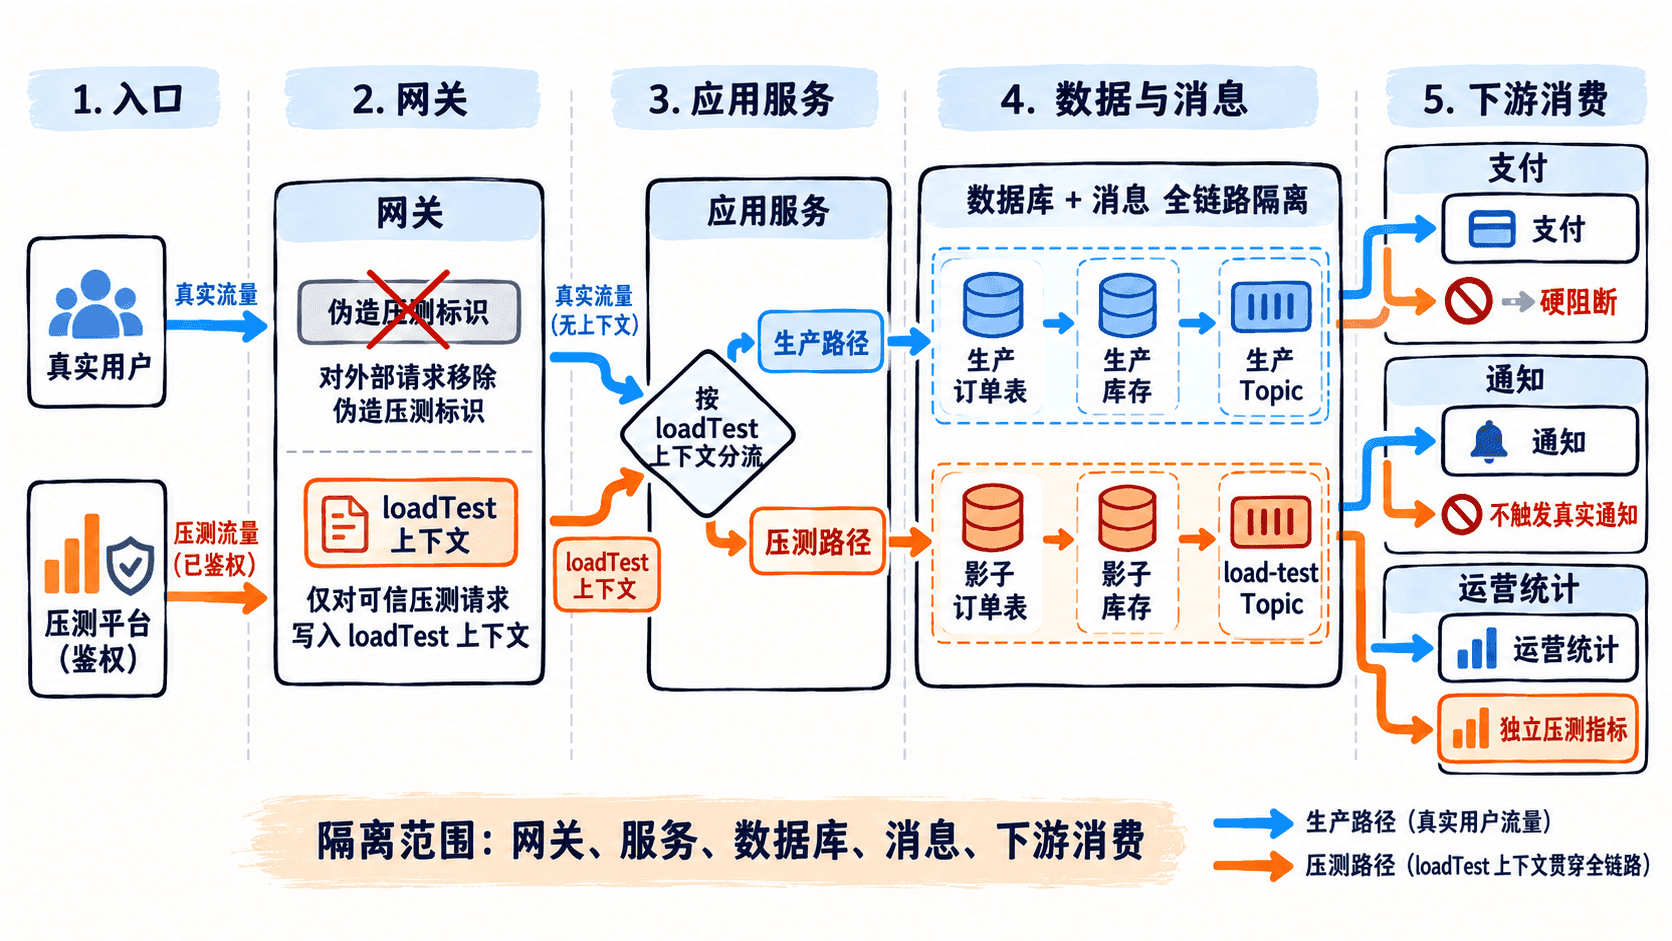
为不同副作用选择隔离方式
订单和库存这类强状态数据通常使用影子表、影子库或独立数据库。数据量较小、希望尽量复用生产数据库执行计划时,可以使用结构一致的影子表;如果需要验证数据库整体容量,则应提前评估影子表与生产表共享连接池、Buffer Pool 和磁盘带宽本身带来的压力是否正是测试目标。
消息系统更适合使用独立 Topic,例如生产写 flashsale-orders,压测写 flashsale-orders-loadtest。消费者也必须区分两条链路,否则仅在生产端换 Topic,却又让压测 Topic 被真实支付消费者订阅,隔离仍然失败。
真实支付、短信、外呼以及不可逆的第三方副作用不应依赖“测试订单金额为零”之类的软约定。压测上下文到达这些边界时应显式拒绝调用,或者切换到专用 Sandbox。
用影子库存验证路由
下面的 Python 程序用两个订单表、两份库存和两个 Topic 名称模拟生产与压测路由。示例只使用 Python 标准库,可以直接运行;真实系统应把相同的路由决策放在统一的数据访问层和消息发布层,而不是散落在业务代码中。
import sqlite3

conn = sqlite3.connect(':memory:')
conn.executescript('''
CREATE TABLE orders_prod (
    order_id TEXT PRIMARY KEY,
    sku TEXT NOT NULL
);
CREATE TABLE orders_shadow (
    order_id TEXT PRIMARY KEY,
    sku TEXT NOT NULL
);
CREATE TABLE inventory_prod (
    sku TEXT PRIMARY KEY,
    qty INTEGER NOT NULL
);
CREATE TABLE inventory_shadow (
    sku TEXT PRIMARY KEY,
    qty INTEGER NOT NULL
);
INSERT INTO inventory_prod VALUES ('sku-hot-1', 10);
INSERT INTO inventory_shadow VALUES ('sku-hot-1', 10);
''')


def route(load_test: bool):
    if load_test:
        return 'orders_shadow', 'inventory_shadow', 'flashsale-orders-loadtest'
    return 'orders_prod', 'inventory_prod', 'flashsale-orders'


def place_order(order_id: str, sku: str, load_test: bool):
    order_table, inventory_table, topic = route(load_test)

    # 库存和订单必须使用同一条路由决策,避免跨环境写入。
    cursor = conn.execute(
        f'UPDATE {inventory_table} SET qty = qty - 1 WHERE sku = ? AND qty > 0',
        (sku,),
    )
    if cursor.rowcount != 1:
        conn.rollback()
        return 'sold-out'

    conn.execute(
        f'INSERT INTO {order_table}(order_id, sku) VALUES (?, ?)',
        (order_id, sku),
    )
    conn.commit()

    # 压测请求到真实支付边界时必须硬阻断。
    payment = 'blocked' if load_test else 'enabled'
    return f'topic={topic} payment={payment}'


print(place_order('LT-1001', 'sku-hot-1', load_test=True))
print('prod_order_count=', conn.execute('SELECT COUNT(*) FROM orders_prod').fetchone()[0])
print('shadow_order_count=', conn.execute('SELECT COUNT(*) FROM orders_shadow').fetchone()[0])
print('prod_stock=', conn.execute("SELECT qty FROM inventory_prod WHERE sku='sku-hot-1'").fetchone()[0])
print('shadow_stock=', conn.execute("SELECT qty FROM inventory_shadow WHERE sku='sku-hot-1'").fetchone()[0])
运行程序:
python load_test_isolation.py预期输出
topic=flashsale-orders-loadtest payment=blocked
prod_order_count= 0
shadow_order_count= 1
prod_stock= 10
shadow_stock= 9
结果同时证明了三件事:压测订单进入影子表、库存只从影子库存扣减、消息被路由到压测 Topic,并且真实支付处于阻断状态。真实系统的验证也应该按这种方式跨组件对账,而不是只检查接口是否返回 200。
防止压测标识在中途丢失
最危险的问题不是路由代码不存在,而是调用链某一跳把标识丢掉。例如 HTTP 服务已经进入影子模式,但投递异步任务时没有把压测上下文写入消息属性,下游消费者就可能按生产请求处理。
因此压测标识应进入统一的请求上下文,并在 RPC Metadata、消息 Header 和异步任务参数中显式传播。消费者如果收到标记为压测的消息却找不到对应的影子资源,应该失败并告警,而不是默认回退到生产资源。
用对账作为压测前后的安全门
正式放量前先用极小流量发送几笔带唯一批次号的压测请求,确认影子订单、影子库存和压测 Topic 都出现对应记录,同时生产订单数、生产库存以及真实支付调用数没有变化。只有这一步通过,才逐步提高并发。
压测结束后再次按批次号核对影子数据,并检查生产库存变化是否只能由真实订单解释。如果压测指标已经结束但影子 Topic 仍存在大量积压,也应先清理或消费完成再关闭隔离能力,避免残留消息在后续配置变更时误入生产消费者。
生产压测真正可靠的标准不是“我们给请求加了一个测试 Header”,而是任何带压测上下文的请求在订单、库存、消息、支付和统计各层都有明确且可验证的去向,并且缺少隔离资源时默认失败。