
架构与系统设计 / 系统课时
用批量写削减持久化压力
用批量写削减持久化压力
高并发下,日志、流水和非关键派生数据如果逐条开启事务并写库,会把大量时间消耗在网络往返与事务提交上。本节把单条写入改成“数量阈值或时间阈值触发”的批量持久化,同时处理批次过大、事务回滚和重试重复写等工程风险。
学习目标
- 设计按数量与等待时间双阈值触发的批量写入机制
- 理解批量写如何减少事务提交与数据库网络往返
- 处理批次过大、整批失败和重试导致的写入放大问题
为什么逐条提交成本高
假设 1000 条流水都单独写入,每条都需要一次请求、一次事务提交,就会产生大量固定成本。批量写并不会减少最终需要持久化的数据量,它减少的是往返次数、提交次数以及数据库重复执行事务准备工作的次数。
适合批量化的通常是允许短暂延迟、能够重试的数据,例如操作日志、审计流水、统计明细和可重建的派生记录。库存扣减、余额变更等强实时核心状态不能因为“批量效率更高”就随意延后提交,它们首先要满足业务一致性要求。
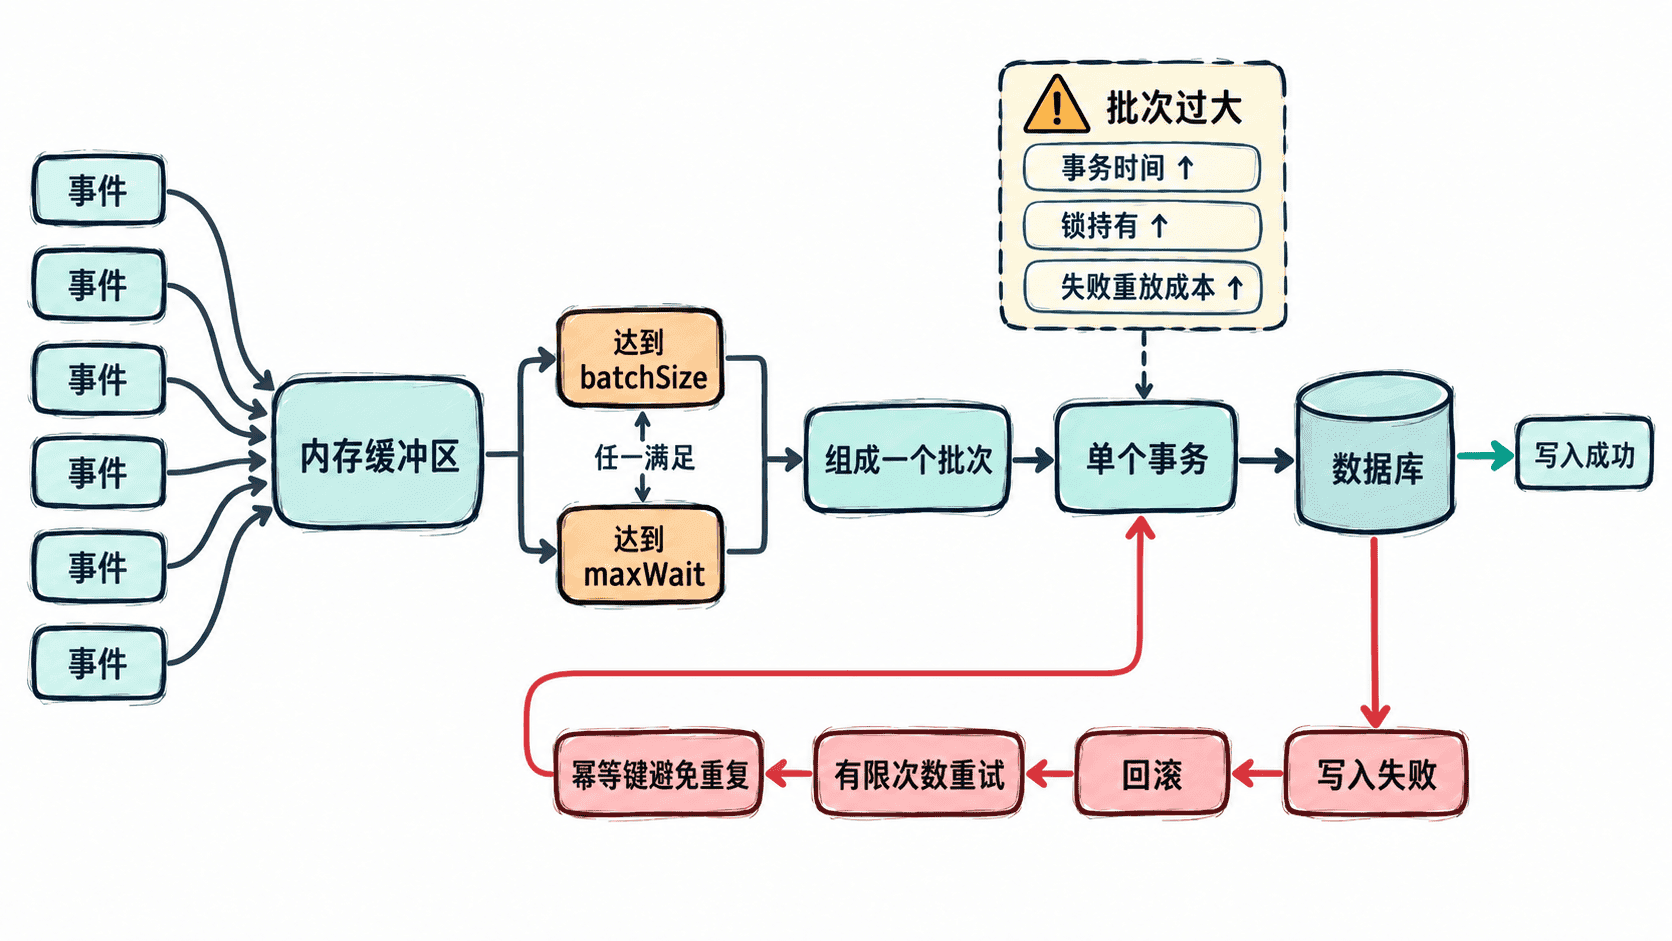
同时设置数量和时间阈值
只有数量阈值会在低流量时产生问题:如果批大小设为 500,而夜间只有几十条数据,最后一批可能长期留在内存。只有时间阈值又可能在峰值时形成过大的瞬时批次。因此通常同时设置两个条件,先满足哪个就按哪个刷新。
下面的 Python 示例使用内置 sqlite3 模拟批量写入。缓冲区累计 3 条时按数量刷新;不足 3 条但等待超过 0.5 秒时按时间刷新。所有记录通过一次 executemany 在同一个事务中提交。
import sqlite3
import time

class BatchWriter:
    def __init__(self, conn, batch_size=3, max_wait=0.5):
        self.conn = conn
        self.batch_size = batch_size
        self.max_wait = max_wait
        self.buffer = []
        self.last_flush = time.monotonic()

    def add(self, row):
        self.buffer.append(row)
        if len(self.buffer) >= self.batch_size:
            self.flush("count")

    def flush_due(self):
        if self.buffer and time.monotonic() - self.last_flush >= self.max_wait:
            self.flush("time")

    def flush(self, reason):
        rows = self.buffer
        self.buffer = []
        try:
            # 一个批次共用一次事务提交,主键让重复重试保持幂等。
            self.conn.executemany(
                "INSERT OR IGNORE INTO event_log(id, message) VALUES (?, ?)", rows
            )
            self.conn.commit()
            print(f"flush reason={reason} size={len(rows)}")
        except sqlite3.DatabaseError:
            self.conn.rollback()
            self.buffer = rows + self.buffer
            raise
        finally:
            self.last_flush = time.monotonic()

conn = sqlite3.connect(":memory:")
conn.execute("CREATE TABLE event_log(id INTEGER PRIMARY KEY, message TEXT NOT NULL)")
writer = BatchWriter(conn)

writer.add((1, "a"))
writer.add((2, "b"))
writer.add((3, "c"))
writer.add((4, "d"))
writer.add((5, "e"))
time.sleep(0.6)
writer.flush_due()

count = conn.execute("SELECT COUNT(*) FROM event_log").fetchone()[0]
print(f"rows={count}")
conn.close()
预期输出:
flush reason=count size=3
flush reason=time size=2
rows=5
这个示例中的 0.5 秒只是为了快速观察行为。生产配置应依据允许的持久化延迟、单批写入耗时、数据库吞吐以及进程异常时可接受的数据损失窗口确定。
批次不是越大越好
批量从 1 条提高到几十或几百条时,通常能明显摊薄提交和网络成本;继续无限增大则会出现新的问题。大事务会占用更多内存,持有锁更久,写入失败时需要重放更多数据,并可能让数据库日志、复制链路或单次请求包突然出现尖峰。
因此批大小应通过压测寻找收益开始变缓的位置,而不是直接追求最大值。监控时可以同时观察每秒写入条数、单批条数、批次执行耗时、事务提交耗时和失败率。如果批大小增加后吞吐几乎不再上升,但 P99 批次耗时和锁等待明显增长,就已经越过合适区间。
让失败重试保持幂等
批量写的危险不只是失败,而是“结果不确定”。例如应用发送 100 条后连接断开,它可能不知道数据库是否已经成功提交。如果不加保护就整批重试,已经成功的记录会再次写入,重试流量也会进一步放大数据库压力。
对于日志或流水,可以给每条业务记录分配稳定的事件 ID,并在数据库建立唯一约束。重试同一个批次时,让已存在的 ID 被忽略或执行幂等更新。示例中的 id INTEGER PRIMARY KEY 与 INSERT OR IGNORE 就承担了这个作用;其他数据库应使用其明确支持的唯一键和幂等写入语义,而不是依赖应用“记住上次写到了哪里”。
失败策略还应限制重试次数并设置退避。数据库持续过载时,无限立即重试会把一批失败写放大成多批新流量。超过重试上限的数据应进入可恢复的持久队列、失败表或死信通道,而不是永远堆在进程内存中。
验收批量写是否真的减压
改造前后应在相同写入量下比较,而不能只看接口更快。有效的批量写通常表现为事务提交次数和网络往返数明显下降,同时总写入吞吐提高;数据库 CPU、日志刷盘或连接占用至少有一项得到改善。
还要进行失败验证:在批次提交阶段主动制造数据库异常,确认事务不会留下半批不可解释的数据;恢复后重试同一事件 ID,确认不会产生重复流水;低流量下保持不足一个批次的数据,确认时间阈值最终会把它们刷新。只有吞吐收益、延迟边界和失败恢复三项同时成立,批量写才真正削减了持久化压力,而不是把压力推迟到更大的单次事务中。