
架构与系统设计 / 系统课时
演练 MySQL 抖动与连接耗尽
演练 MySQL 抖动与连接耗尽
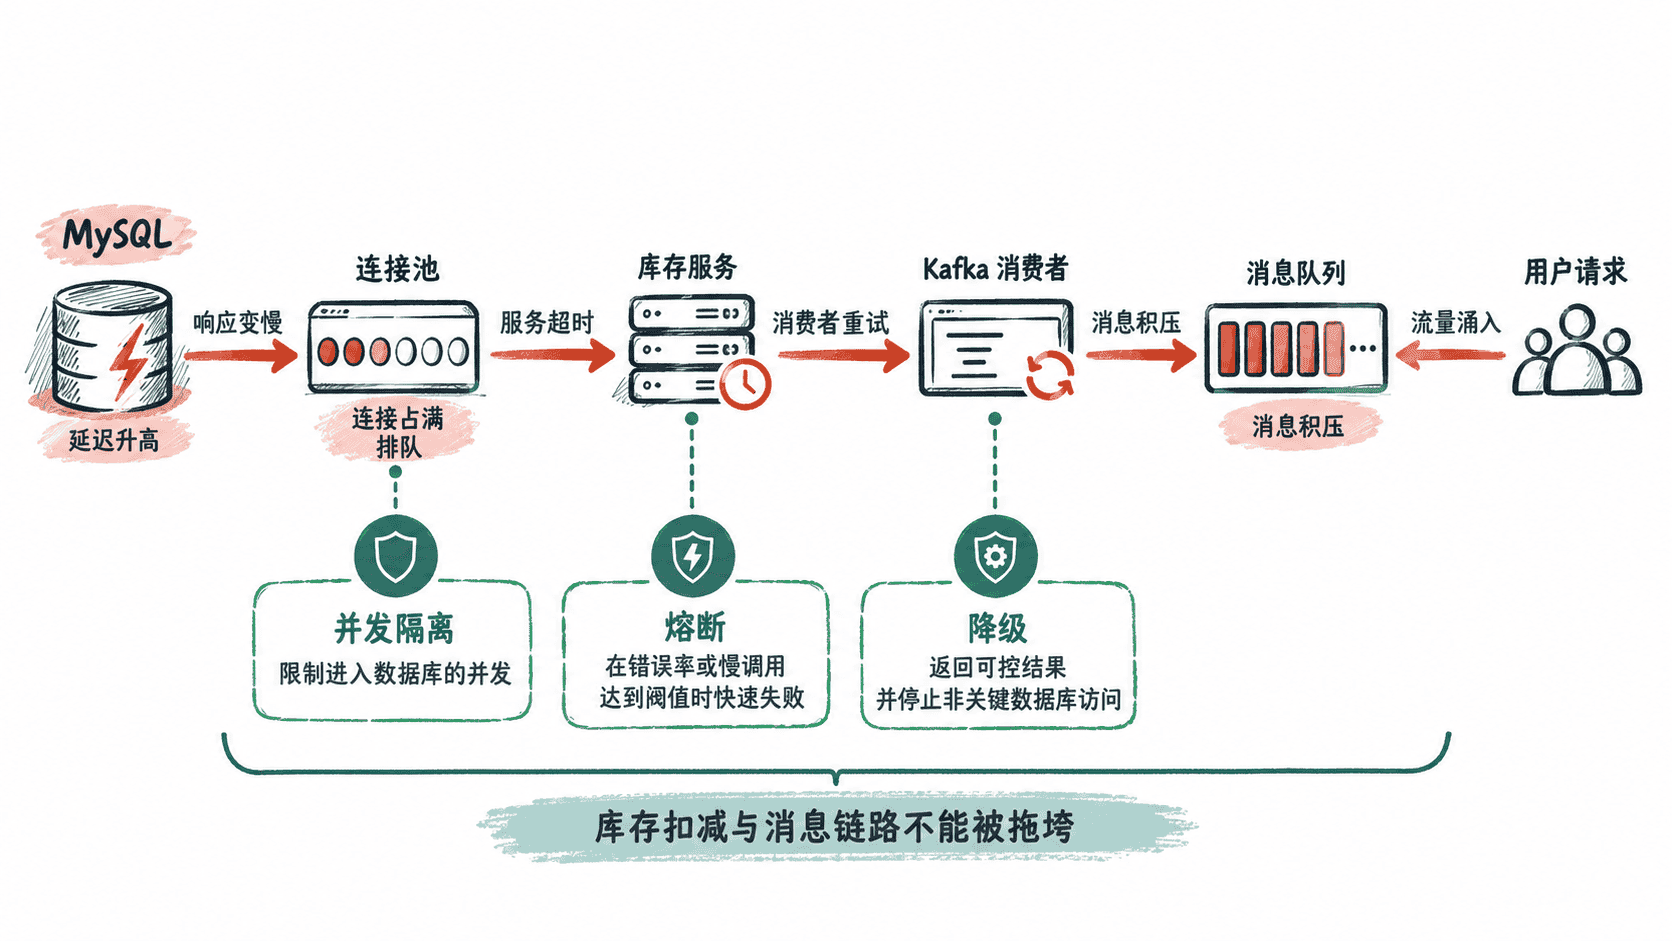
这次演练把数据库变慢和连接接近上限同时放大,观察请求如何从连接池排队扩散到服务超时、消费者重试与消息积压,并验证并发隔离、熔断和降级是否能把故障截在库存与订单链路之外。
学习目标
- 用可回滚的方式制造 MySQL 慢查询与连接压力,并观察关键指标变化
- 按“数据库 → 连接池 → 服务 → 消费者 → 消息队列”的顺序定位故障扩散
- 验证并发隔离、熔断与降级是否真正减少超时和重试放大
先定义演练边界
只在测试环境执行。演练前先记录数据库连接上限、应用连接池大小、接口超时、消费者并发数与重试策略,并准备一条无需访问 MySQL 的降级路径,例如直接返回“活动繁忙,请稍后重试”。
这类故障不是单点问题。MySQL 响应变慢后,应用连接占用时间拉长,连接池可用连接下降,请求开始排队;如果服务超时短于数据库实际完成时间,前端和消费者还会重试,反而继续增加数据库压力。
制造连接压力并观察数据库
下面的命令会暂时把测试库连接上限降到 20,并启动 30 个最多持有 20 秒的连接。需要具备测试库管理权限,并已配置 MYSQL_HOST、MYSQL_USER、MYSQL_PWD。脚本会在测试连接结束后恢复原值。
ORIGINAL_MAX=$(mysql -h "$MYSQL_HOST" -u "$MYSQL_USER" -Nse "SELECT @@GLOBAL.max_connections;")
mysql -h "$MYSQL_HOST" -u "$MYSQL_USER" -e "SET GLOBAL max_connections = 20;"
for i in $(seq 1 30); do
  mysql -h "$MYSQL_HOST" -u "$MYSQL_USER" -e "SELECT CONNECTION_ID(), SLEEP(20);" >"/tmp/mysql-hold-$i.log" 2>&1 &
done
sleep 2
mysql -h "$MYSQL_HOST" -u "$MYSQL_USER" -e "SHOW STATUS LIKE 'Threads_connected'; SHOW STATUS LIKE 'Threads_running';" || true
wait
mysql -h "$MYSQL_HOST" -u "$MYSQL_USER" -e "SET GLOBAL max_connections = $ORIGINAL_MAX;"
grep -h "Too many connections" /tmp/mysql-hold-*.log | head || true
预期输出
Variable_name     Value
Threads_connected <COUNT>
Variable_name     Value
Threads_running   <COUNT>
ERROR 1040 (HY000): Too many connections
<COUNT> 会随环境变化;若监控连接本身也被拒绝,统计行可能缺失,但测试客户端日志应出现 Too many connections。连接数逼近 20 或出现拒绝连接,都说明连接耗尽场景已经建立。
仅连接数升高还不够说明数据库自身繁忙。若 Threads_connected 很高而 Threads_running 很低,更多时候表示连接被长事务、慢 I/O 或客户端等待占住;两者都高,则更像数据库正在同时执行大量工作。
沿故障链定位放大点
定位时不要先改参数,而是按链路顺序找第一个发生明显变化的位置。数据库侧先看连接数、活跃线程、慢查询和事务等待;连接池侧看 active、idle、pending 与获取连接耗时;服务侧看接口 P95/P99、超时率和熔断状态;消费者侧看处理时延、重试次数和 lag。
如果数据库只慢 800 ms,而接口在 1 s 超时、客户端立即重试三次,那么一次原始请求可能在数据库中变成多次并发工作。此时单纯把连接池从 50 扩到 200,通常只是允许更多请求同时压进 MySQL,并没有消除根因。
用时间关系判断是否是连接池排队
记录一次失败请求的三个时间点:进入服务、拿到数据库连接、SQL 返回。若主要时间耗在“进入服务 → 拿到连接”,根因偏向连接池耗尽;若连接很快拿到,但“执行 SQL → 返回”变长,则继续查 MySQL 锁等待、磁盘与慢查询。
验证隔离、熔断和降级
保护措施是否有效,要看它们能否减少进入数据库的并发,而不是只看错误信息是否更友好。先保持相同压测流量,依次启用数据库并发隔离、慢调用熔断和降级,再比较数据库连接峰值、请求超时数、消费者重试数与 Kafka lag。
一个合格结果应满足:保护开启后,数据库连接不再长期贴近上限;库存核心路径仍有可用连接;非关键查询能快速失败或走缓存;消费者不会因为数据库超时形成重试风暴;消息积压即使上升,也能在故障解除后稳定回落。
演练后的恢复与复盘
恢复时先停止故障注入,再确认连接池 pending 归零、MySQL 连接数回落、消费者 lag 持续下降,最后再逐步解除降级。若一解除保护连接数就再次冲高,说明根因仍在,不能把“演练脚本已停止”当成系统已恢复。
复盘应保留四组证据:故障注入时间、第一处指标异常时间、保护措施生效时间、业务恢复时间。只有能证明保护机制让数据库压力下降、库存主链路继续可用、消息没有被无限重试放大,这次演练才算通过。