
架构与系统设计 / 系统课时
用容量模型估算系统上限
用容量模型估算系统上限
秒杀容量规划不是把峰值 QPS 平均分给机器,而是把同一波流量沿入口、应用、缓存、消息和数据库逐层换算,结合单节点实测能力与安全利用率,提前找出最先触顶的层级。
学习目标
- 把业务峰值换算成各层实际请求量与操作量。
- 用单节点实测吞吐和安全利用率估算所需实例数。
- 用并发数与余量交叉校验模型,并识别第一瓶颈。
把业务目标换成容量变量
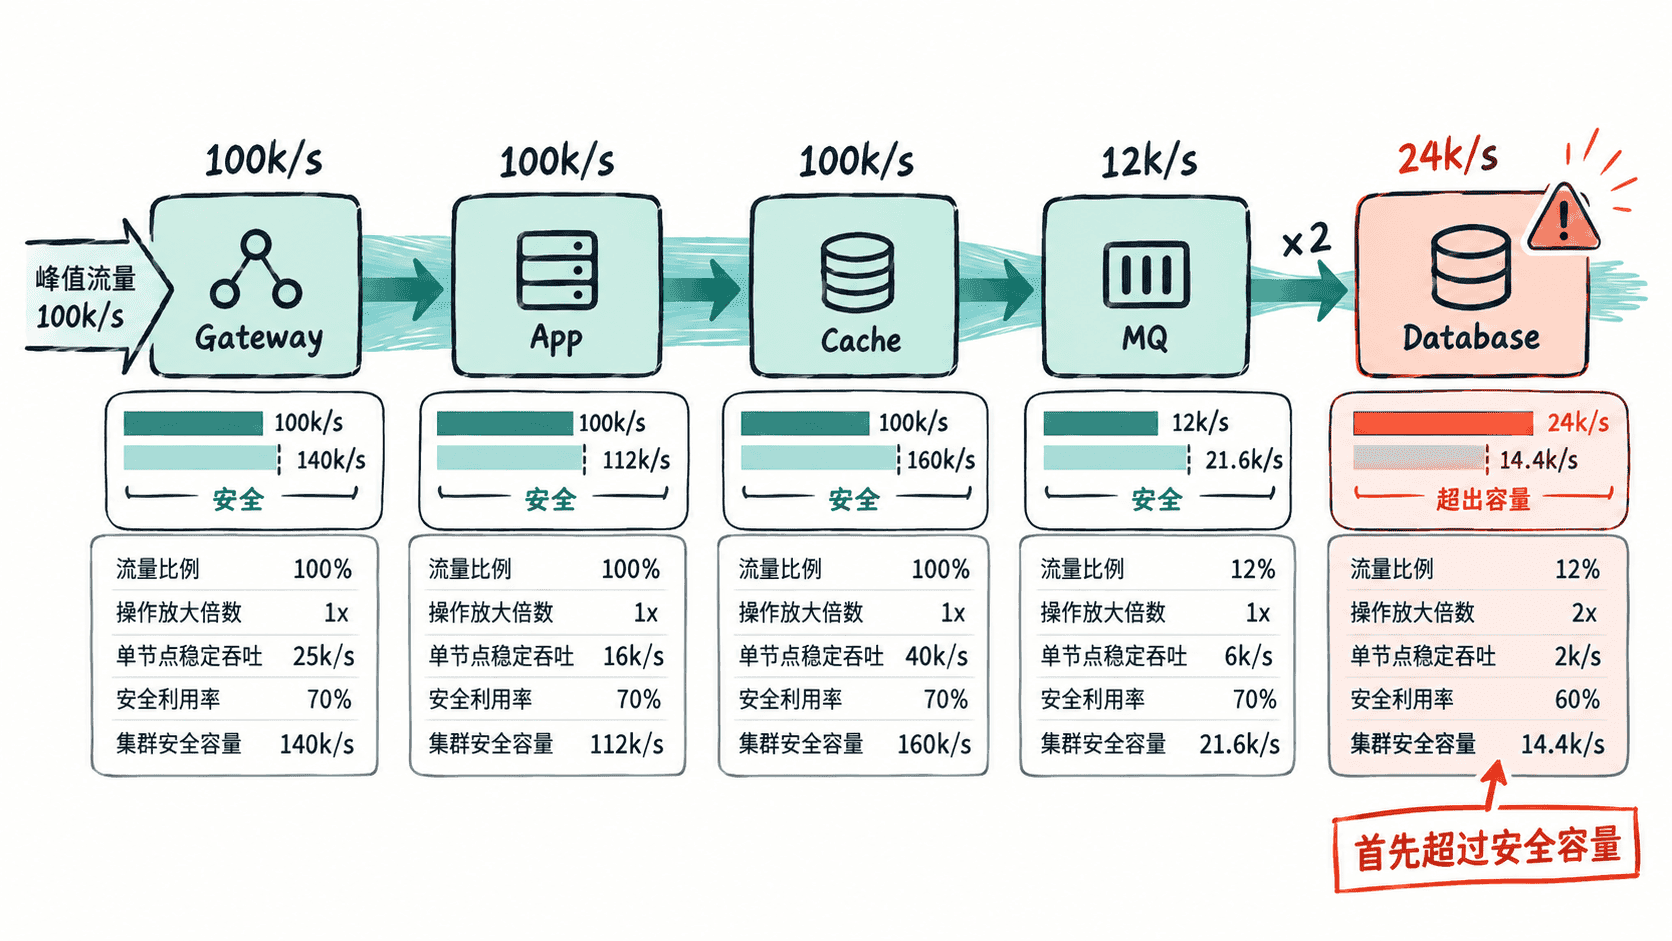
先固定一个可验证的峰值目标,例如活动入口预计达到 120000 QPS。这个数字不能直接套到所有组件,因为请求会被静态化、过滤、缓存命中和异步化。对每一层至少记录四个变量:流量比例 r、单请求放大倍数 a、单节点稳定吞吐 C 和安全利用率 u。
所需节点数可以写成:
其中 Q 是入口峰值。C 应来自压测中持续稳定的吞吐,而不是实验室瞬时峰值;u 则给 GC、抖动、热点和故障切换留余量。缓存层若一次请求会产生多次读写,必须通过 a 把这些操作放大计入。
用一个模型逐层估算
下面的 Python 示例把入口峰值按各层比例和操作放大倍数换算,并同时比较“理论所需节点数”和“当前部署节点的安全容量”。示例中的单节点吞吐只是演示值,实际项目必须替换为自己的压测结果。
from math import ceil

peak_qps = 120_000

# name, traffic_ratio, amplification, single_node_qps, safe_utilization, deployed
layers = [
    ("gateway", 1.00, 1.00, 30_000, 0.65, 8),
    ("app",     0.35, 1.00, 12_000, 0.65, 6),
    ("cache",   0.35, 1.40, 50_000, 0.65, 2),
    ("mq",      0.08, 1.00, 20_000, 0.65, 2),
    ("db",      0.02, 1.00,  1_800, 0.60, 2),
]

print("layer     load  safe_capacity required deployed status")
for name, ratio, amp, single, util, deployed in layers:
    load = peak_qps * ratio * amp
    safe_per_node = single * util
    required = ceil(load / safe_per_node)
    cluster_capacity = deployed * safe_per_node
    status = "OVER" if load > cluster_capacity else "OK"
    print(
        f"{name:8s} {load:8.0f} {cluster_capacity:14.0f} "
        f"{required:8d} {deployed:8d} {status}"
    )
预期输出
layer     load  safe_capacity required deployed status
gateway    120000         156000        7        8 OK
app         42000          46800        6        6 OK
cache       58800          65000        2        2 OK
mq           9600          26000        1        2 OK
db           2400           2160        3        2 OVER
结果说明数据库在 60% 安全利用率下需要 3 个节点,而当前只有 2 个,因此即使入口和缓存看起来还有余量,数据库仍会先进入不安全区。这个结论还不是扩容指令;它先告诉你压测和优化应该优先验证哪一层。
从并发数校验应用侧
吞吐模型还要用并发关系交叉校验。按照 Little 定律,系统中的平均并发约为 。如果应用层实际进入 42000 QPS,而一次请求平均占用应用线程 40 ms,那么仅这些在途请求就约有 1680 个并发。
这意味着应用实例虽然按 QPS 计算需要 6 台,但线程池、连接池和下游连接上限也必须容纳相同量级的在途请求。服务时间一旦从 40 ms 抖到 120 ms,并发需求会变成约 5040;QPS 不变,线程和连接仍可能先耗尽。
找出最先触顶的层
判断第一瓶颈时,不只看节点数量,还要比较“峰值负载 ÷ 安全集群容量”。比值越接近或超过 1,越需要优先验证。对数据库还要单独检查写 IOPS、事务锁、连接数和主从复制延迟;对缓存要看热点 Key、网络带宽和单线程 CPU;对消息系统要看生产、消费和积压恢复速度。
容量模型最有价值的输出不是一个总 QPS,而是一张逐层预算表。每次改变缓存命中率、异步比例、业务规则或实例规格,都重新计算这些比例和单节点能力,再用压测验证。只有入口到数据库的每一层都留有可解释的余量,秒杀峰值才真正处在可控范围内。