
架构与系统设计 / 系统课时
控制重试与死信避免放大故障
控制重试与死信避免放大故障
消息消费失败时,最危险的做法不是“不重试”,而是所有错误都立即重试。本课把失败按可恢复性分类,并用退避、最大次数和死信通道把重试流量限制在可控范围内,让坏消息退出主消费链路。
学习目标
- 区分网络抖动、数据库繁忙和业务校验失败的处理方式
- 用指数退避与最大重试次数限制失败请求的放大倍数
- 设计死信通道,使异常消息可追踪且不阻塞正常消费
先按可恢复性分类失败
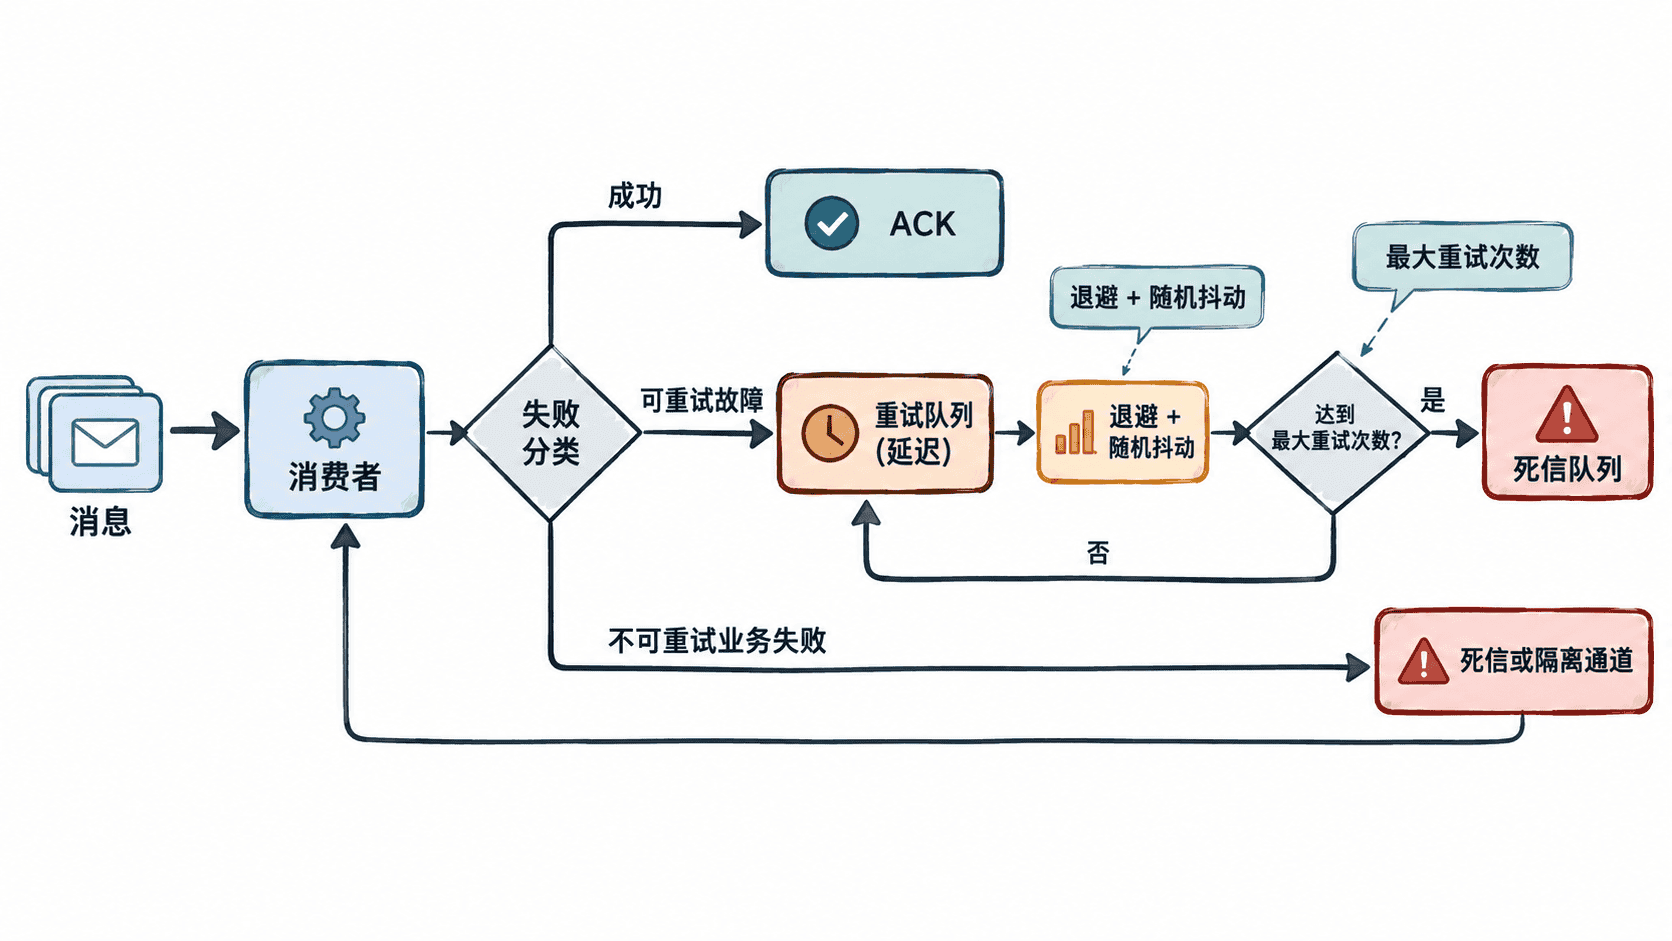
重试的前提是“同一操作稍后再做可能成功”。网络超时、连接短暂中断、数据库锁等待或瞬时限流通常属于可恢复故障;参数非法、库存规则不满足、订单状态冲突等业务校验失败,如果输入不变,重复执行也不会成功。
| 失败类型 | 是否自动重试 | 推荐动作 |
|---|---|---|
| 网络抖动、短暂超时 | 是 | 退避后重试,并限制次数 |
| 数据库繁忙、瞬时锁冲突 | 是 | 较慢退避,观察数据库压力 |
| 业务校验失败、不可修复数据 | 否 | 记录原因后进入死信或隔离通道 |
因此,消费者捕获异常后不要只判断“成功或失败”,而要把异常映射成可重试、不可重试和系统未知三类。未知异常可以采用保守的小次数重试,但超过边界必须退出主链路。
给重试设置时间和次数边界
立即重试会在下游最忙时继续施压,形成“失败越多,额外请求越多”的正反馈。常见做法是让第 1、2、3 次重试间隔逐步拉长,并设置最大延迟;多个消费者还应加入少量随机抖动,避免同一批失败消息在完全相同的时间再次冲击数据库。
最大次数同样必须明确。达到上限后继续循环没有恢复价值,只会长期占用消费线程、连接池和队列容量。此时应确认消息、停止本地重试,并把消息及失败上下文送入死信通道。
用可运行示例验证策略
下面的 Python 示例只演示决策逻辑:业务失败直接进入死信;暂时性故障按指数退避重试;达到最大次数后停止放大请求。
from dataclasses import dataclass
from enum import Enum

class FailureKind(Enum):
    NETWORK = "network"
    DATABASE_BUSY = "database_busy"
    BUSINESS_INVALID = "business_invalid"

@dataclass
class Case:
    name: str
    kind: FailureKind
    attempt: int

MAX_RETRIES = 3
BASE_DELAY_SECONDS = 2

def decide(case: Case) -> str:
    # 输入不变就不会成功的业务错误,不进入自动重试。
    if case.kind is FailureKind.BUSINESS_INVALID:
        return "dead_letter"

    # 达到上限后退出主链路,避免无限重试。
    if case.attempt >= MAX_RETRIES:
        return "dead_letter"

    # 暂时性故障按 2、4、8 秒退避;生产环境还应增加随机抖动。
    delay = BASE_DELAY_SECONDS * (2 ** case.attempt)
    return f"retry in {delay}s"

cases = [
    Case("network timeout", FailureKind.NETWORK, 0),
    Case("database busy", FailureKind.DATABASE_BUSY, 2),
    Case("database busy exhausted", FailureKind.DATABASE_BUSY, 3),
    Case("business rejected", FailureKind.BUSINESS_INVALID, 0),
]

for case in cases:
    print(f"{case.name}: {decide(case)}")
预期输出:
network timeout: retry in 2s
database busy: retry in 8s
database busy exhausted: dead_letter
business rejected: dead_letter
生产实现还需要把“第几次尝试”放在消息头或独立重试记录中,避免消费者重启后次数丢失。若消息系统提供延迟消息、重试主题或死信队列,应优先使用其原生能力,不要用消费线程 sleep 长时间占住并发槽位。
让死信可处理而不是只堆积
死信记录至少应保留原消息标识、失败分类、最近错误、累计重试次数和来源队列,便于人工或自动修复。重新投递前必须先解决根因,并保持原有幂等键;否则“从死信恢复”可能把同一订单执行两次。
验证策略是否生效时,至少同时观察主队列消费成功率、重试速率、死信速率和下游错误率。正常情况下,暂时性故障会产生有限的重试峰值并逐渐回落,而单条坏消息不会反复占用主消费通道。