
架构与系统设计 / 系统课时
按用户和接口实施分层限流
按用户和接口实施分层限流
秒杀限流不能只放一个“每秒 N 个请求”的总开关,因为公平性、接口容量、单实例安全线和活动总预算属于不同约束。分层限流的目标是让每一层只承担一种保护职责,并在允许短时突发的同时把进入核心链路的总量控制在可承受范围内。
学习目标
- 为用户、接口、活动和服务实例分别设置限流边界,并理解各层的责任。
- 根据是否允许突发和是否需要平滑输出,选择令牌桶或漏桶。
- 处理多实例下的全局配额一致性,并避免共享限流器成为新的热点。
把配额放在正确的层
单用户限流解决公平性,例如限制同一用户连续点击;接口级限流保护某个入口的总处理能力;活动级限流约束整个秒杀进入下游的最大吞吐;实例级限流则是最后一道本地熔断线,防止某台机器因热点、GC 或下游变慢而被拖死。
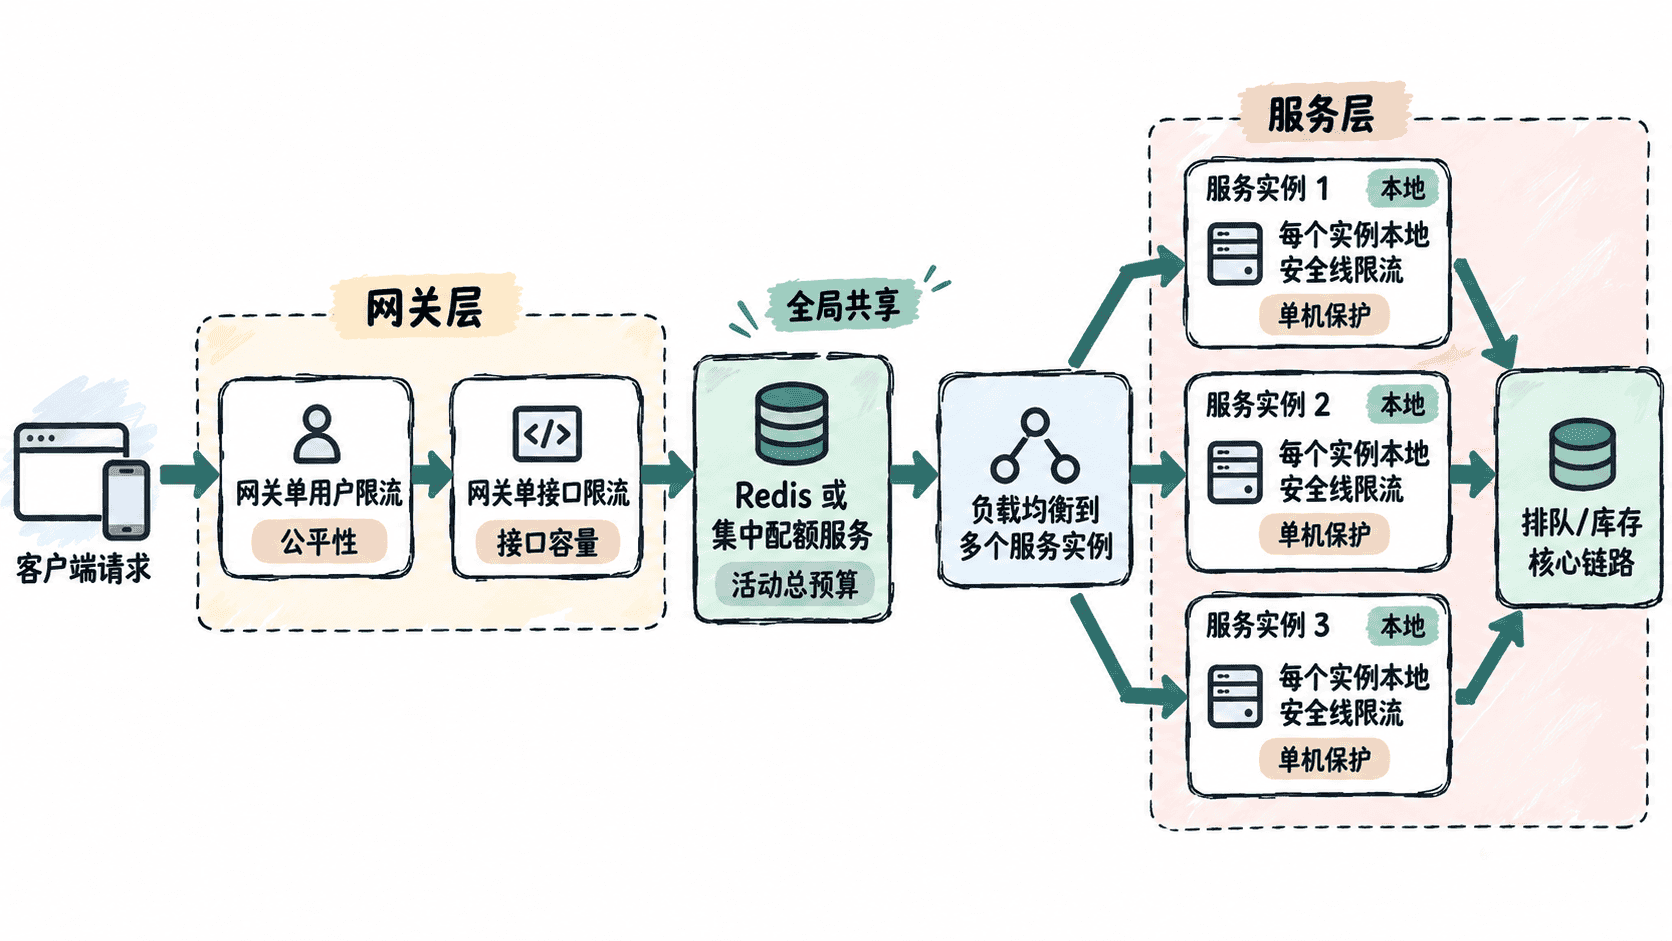
请求路径中越靠前的限流越能节省后端成本,因此用户和接口配额通常放在网关;活动总预算需要跨网关实例共享;实例安全线只能由本机掌握,因为它反映本机线程池、事件循环或连接池的即时承载能力。
| 层级 | 典型键 | 主要目的 | 是否要求全局一致 |
|---|---|---|---|
| 用户 | user:<uid>:purchase |
抑制重复点击和脚本刷单 | 通常需要 |
| 接口 | api:purchase |
控制入口总 QPS | 视网关架构而定 |
| 活动 | campaign:<id> |
保护库存、队列和数据库预算 | 需要 |
| 实例 | instance:<id> |
防止单机过载 | 不需要 |
令牌桶与漏桶怎么选
令牌桶以速率 持续补充令牌,桶容量 决定最多允许多大的瞬时突发。只要桶里有令牌,请求就能立即通过,因此很适合秒杀入口:可以容纳受控突发,又不会长期超过平均速率。
漏桶更强调以近似固定速率向下游输出。它适合“必须平滑”的场景,例如消费者按稳定速度写数据库;如果桶满,新请求要么排队等待,要么被丢弃。对用户点击入口直接使用严格漏桶,常会把拒绝问题变成排队延迟问题。
因此常见组合是:入口用令牌桶做有界突发准入,进入队列后再由固定消费速率实现类似漏桶的平滑效果。这样既保留活动开始瞬间的吞吐弹性,也不会把峰值原样传给数据库。
可运行的分层限流示例
下面用确定性时钟模拟四层令牌桶。为便于观察结果,活动总桶设置得最紧;生产环境中用户和活动桶通常位于共享存储,实例桶则保留在本地。
from dataclasses import dataclass

@dataclass
class TokenBucket:
    capacity: float
    rate: float
    tokens: float
    updated_at: float

    def take(self, now: float) -> bool:
        elapsed = max(0.0, now - self.updated_at)
        self.tokens = min(self.capacity, self.tokens + elapsed * self.rate)
        self.updated_at = now
        if self.tokens < 1.0:
            return False
        self.tokens -= 1.0
        return True

class LayeredLimiter:
    def __init__(self):
        self.users = {}
        self.api = TokenBucket(10, 2, 10, 0)
        self.campaign = TokenBucket(3, 1, 3, 0)
        self.instance = TokenBucket(10, 2, 10, 0)

    def allow(self, uid: str, now: float) -> str:
        user = self.users.setdefault(uid, TokenBucket(2, 0.5, 2, now))
        checks = [
            ("user", user),
            ("api", self.api),
            ("campaign", self.campaign),
            ("instance", self.instance),
        ]
        # 先失败就立即返回,避免继续消耗后续层资源。
        for name, bucket in checks:
            if not bucket.take(now):
                return f"rejected:{name}"
        return "accepted"

limiter = LayeredLimiter()
for uid, now in [("u1", 0), ("u1", 0), ("u1", 0), ("u2", 0), ("u3", 0), ("u2", 2)]:
    print(uid, now, limiter.allow(uid, now))
预期输出:
u1 0 accepted
u1 0 accepted
u1 0 rejected:user
u2 0 accepted
u3 0 rejected:campaign
u2 2 accepted
示例在 u1 的第三次请求处命中用户限流;随后 u2 用完第三个活动令牌,u3 因活动总桶为空被拒绝。到第 2 秒时,活动桶按每秒 1 个令牌补充,因此再次允许请求。真实系统中的 <TIME>、用户 ID、实例 ID 和配额会随部署变化。
这个演示按层顺序扣减令牌,因此若后层拒绝,前层已经扣掉的令牌不会回滚,这是保守但简单的做法。若用户层和活动层都放在同一个 Redis 中,并且希望避免部分扣减,可以把多层判断和扣减放进同一个 Lua 脚本原子执行。
多实例下不要平均切配额
把活动总 QPS 简单除以实例数,再让每台机器各自限流,看起来没有共享存储开销,但扩缩容、实例故障和流量倾斜都会让实际总量偏离目标。需要“全局总预算”时,应让多个入口通过 Redis Lua、集中配额服务或其他原子机制竞争同一个逻辑桶。
如果共享桶的访问量本身过高,可以给实例批量租用一小段配额,再在本地消耗;租约越大,共享存储压力越小,但未使用配额也越容易被暂时占住。配额租约因此适合允许少量误差的保护线,不适合库存只剩几十件时充当最终售卖正确性机制。
实例级安全线则应保持本地,且略低于单机压测得到的失稳点。当实例开始变慢时,本地层可以先拒绝请求,而不是等全局桶耗尽后让这台机器继续恶化。最终限流参数应来自压测和下游容量,而不是从活动目标 QPS 倒推一个看似整齐的数字。