
架构与系统设计 / 系统课时
演练 Kafka 积压与节点故障
演练 Kafka 积压与节点故障
这次演练验证的是:当秒杀订单事件消费变慢、分区 lag 持续上升或 Kafka 节点不可用时,生产端、消费者和入口限流能否协同收缩,而不是让消息积压无限增长。完成后,你会得到一套从制造积压、观察故障到联动限流和恢复验收的闭环方法。
学习目标
- 制造消费者暂停或变慢,读取 consumer group 的分区 lag 并判断积压趋势。
- 检查生产端超时、重试与消费者恢复是否造成长时间阻塞或故障放大。
- 验证入口限流能够随 lag 水位收紧,并在积压下降后平滑恢复。
先确定要观察的四条线
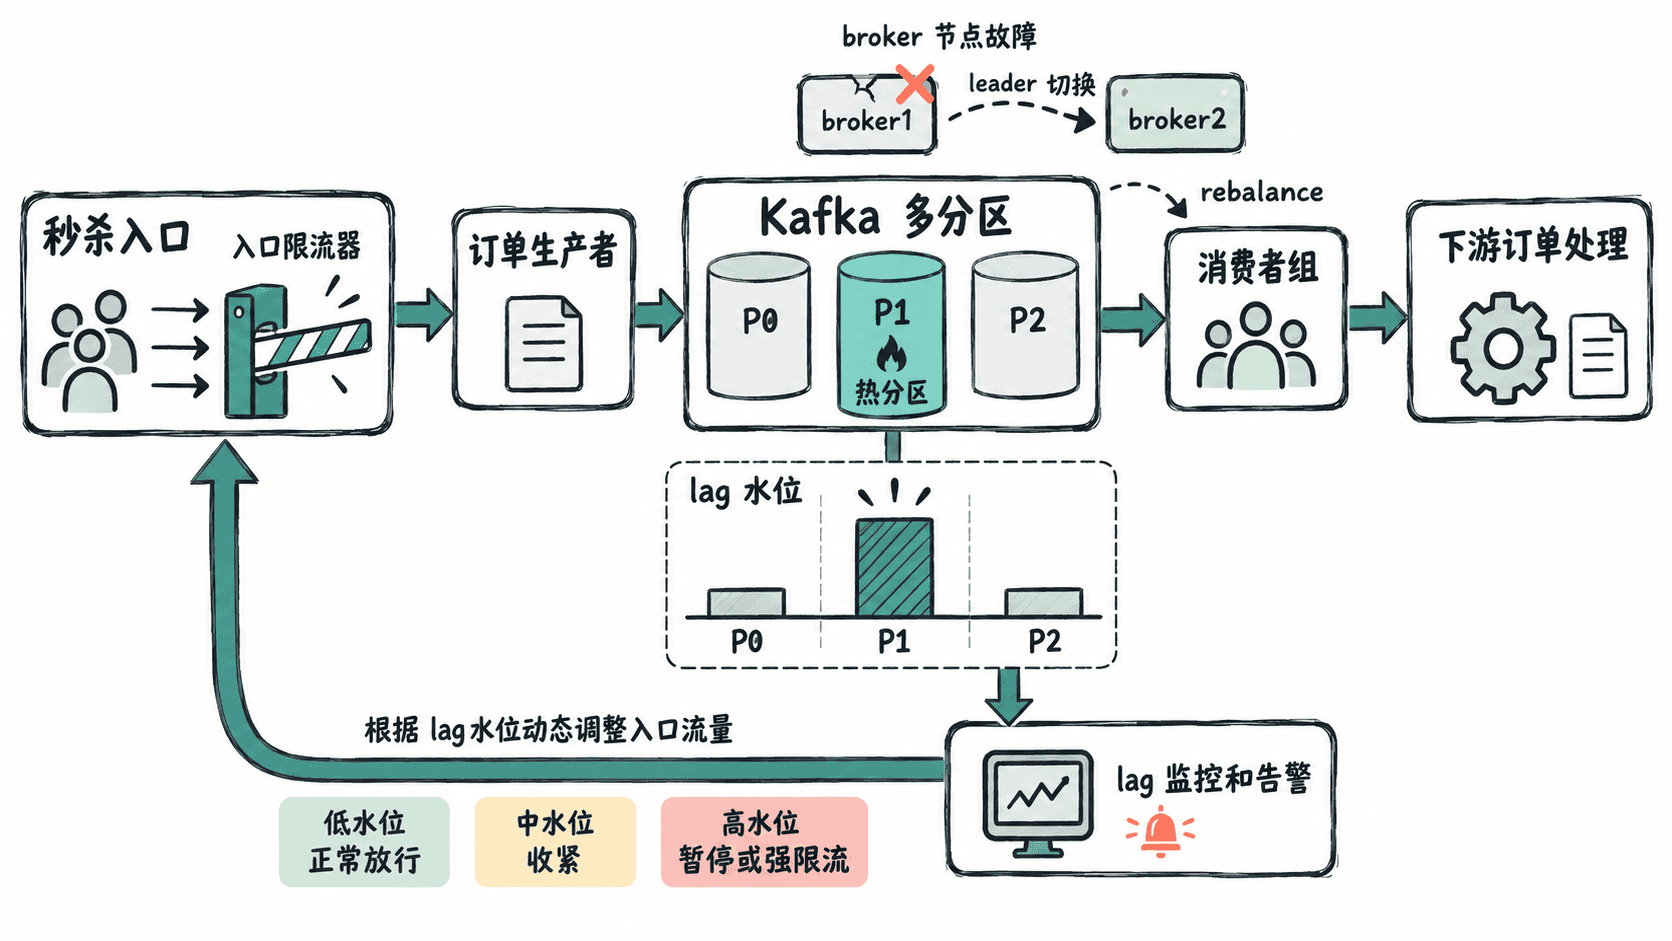
Kafka 故障不能只看 broker 是否存活。秒杀链路至少要同时观察四条线:生产端发送错误率与发送耗时、topic 各分区的 LAG、消费者处理吞吐与 rebalance 情况、秒杀入口实际放行速率。只看平均 lag 很容易掩盖单个热分区,因此必须保留分区级观测。
演练目标也要提前定义。消费暂停后 lag 应可预测地上升;消费者恢复后,消费速率必须高于生产速率,lag 才能持续回落。当 lag 超过业务定义的高水位时,入口限流应主动收紧,避免积压继续线性增长;broker 节点故障触发 leader 迁移时,生产端只应出现受限的短暂抖动。
制造消费者暂停并观察 lag
下面假设实验环境已经安装 Kafka CLI,broker 地址为 <HOST>:<PORT>,topic 为 flashsale-orders,consumer group 为 order-worker,消费者运行在名为 order-consumer 的 Docker 容器中。先记录基线,再暂停消费者让正常生产流量继续进入,最后恢复消费者并观察 lag。
set -euo pipefail
BOOTSTRAP="<HOST>:<PORT>"
GROUP="order-worker"
CONSUMER_CONTAINER="order-consumer"
echo "baseline:"
kafka-consumer-groups.sh --bootstrap-server "$BOOTSTRAP" --group "$GROUP" --describe
docker pause "$CONSUMER_CONTAINER"
echo "consumer paused; keep normal producer traffic for a short window"
sleep 10
echo "during backlog:"
kafka-consumer-groups.sh --bootstrap-server "$BOOTSTRAP" --group "$GROUP" --describe
docker unpause "$CONSUMER_CONTAINER"
echo "consumer resumed:"
kafka-consumer-groups.sh --bootstrap-server "$BOOTSTRAP" --group "$GROUP" --describe
预期结果是暂停期间 CURRENT-OFFSET 基本不动,而存在持续生产流量的分区中 LOG-END-OFFSET 继续增加,因此 LAG 上升。恢复消费者后,只要消费吞吐高于生产速率,后续重复执行查询就能看到 LAG 逐步下降。不同 Kafka 版本的列宽和成员 ID 会不同。
GROUP        TOPIC             PARTITION  CURRENT-OFFSET  LOG-END-OFFSET  LAG   CONSUMER-ID
order-worker flashsale-orders  0          <ID>            <ID>            <ID>  <ID>
order-worker flashsale-orders  1          <ID>            <ID>            <ID>  <ID>
这里的 <HOST>、<PORT> 和 <ID> 都是动态值。演练时应保存“基线、暂停后、恢复后”三个阶段的数据,比较同一分区的 lag 变化,而不是依赖某个固定数字。
加入节点故障并检查生产端
节点故障应在隔离的多 broker 环境执行。停止一个不是唯一副本承载者的 broker 后,观察受影响分区是否完成 leader 迁移、生产端是否出现短暂超时或可重试错误、消费者是否发生 rebalance。若 topic 副本因子或 min.insync.replicas 配置不足,单节点故障可能使部分分区直接不可写,这属于可靠性配置问题,不是增加客户端重试就能解决的。
生产端需要重点排查两个反模式。第一是请求线程同步等待 Kafka 过长,使秒杀入口线程池一起被拖住;第二是没有上限的重试,在 broker 恢复前不断积累更多在途请求。发送超时、重试次数和业务总请求预算必须协同设计,同时业务幂等要能覆盖“生产端没有收到确认,但消息实际上已经写入”的不确定结果。
让 lag 水位驱动入口限流
积压联动不应只使用一个瞬时阈值,否则系统会在阈值附近频繁开关。更稳妥的设计是设置低、中、高三个水位,并加入持续时间和滞回:中水位持续一段时间后降低放行速率,高水位触发更强限流或暂停非核心抢购请求;只有 lag 回落到低水位并稳定一段时间后,才逐步恢复流量。
联动还必须考虑分区不均衡。如果总 lag 看起来不高,但某个热分区持续增长,全集群平均值就会产生误导。此时应优先限制会命中该分区的业务键,或者修正分区键设计,而不是继续按照总平均 lag 放行。恢复阶段也不能一步恢复到峰值流量,否则生产速率再次超过消费速率,lag 会迅速反弹。
用恢复斜率判断是否通过
演练结束时记录故障开始时间 <TIME>、lag 峰值、生产端错误率峰值、rebalance 次数、入口限流生效时间以及 lag 回到低水位的时间。最关键的指标不是“最终 lag 是否归零”,而是恢复后的下降趋势是否稳定,以及入口是否能够根据剩余积压有节制地恢复流量。
如果消费者恢复后 lag 仍然横盘,先比较生产速率和消费速率,再检查热分区、下游数据库变慢、消费者实例未完全恢复等问题。只有生产端错误停止扩散、消费者吞吐重新领先、入口限流逐步解除且 lag 持续回落,这次 Kafka 积压与节点故障演练才真正完成闭环。