
架构与系统设计 / 系统课时
演练 Redis 故障时的库存降级
演练 Redis 故障时的库存降级
这次演练的目标不是简单“把 Redis 弄挂”,而是验证故障出现后库存链路能否迅速收缩:请求不能长期占住线程,数据库不能被穿透式回源压垮,必要时系统应暂停抢购并快速失败。完成后,你会得到一套可重复执行的故障注入、观测和恢复验收方法。
学习目标
- 模拟 Redis 超时或局部不可用,并观察库存接口、线程池与数据库压力变化。
- 判断熔断、快速失败和暂停抢购是否真正截断故障扩散。
- 用恢复后的指标回落与探活结果确认系统已经退出降级状态。
先定义故障边界与验收条件
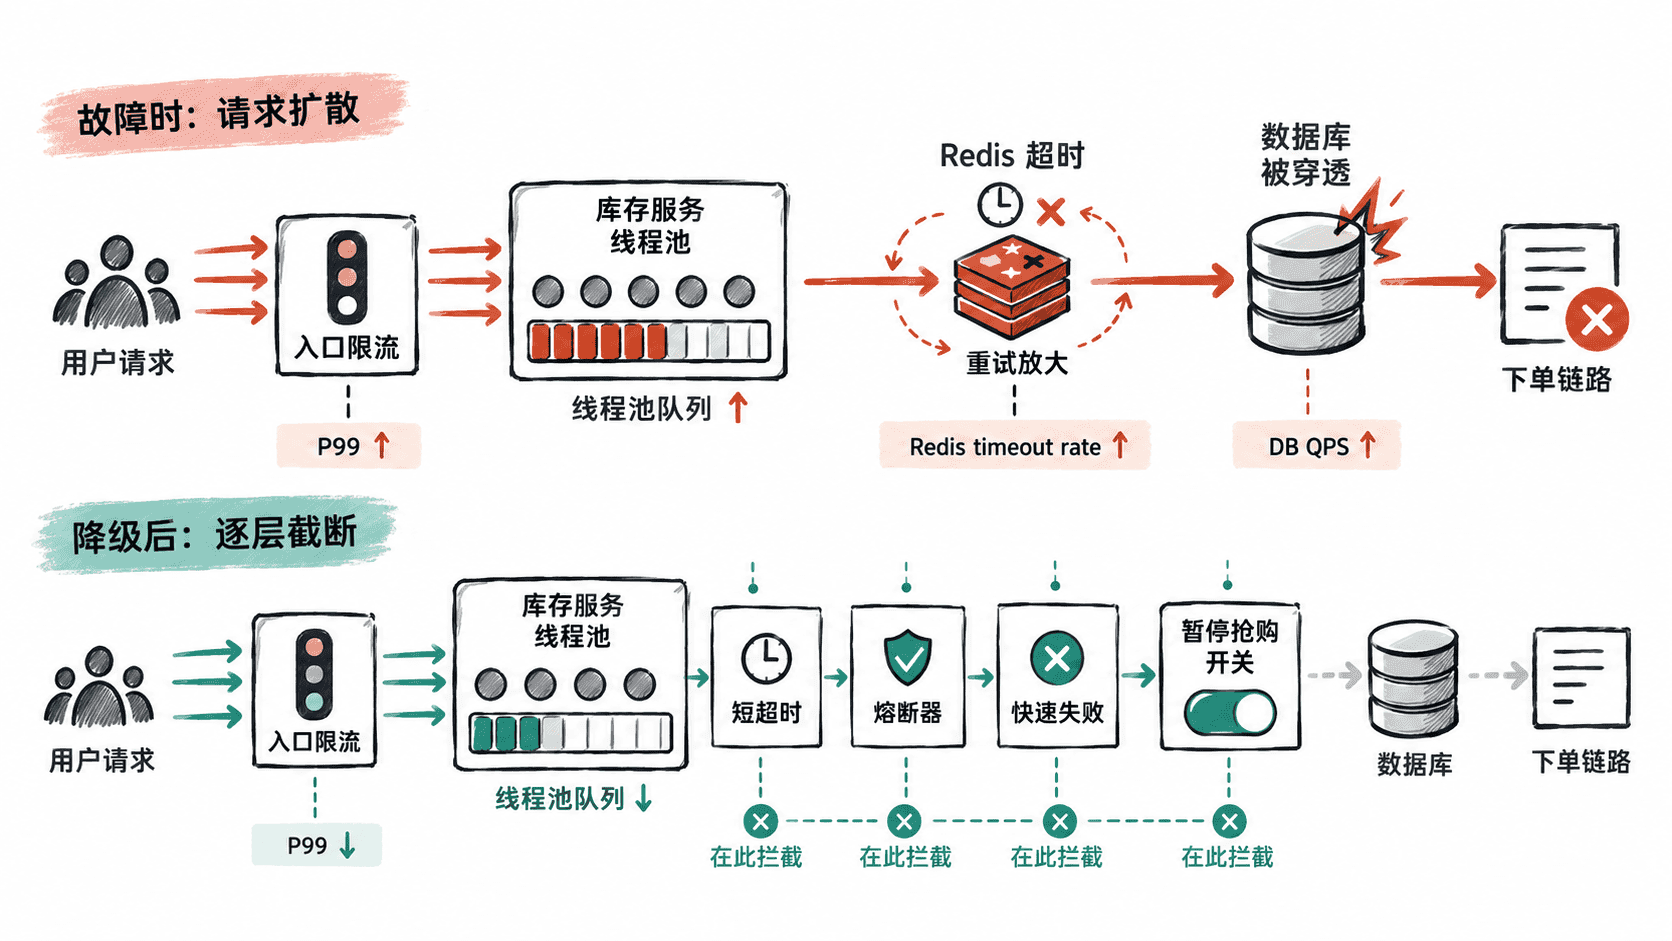
秒杀库存通常位于“入口限流 → 库存服务 → Redis → 异步下单或数据库”的链路上。Redis 失效后,最危险的处理不是立即失败,而是让每个请求等待完整超时、反复重试,甚至直接回源数据库。这样会把一个缓存故障放大成线程池耗尽、连接池阻塞和数据库雪崩。
演练前固定四类观测量:库存接口吞吐与 P95/P99 延迟、库存线程池活跃线程与队列长度、Redis 超时或异常率、数据库 QPS 与连接池使用率。验收目标不是“故障期间接口仍全部成功”,而是故障发生后系统快速进入可控失败,数据库压力不出现与入口流量同量级的突增。
制造一次可恢复的 Redis 超时
下面用 Docker 中的 Redis 容器做最小演练。假设容器名为 redis-primary,宿主机已经安装 redis-cli,Redis 映射到 <PORT>。docker pause 会冻结 Redis 进程,使已有连接仍存在但请求无法及时得到响应,适合模拟“依赖看起来在线、实际调用持续超时”的故障。
set -euo pipefail
REDIS_CONTAINER="redis-primary"
REDIS_PORT="<PORT>"
echo "before fault:"
redis-cli -h 127.0.0.1 -p "$REDIS_PORT" PING
docker pause "$REDIS_CONTAINER"
set +e
timeout 1 redis-cli -h 127.0.0.1 -p "$REDIS_PORT" PING
PING_EXIT=$?
set -e
echo "ping exit during fault: $PING_EXIT"
docker unpause "$REDIS_CONTAINER"
echo "after recovery:"
redis-cli -h 127.0.0.1 -p "$REDIS_PORT" PING预期输出如下。<PORT> 由实验环境决定;GNU timeout 因超时终止命令时通常返回退出码 124。
before fault:
PONG
redis-primary
ping exit during fault: 124
redis-primary
after recovery:
PONG
如果要验证主从切换,应在隔离环境通过 Sentinel、Redis Cluster 或云 Redis 提供的故障切换能力执行,并记录客户端重连、拓扑刷新和短暂错误窗口。局部不可用则可以只阻断一个应用实例到 Redis 的网络,检查故障能否被限制在该实例,而不是扩散到全部节点。
按故障传播方向观察系统
故障注入后先看库存接口,再沿调用链向下排查。库存接口如果迅速进入受控的服务不可用或“系统繁忙”状态,同时 P99 没有持续爬升,说明快速失败已经开始工作。若成功率下降的同时延迟越来越高,通常意味着请求仍在等待过长的 Redis 超时。
接着观察线程池和重试。活跃线程接近上限、队列持续增长,或单次业务请求触发多轮 Redis 重试,都说明故障正在被放大。秒杀链路的重试次数应非常保守,并受总超时预算约束;连续错误达到阈值后,熔断器应直接拒绝后续 Redis 调用,让连接与工作线程得到释放。
最后看数据库。Redis 故障期间,数据库 QPS、连接使用率和锁等待不应因为库存查询突然随入口流量一起上升。若策略是“缓存失败就查数据库”,即使暂时还能返回库存,也是在把高并发流量转移到承载能力更低的后端。
验证三层降级是否生效
第一层是快速失败:库存访问设置明确的短超时和有限重试,失败后立即返回统一降级结果。第二层是熔断:连续错误或慢调用达到阈值后,短时间不再访问 Redis。第三层是暂停抢购:库存真值已经无法可靠获取时,通过活动开关或流量网关暂停创建新抢购请求。
如果系统提供人工暂停开关,还要验证开关传播时间和多实例一致性。恢复顺序应是先确认 Redis 服务、连接和探活稳定,再允许熔断器试探恢复,随后解除活动暂停并逐步放量。仅仅看到一次 PING 返回 PONG,不足以证明链路已经恢复稳定。
用恢复阶段完成验收
故障解除后至少观察一个稳定窗口。Redis 超时率应回到基线,线程池队列逐渐清空,库存接口延迟恢复,数据库 QPS 回落到正常范围。若 Redis 已恢复但线程池仍长期满载,应继续检查超时任务残留、连接池重建和重试风暴。
演练记录至少保留故障开始时间 <TIME>、熔断或暂停生效时间 <TIME>、故障期间峰值 P99、线程池峰值、数据库 QPS 峰值以及恢复到基线所需时间。真正通过的标准不是“Redis 恢复以后接口又能用了”,而是 Redis 故障期间系统没有把压力继续扩散到线程池和数据库。