
架构与系统设计 / 系统课时
从全链路指标定位首个瓶颈
从全链路指标定位首个瓶颈
全链路压测里最容易误判的是“谁的指标最难看,谁就是瓶颈”。真正应该找的是最先进入饱和或排队状态的组件,因为下游等待会把延迟和线程占用逐层传回上游。你会把网关、应用线程、Redis、Kafka、数据库和连接池放到同一时间轴,找出第一个发生结构性变化的点。
学习目标
- 把不同组件的指标统一到可比较的时间窗口
- 用“谁先饱和”区分根因与被动排队
- 通过单变量修复和复测验证瓶颈判断
先统一时间轴和观测粒度
定位前先保证所有图表使用相同的开始时间、结束时间和采样粒度,例如统一为 10 秒。若网关按 1 分钟聚合、数据库按 5 秒采样,视觉上很容易把后发生的抖动误判成先发生。
建议至少对齐这些指标:网关请求率与 P99、应用活跃线程与线程等待、Redis CPU 与命中率、Kafka consumer lag、数据库活动连接与执行时间、连接池 active 与 pending。压测施加流量也要画在同一时间轴上,作为因果链的起点。
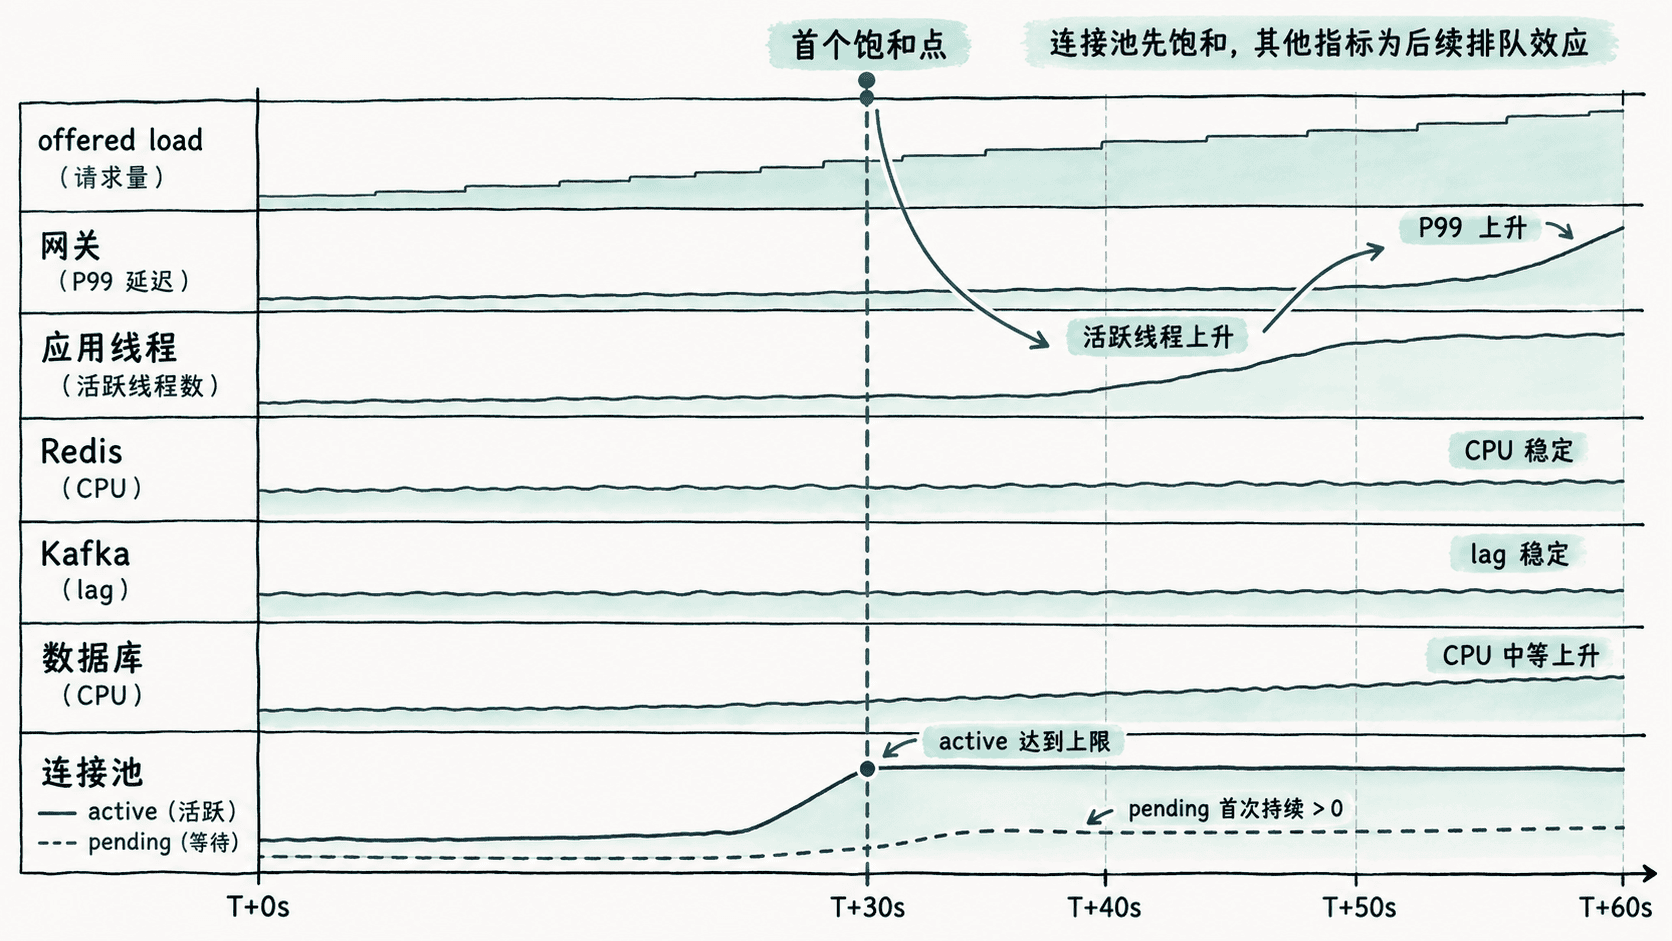
对齐后不要先看峰值,而要从左向右找“第一条持续越界的曲线”。后续所有异常都要问一句:它是在首个异常之前出现,还是之后才跟着恶化?
用首个阈值越界缩小范围
下面的可运行脚本使用一组同轴采样数据,模拟连接池先饱和、应用线程和网关延迟随后恶化的情况。脚本按时间扫描各组件阈值,并打印最早出现的持续性饱和证据。
samples = [
    {"t": "T+0s",  "gateway_p99": 110, "app_threads": 70,  "redis_cpu": 35, "kafka_lag": 0, "db_cpu": 40, "pool_active": 58,  "pool_pending": 0},
    {"t": "T+10s", "gateway_p99": 120, "app_threads": 78,  "redis_cpu": 41, "kafka_lag": 0, "db_cpu": 44, "pool_active": 72,  "pool_pending": 0},
    {"t": "T+20s", "gateway_p99": 135, "app_threads": 86,  "redis_cpu": 47, "kafka_lag": 1, "db_cpu": 49, "pool_active": 94,  "pool_pending": 0},
    {"t": "T+30s", "gateway_p99": 170, "app_threads": 102, "redis_cpu": 52, "kafka_lag": 1, "db_cpu": 55, "pool_active": 100, "pool_pending": 12},
    {"t": "T+40s", "gateway_p99": 310, "app_threads": 145, "redis_cpu": 56, "kafka_lag": 2, "db_cpu": 59, "pool_active": 100, "pool_pending": 38},
    {"t": "T+50s", "gateway_p99": 690, "app_threads": 188, "redis_cpu": 58, "kafka_lag": 2, "db_cpu": 61, "pool_active": 100, "pool_pending": 81},
]

for s in samples:
    if s["pool_active"] >= 95 and s["pool_pending"] > 0:
        print(f"first_bottleneck=db_pool at {s['t']}")
        print(f"pool_active={s['pool_active']} pool_pending={s['pool_pending']}")
        print(f"db_cpu={s['db_cpu']} redis_cpu={s['redis_cpu']} kafka_lag={s['kafka_lag']}")
        break
预期输出
first_bottleneck=db_pool at T+30s
pool_active=100 pool_pending=12
db_cpu=55 redis_cpu=52 kafka_lag=1
这里连接池在 T+30s 已经满载且出现等待,而数据库 CPU、Redis CPU 和 Kafka lag 都没有同时进入饱和区。到 T+40s 之后应用线程才大量占用,到 T+50s 网关 P99 才明显恶化,所以“网关延迟高”只是症状,“应用线程多”也更像等待下游连接的结果。
按因果链解释而不是按颜色报警
看到某个组件变红时,先判断它的资源是否真的耗尽,再判断它是否只是等待别的组件。连接池 pending 增长但数据库 CPU 不高,常见原因是池上限过小、连接获取超时或事务持有连接过久;数据库 CPU 先到 95%,随后连接池 pending 才上升,则瓶颈更可能在 SQL、索引、锁竞争或数据库容量。
同理,Redis CPU 或慢命令先恶化并且应用线程随后阻塞,可以优先查 Redis;Kafka lag 先持续扩大且消费者 CPU 已满,则查消费能力。先后顺序比单个瞬时峰值更重要,因为后续排队会把许多上游指标一起拖坏。
一次只改一个瓶颈并复测
确认首个瓶颈后,只调整与它直接相关的一类变量,然后用相同负载阶梯重跑。若连接池是首个瓶颈,可以先验证池上限、连接获取时间、事务时长和 SQL 平均耗时是否匹配,再决定是扩池还是减少连接占用时间,而不是机械地把上限翻倍。
修复是否有效有一个很强的验收标准:原来的首个饱和点应该被推迟,并且新的时间轴能清楚显示“旧瓶颈不再最先恶化”。如果连接池不再 pending,但数据库 CPU 变成最早饱和项,说明你已经把系统边界向后推了一层;这正是全链路容量优化应有的迭代方式。
定位全链路瓶颈的核心动作只有一个:把所有指标放到同一时间轴,从左向右寻找第一个持续饱和点,再用后续排队传播解释其他异常。这样每次调优都有明确证据,也能避免“哪里红就调哪里”的随机优化。