
架构与系统设计 / 系统课时
验证限流降级和弹性扩容
验证限流降级和弹性扩容
限流、降级和自动扩容只有在压力真正越过阈值时才算被验证。本节把压测设计成可触发的阶梯场景,观察入口是否及时削峰、非核心功能是否按预期退出,以及新实例能否在现有余量耗尽前真正接住流量。
学习目标
- 设计能主动触发限流、降级和扩容的阶梯压测。
- 判断阈值是过早、过晚还是存在抖动。
- 用核心下单成功率和扩容就绪时间完成验收。
把压测设计成可触发的阶梯
单纯把流量打到峰值,只能证明“最后扛没扛住”,看不出保护机制何时生效。更有效的做法是按阶段递增负载,并在每个阶段保持足够时间,让队列、CPU、连接池和自动扩容控制器进入稳定状态。
- 先跑低于限流阈值的基线档,确认没有误限流、误降级。
- 提升到限流阈值附近,记录第一批被拒绝或排队的请求。
- 继续升高到降级阈值,确认推荐、画像、次要查询等非核心能力被关闭。
- 保持高压直到扩容实例完成启动、健康检查并开始接流量,再观察错误率与延迟是否回落。
- 最后降低流量,检查限流、降级和扩容是否能平滑恢复,避免阈值附近反复开关。
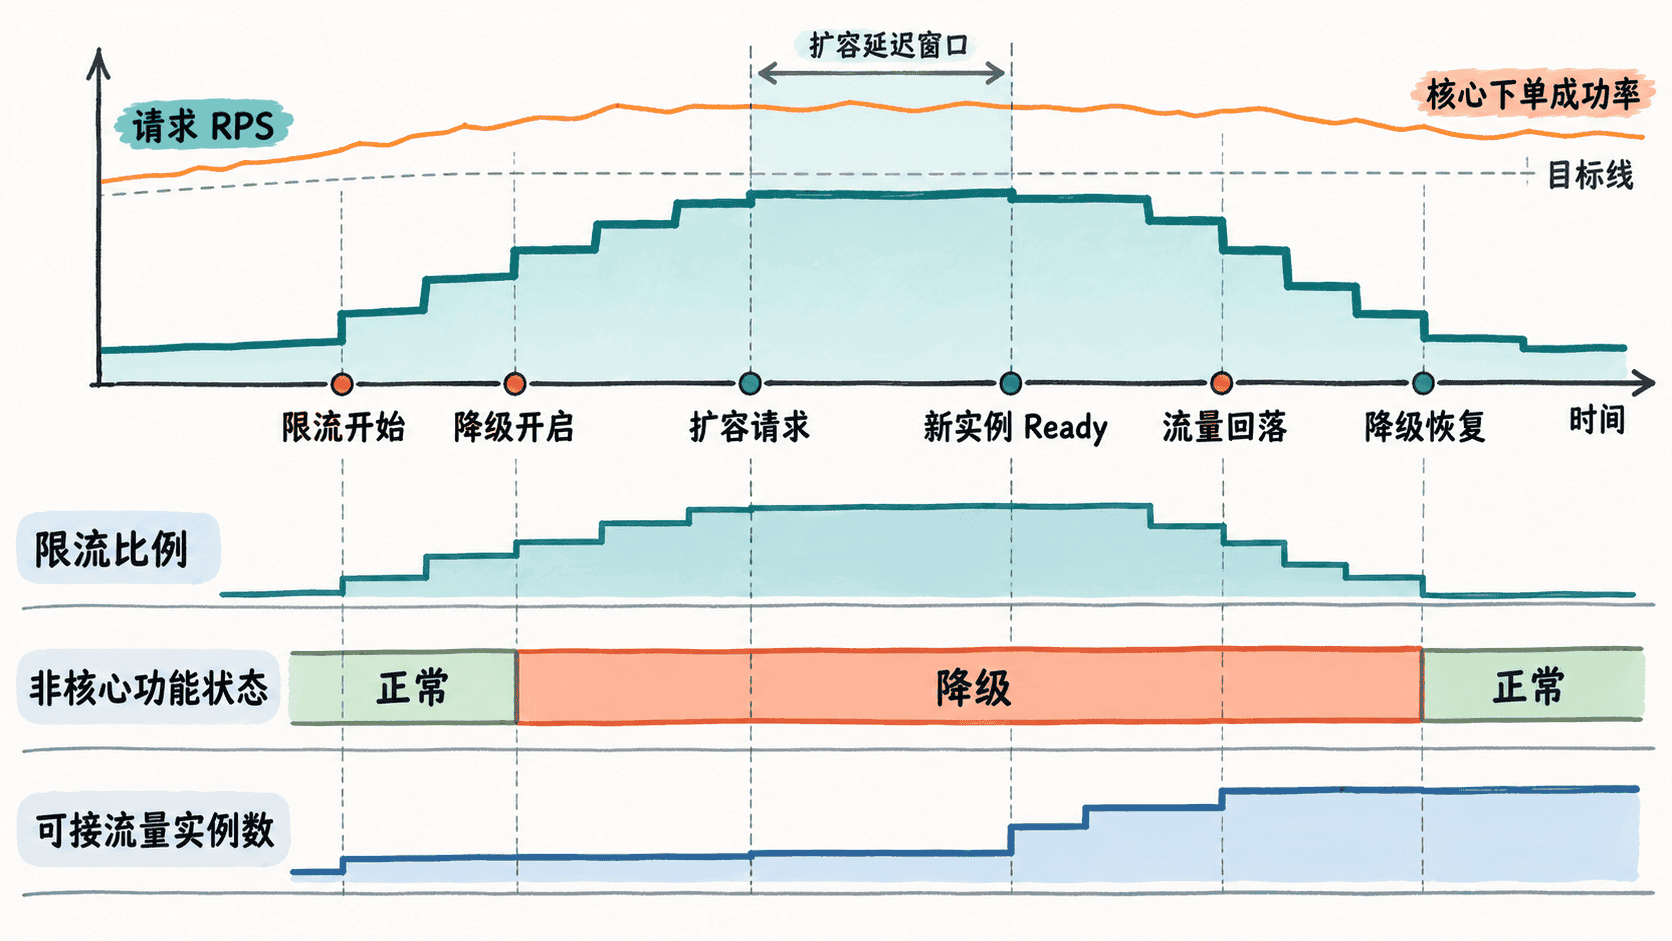
阶梯之间不要只停几秒。若系统有 60~120 秒的扩容采样窗口或实例启动时间,压测阶段必须长于这个周期,否则看到的只是瞬时反应,无法验证控制器是否真正生效。
同时看保护动作和业务结果
验收时不能只看 CPU 或实例数。至少要把“触发动作”和“业务结果”放在同一时间轴上观察。
| 维度 | 关键指标 | 要回答的问题 |
|---|---|---|
| 入口保护 | 限流比例、排队长度、拒绝数 | 是否在资源饱和前开始削峰 |
| 降级 | 降级开关、非核心调用量 | 是否只牺牲非核心能力 |
| 核心链路 | 下单成功率、p99、错误率 | 降级后核心交易是否仍达标 |
| 弹性 | 期望实例数、Ready 实例数、就绪耗时 | 扩容是否赶得上流量增长 |
尤其要区分“期望实例数增加”和“实例可接流量”。镜像拉取、启动、预热、健康检查都可能让两者相差几十秒甚至更久,容量判断必须以后者为准。
用判定脚本复核压测采样
下面的脚本演示如何对一次阶梯压测的关键采样点做自动验收。数据是固定示例,实际使用时可把监控导出的采样值转换成相同字段后复用判定逻辑。
samples = [
    {"rps": 8000, "limited": 0.00, "degraded": False, "ready": 6, "order_success": 0.998},
    {"rps": 12000, "limited": 0.05, "degraded": False, "ready": 6, "order_success": 0.995},
    {"rps": 16000, "limited": 0.19, "degraded": True, "ready": 6, "order_success": 0.992},
    {"rps": 20000, "limited": 0.30, "degraded": True, "ready": 10, "order_success": 0.991},
]

scale_requested_at = 32
scale_ready_at = 92

first_limited = next(item for item in samples if item["limited"] > 0)
first_degraded = next(item for item in samples if item["degraded"])
min_core_success = min(item["order_success"] for item in samples)
scale_latency = scale_ready_at - scale_requested_at

checks = {
    "rate_limit_window": 11000 <= first_limited["rps"] <= 13000,
    "degrade_window": 15000 <= first_degraded["rps"] <= 17000,
    "scale_latency": scale_latency <= 90,
    "core_success": min_core_success >= 0.99,
}

for name, passed in checks.items():
    print(f"{name}: {'PASS' if passed else 'FAIL'}")
预期输出
rate_limit_window: PASS
degrade_window: PASS
scale_latency: PASS
core_success: PASS
真实环境中的阈值窗口应来自你的 SLO、资源拐点和容量测试,而不是照抄示例。若某项失败,应回到对应监控时间点确认是阈值配置、控制器延迟,还是下游容量先耗尽。
判断阈值过早还是过晚
限流过早的典型现象是资源仍有大量余量、p99 也健康,却已经持续拒绝请求;这样会浪费本可承接的容量。限流过晚则相反:队列、连接池或 p99 已经明显恶化,入口仍没有削峰,最终会把故障扩散到下游。
降级阈值也应围绕核心交易目标设置。降级开启后,如果非核心调用明显下降,但核心下单成功率仍低于目标,说明问题不只在可选功能,可能是库存、数据库或消息链路已经成为瓶颈。
判断扩容能否追上流量
扩容是否有效,关键看“剩余容量还能撑多久”和“新实例多久 Ready”。例如当前 6 个实例每个稳定承载 2500 RPS,总稳定能力约 15000 RPS;当前流量已到 12000 RPS,只剩 3000 RPS 余量。若流量以每秒 100 RPS 增长,约 30 秒后就会耗尽余量。
如果从触发扩容到新实例 Ready 需要 60 秒,那么扩容虽然最终成功,却明显来不及。修复方向应是提前触发、缩短启动与预热时间、保留更多常驻容量,或对突发流量先用限流削峰,而不是只把最大实例数调大。
最终验收应同时满足四件事:保护动作在资源失控前触发、非核心能力能按预期退出、核心下单成功率维持目标、扩容实例在安全余量耗尽前 Ready。只有这四条在同一次阶梯压测中形成完整证据链,限流、降级和弹性扩容才算真正可用。