
架构与系统设计 / 系统课时
用 Kafka 把下单移出请求链路
用 Kafka 把下单移出请求链路
秒杀请求已经通过资格与库存校验后,不必继续等待订单数据库写入完成。把“创建订单”变成 Kafka 事件,接口只等消息被 broker 确认就返回受理结果,再由消费者按自身吞吐落库,可以把数据库峰值从请求瞬时洪峰中隔离出来。
学习目标
- 划清异步下单请求链路的结束位置,并理解为什么接口应返回受理而不是已下单。
- 比较同步下单与 Kafka 异步下单在延迟、削峰和失败处理上的差异。
- 跑通生产事件、消费落库和消费位点提交的最小链路。
缩短请求链路的真正边界
同步下单通常是“资格校验→扣库存→写订单库→返回成功”,请求线程会直接承受订单库延迟。异步化后,链路变成“资格校验→扣库存或占用资格→发送下单事件→返回 202 Accepted”,订单落库移到消费者中执行。
接口返回受理只表示事件已经可靠进入异步链路,不表示订单记录已经存在。客户端应使用 requestId 或 orderId 查询最终状态,而不是把 202 当成下单完成。若发送 Kafka 失败,接口也不能提前返回受理成功。
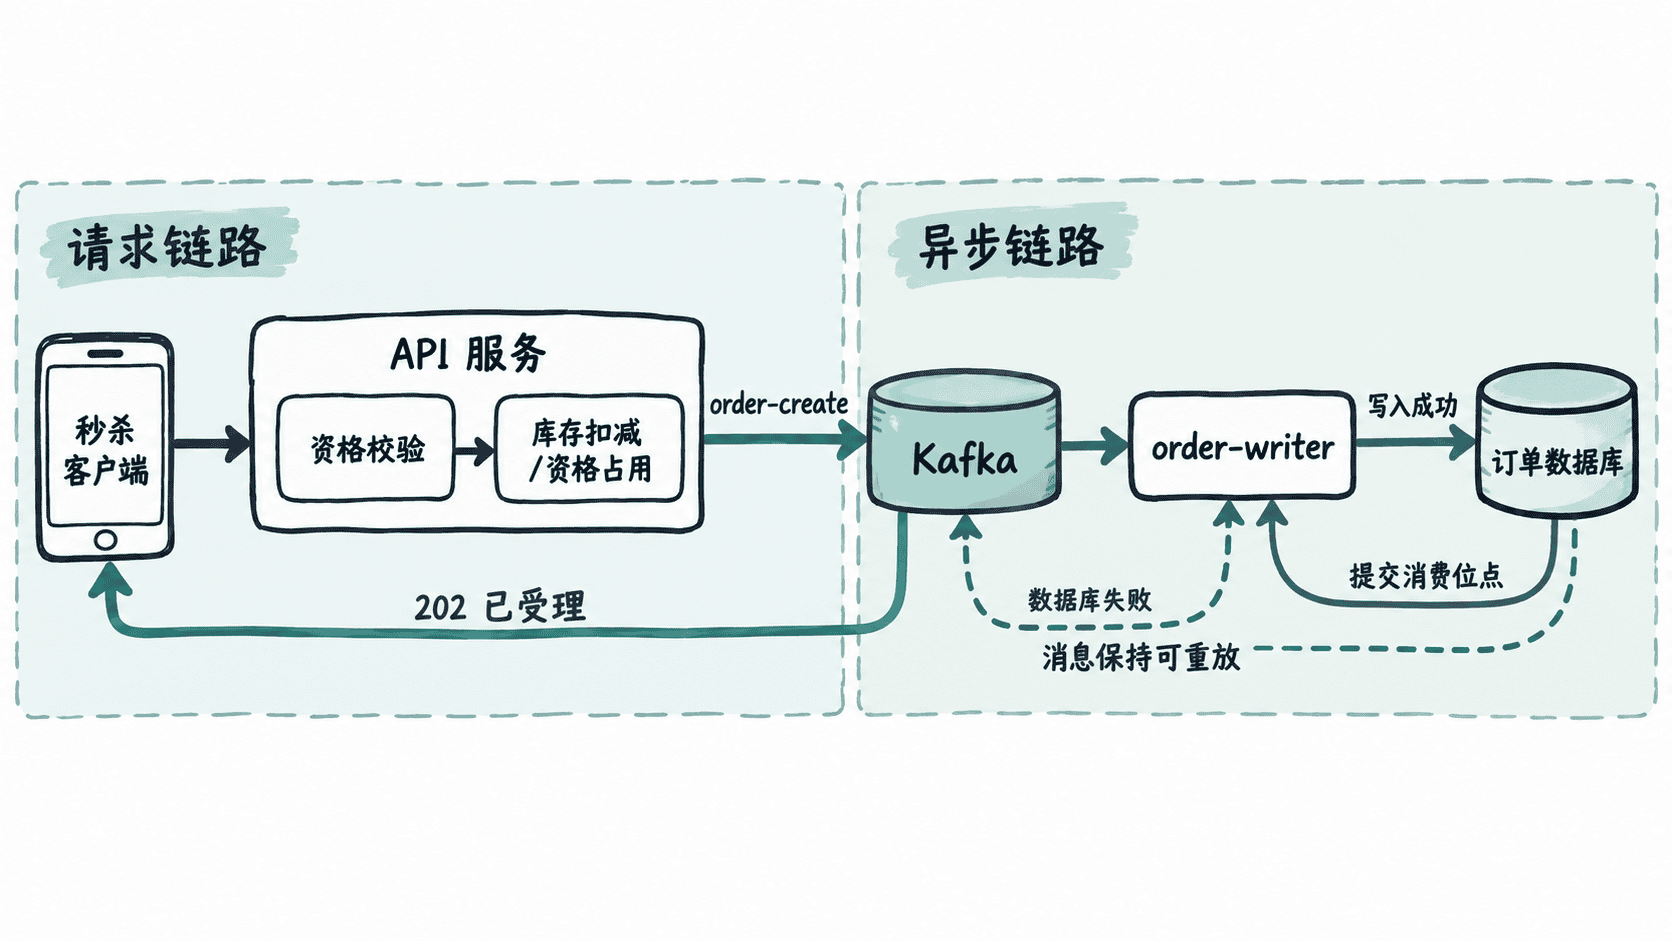
看清同步与异步的差异
| 维度 | 同步写订单 | Kafka 异步下单 |
|---|---|---|
| 请求返回点 | 订单库提交后 | broker 确认事件后 |
| 峰值压力 | 请求洪峰直接打到订单库 | Kafka 缓冲,消费者按能力落库 |
| 用户看到的状态 | 成功或失败较直接 | 先“已受理”,再查询最终结果 |
| 失败处理 | 当前请求内返回错误 | 重试、重放、幂等和状态查询必须完善 |
异步化并没有消灭失败,只是把失败从请求线程移到了消息处理链路。因此系统必须明确“消息是否已投递”“订单是否已创建”是两个不同状态,并让消费者能够安全重放。
跑通最小生产与消费链路
下面的 Python 程序同时包含生产者和消费者。运行前需要可访问的 Kafka broker,并安装 confluent-kafka;把 <HOST>:<PORT> 替换成实际地址。生产者等待 broker 确认后打印受理结果,消费者把订单写入本地 SQLite,再同步提交 Kafka 位点。
from confluent_kafka import Consumer, Producer
import json
import sqlite3
import sys
import time

BROKER = "<HOST>:<PORT>"
TOPIC = "order-create"

EVENT = {
    "eventId": "evt-10001",
    "orderId": "ord-10001",
    "userId": 42,
    "skuId": 1001,
    "qty": 1
}

def produce_order():
    result = {"error": None, "message": None}

    def on_delivery(error, message):
        result["error"] = error
        result["message"] = message

    producer = Producer({
        "bootstrap.servers": BROKER,
        "acks": "all"
    })
    producer.produce(
        TOPIC,
        key=str(EVENT["userId"]),
        value=json.dumps(EVENT),
        on_delivery=on_delivery
    )

    remaining = producer.flush(10)
    if remaining != 0 or result["error"] is not None:
        raise RuntimeError(f"broker ack failed: {result['error']}")

    message = result["message"]
    print(
        f"accepted topic={message.topic()} "
        f"partition={message.partition()} offset={message.offset()}"
    )

def consume_one():
    consumer = Consumer({
        "bootstrap.servers": BROKER,
        "group.id": "order-writer-demo",
        "auto.offset.reset": "earliest",
        "enable.auto.commit": False
    })
    consumer.subscribe([TOPIC])

    deadline = time.time() + 30
    while time.time() < deadline:
        message = consumer.poll(1.0)
        if message is None:
            continue
        if message.error():
            raise RuntimeError(message.error())

        event = json.loads(message.value().decode("utf-8"))
        with sqlite3.connect("orders.db") as db:
            db.execute(
                "CREATE TABLE IF NOT EXISTS orders ("
                "event_id TEXT PRIMARY KEY, "
                "order_id TEXT NOT NULL UNIQUE, "
                "user_id INTEGER NOT NULL, "
                "sku_id INTEGER NOT NULL, "
                "qty INTEGER NOT NULL)"
            )
            cursor = db.execute(
                "INSERT OR IGNORE INTO orders "
                "(event_id, order_id, user_id, sku_id, qty) "
                "VALUES (?, ?, ?, ?, ?)",
                (
                    event["eventId"],
                    event["orderId"],
                    event["userId"],
                    event["skuId"],
                    event["qty"]
                )
            )
            db.commit()

        consumer.commit(message=message, asynchronous=False)
        state = "created" if cursor.rowcount == 1 else "duplicate"
        print(f"{state} event={event['eventId']} order={event['orderId']}")
        consumer.close()
        return

    consumer.close()
    raise TimeoutError("no order event received within 30 seconds")

if __name__ == "__main__":
    if len(sys.argv) != 2 or sys.argv[1] not in {"producer", "consumer"}:
        raise SystemExit("usage: python async_order.py producer|consumer")

    if sys.argv[1] == "producer":
        produce_order()
    else:
        consume_one()
预期输出
# producer
accepted topic=order-create partition=<ID> offset=<ID>

# consumer
created event=evt-10001 order=ord-10001
先启动 consumer,再执行 producer。实际分区和 offset 会不同,因此示例用 <ID> 表示动态值。重复投递同一个 eventId 时,SQLite 主键会让订单写入保持幂等,消费者打印 duplicate 后仍可提交这条已确认无副作用的消息。
消费成功后再提交位点
消费者的关键顺序是“数据库事务提交→Kafka offset 提交”。如果先提交 offset 再写库,进程在两步之间崩溃时,这条事件可能被认为已经消费,却没有订单记录;反过来先写库再提交 offset,最坏情况是消息重放,因此只要订单写入具备幂等性就能安全恢复。
当订单库只能稳定处理每秒一部分写入时,Kafka 可以吸收短时洪峰,消费者按数据库可承受的速率持续落库。这样请求端延迟主要受资格判断和消息投递影响,而订单库的慢写不会直接拖住成千上万条抢购请求。