
架构与系统设计 / 系统课时
按峰值与余量规划实例容量
按峰值与余量规划实例容量
容量规划的目标不是把峰值 RPS 除以一个“理论单机 QPS”,而是把稳定吞吐、故障冗余和扩容等待时间一起算进去,再检查 Redis、Kafka 与数据库是否会先成为瓶颈。最终要得到的是可上线、可解释、可回测的一组实例数与下游容量边界。
学习目标
- 根据目标峰值和单实例稳定吞吐计算基线实例数。
- 把故障冗余与扩容耗时换算成明确的安全余量。
- 用同一峰值假设校验 Redis、Kafka 和数据库的下游容量。
先把峰值换成基线实例数
用于计算的单实例吞吐必须来自稳定压测区间,而不是短时间冲高值。所谓“稳定”,至少应同时满足延迟、错误率和资源占用要求,例如 p99 未越过目标、错误率可接受、CPU 与连接池仍有余量。
基线实例数可以直接按“目标峰值 ÷ 单实例稳定吞吐后向上取整”计算。假设目标峰值为 36000 RPS,单实例在目标 SLO 下稳定承载 2400 RPS,则基线需要 15 个实例。
下面的脚本进一步把故障冗余和扩容等待时间换算为实例数。示例中的数值应替换为你的压测结果与平台扩容数据。
import math

peak_rps = 36000
stable_rps_per_instance = 2400

# 至少允许同时损失两个实例,避免节点故障直接吃光余量。
fault_redundancy = 2

# 扩容从发出请求到实例真正可接流量需要 90 秒。
scale_ready_seconds = 90
peak_growth_per_second = 160

base_instances = math.ceil(peak_rps / stable_rps_per_instance)
warmup_reserve = math.ceil(
    scale_ready_seconds * peak_growth_per_second / stable_rps_per_instance
)
planned_instances = base_instances + fault_redundancy + warmup_reserve

print(f"base={base_instances}")
print(f"warmup_reserve={warmup_reserve}")
print(f"planned={planned_instances}")
预期输出
base=15
warmup_reserve=6
planned=23
这里的 23 不是固定答案,而是这组假设下的容量结果。若流量增长斜率、启动耗时或单实例稳定吞吐变化,都应重新计算。
把余量拆成可解释的来源
安全余量最好不要只写成“额外加 30%”。至少拆成两部分:一部分抵抗实例、节点或可用区故障;另一部分覆盖扩容启动期间持续增长的流量。这样才能在评审时回答“为什么是这些实例,而不是更多或更少”。
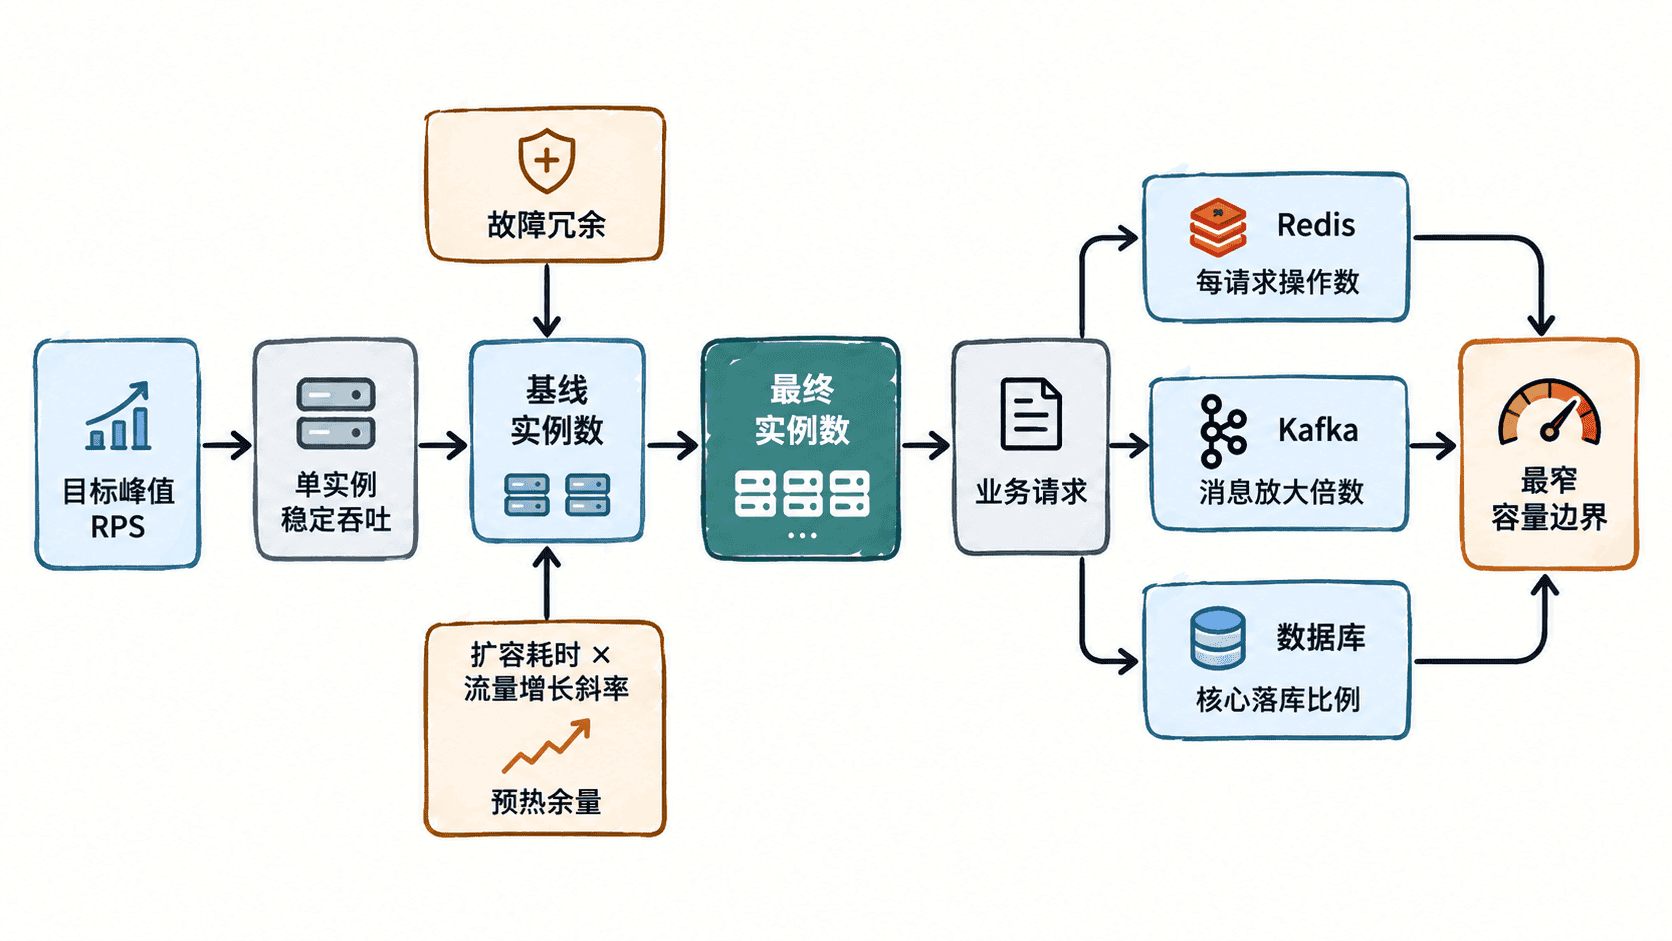
如果扩容速度明显慢于流量上涨速度,继续堆自动扩容并不能解决问题。此时应提高常驻实例数、提前触发扩容、缩短镜像与健康检查时间,或用预热池减少实例就绪延迟。
用同一峰值校验下游
应用实例算够了并不代表系统就能扛住峰值。下游必须使用同一组峰值假设换算真实负载,不能分别拿各自“看起来够大”的数字。
| 下游 | 换算方式 | 36000 RPS 示例需求 | 校验重点 |
|---|---|---|---|
| Redis | 请求 RPS × 每请求 Redis 操作数 | 每请求 3 次时为 108000 ops/s | 热点 key、单分片吞吐、连接数与慢查询 |
| Kafka | 请求 RPS × 每请求消息数 | 每请求 2 条时为 72000 msg/s | 分区吞吐、生产确认、消费积压与磁盘带宽 |
| 数据库 | 请求 RPS × 实际落库比例 | 18% 请求进入核心事务时为 6480 tx/s | 事务吞吐、连接池、锁等待、日志与复制延迟 |
数据库尤其不能直接拿入口 RPS 对比“最大 QPS”。秒杀链路通常会先经过资格校验、限流和库存预扣,真正进入事务的比例更低,但单笔事务的写放大和锁冲突更高,应以压测中的实际事务路径为准。
把容量结论写成上线门槛
上线前应把容量结论固定成可复核的门槛:目标峰值是多少,单实例稳定吞吐是多少,计划实例数包含哪些冗余,下游各自的稳定上限和剩余余量是多少。任何一项低于目标,都不能用“应用层实例够了”掩盖。
当代码路径、实例规格、缓存访问次数、消息放大倍数、数据库索引或扩容耗时发生变化时,都应重新跑稳定压测并重算容量。容量规划真正要保护的是整条链路,而不是某一个服务的实例数。