
架构与系统设计 / 系统课时
设计活动前巡检与应急预案
设计活动前巡检与应急预案
活动前最后一次检查的目标不是证明系统“应该没问题”,而是把能否开场变成可执行的判断:关键配置有明确门槛,异常有负责人、触发条件和处置动作,任何一项不满足都能立即阻止放量或进入降级状态。
学习目标
- 把活动配置、库存、限流、队列、数据库和告警转换成可判定的放行条件
- 为容量不足、依赖异常和数据风险定义触发阈值、负责人及应急动作
- 组织一份现场可直接执行的 GO、NO-GO 巡检与回退流程
把巡检项变成放行门槛
巡检清单不能只写“检查 Redis”“确认数据库正常”。现场需要的是二元结论:满足条件就 PASS,不满足就 NO-GO,并立即进入对应处置流程。阈值应来自前期容量压测和业务目标,而不是在活动当天临时估计。
| 检查面 | 示例放行条件 | 不满足时的动作 |
|---|---|---|
| 活动配置 | 时间、商品、资格规则和开关已复核 | 禁止开放入口,修正后重新巡检 |
| 库存 | 数据库、缓存及预热库存一致 | 冻结销售,重新同步并核对差异 |
| 限流 | 网关阈值不超过已验证容量 | 下调入口阈值或缩小放量范围 |
| 队列 | 剩余容量足以吸收计划突发量 | 扩容消费者或降低入口速率 |
| 数据库 | CPU、连接池和写入延迟仍有余量 | 降级非核心写入并限制下单速率 |
| 告警与开关 | 告警链路、降级和熔断开关可用 | 未修复前不得开场 |
下面的脚本演示如何把巡检结果固化成机器可判定的 GO、NO-GO 闸门。数值只是演练样例,实际阈值必须替换为本系统经过压测验证的容量数据。
#!/usr/bin/env bash
set -euo pipefail

activity_config_ok=1
inventory_db=5000
inventory_cache=5000
gateway_limit=8000
tested_rps=10000
queue_capacity=20000
queue_backlog=1000
db_cpu_pct=45
alert_route_ok=1
emergency_switch_ok=1
fail=0

pass_check() {
  echo "[PASS] $1"
}

fail_check() {
  echo "[FAIL] $1"
  fail=1
}

if (( activity_config_ok == 1 )); then pass_check 'activity-config'; else fail_check 'activity-config'; fi
if (( inventory_db == inventory_cache )); then pass_check 'inventory-consistency'; else fail_check 'inventory-consistency'; fi
if (( gateway_limit <= tested_rps )); then pass_check 'rate-limit'; else fail_check 'rate-limit'; fi
queue_headroom=$((queue_capacity - queue_backlog))
if (( queue_headroom >= 10000 )); then pass_check 'queue-headroom'; else fail_check 'queue-headroom'; fi
if (( db_cpu_pct <= 60 )); then pass_check 'database-headroom'; else fail_check 'database-headroom'; fi
if (( alert_route_ok == 1 && emergency_switch_ok == 1 )); then pass_check 'alert-and-switch'; else fail_check 'alert-and-switch'; fi

if (( fail == 0 )); then
  echo 'DECISION=GO'
else
  echo 'DECISION=NO-GO'
  exit 1
fi
预期输出
[PASS] activity-config
[PASS] inventory-consistency
[PASS] rate-limit
[PASS] queue-headroom
[PASS] database-headroom
[PASS] alert-and-switch
DECISION=GO
巡检脚本的价值不是替代人工确认,而是阻止“知道有风险但还是先开再说”。涉及库存来源、活动规则等业务正确性的项目仍需要人工双人复核,机器检查负责验证能够量化的事实。
把应急动作绑定到触发条件
应急预案要回答五件事:看到了什么、谁来决定、执行什么动作、如何确认生效、什么时候恢复。只写“异常时降级”没有现场价值,因为不同人会对异常程度和降级范围做出不同解释。
| 场景 | 示例触发条件 | 第一负责人 | 立即动作 | 恢复条件 |
|---|---|---|---|---|
| 队列积压 | 积压持续上升并逼近安全水位 | 消息链路负责人 | 降低入口速率,扩消费者 | 积压回落且消费速率稳定 |
| 数据库过载 | CPU 或连接池持续进入危险区间 | 数据库负责人 | 关闭非核心写入,继续收紧下单流量 | 延迟与资源使用恢复安全区间 |
| 缓存异常 | 库存读取超时或错误率突增 | 缓存负责人 | 阻断抢购或切换预定降级路径 | 缓存健康且库存重新核对 |
| 库存不一致 | 订单量与扣减量无法闭合 | 交易负责人 | 立即停止新增销售 | 完成对账并确认不存在继续扩大的差异 |
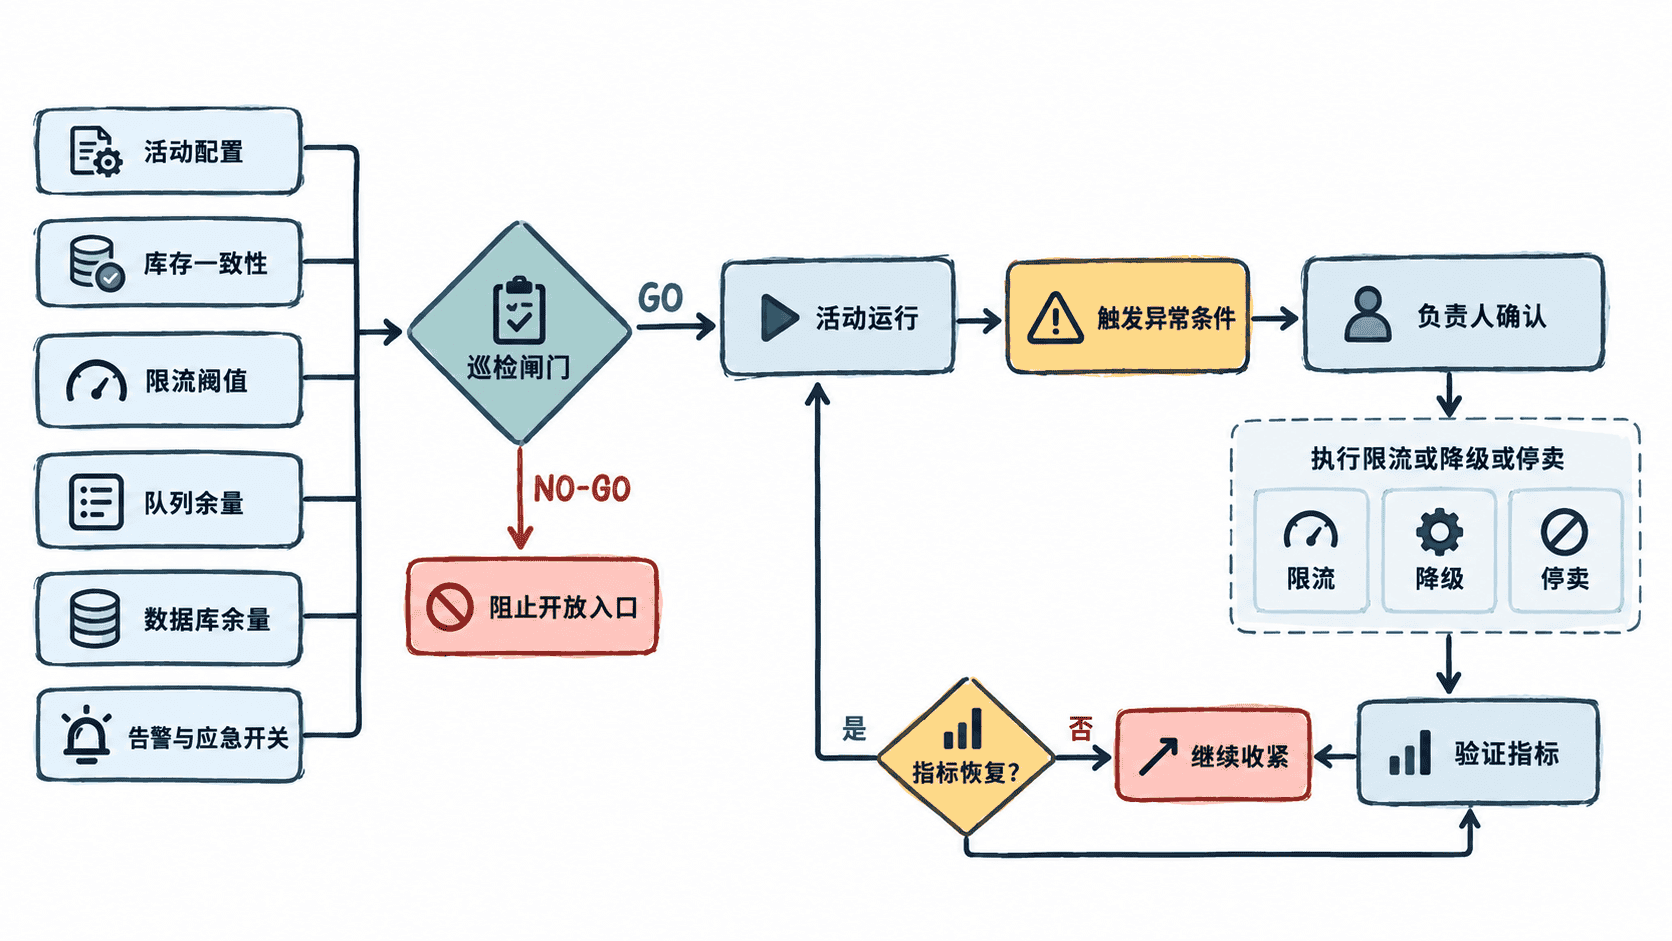
预案中的开关也必须提前验证。一个从未在生产同等环境操作过的“紧急关闭入口”按钮,不能在活动当天第一次使用;关闭后是否阻止新请求、在途请求如何处理、重新开放是否需要重新预热,都应在演练阶段确认。
按现场顺序执行巡检
- 冻结活动配置和发布窗口,记录本次活动使用的版本、库存总量和限流值,避免巡检完成后配置继续变化。
- 核对商品、资格规则和库存来源,再确认缓存预热结果与权威库存一致,任何无法解释的差异都按 NO-GO 处理。
- 检查入口限流、排队容量、消费者实例、数据库连接池及资源余量,并与最近一次有效容量测试结果对照。
- 触发一条测试告警,确认值班人员实际收到;逐个检查限流、降级、熔断和停卖开关的负责人及操作权限。
- 所有负责人共同确认 GO。若任一关键项失败,先执行预案中的修复或缩容方案,再从受影响检查项开始复核,不能口头豁免。
让预案真正能在现场使用
一份合格预案应把决策权限提前写清。例如库存一致性异常可以直接触发停卖,不必等多人讨论;数据库余量不足时由容量负责人决定收紧入口,而不是让数据库值班人员独自承担业务放量决策。
同时要保留活动基线:开场前的库存、队列深度、数据库资源、消费者数量、错误率和主要开关状态。事故发生后只有这些基线还在,团队才能判断异常究竟来自活动流量、临时变更还是原有故障。
最终的放行标准很简单:所有关键风险都必须能够被检测、被明确归属,并有已经验证过的阻断或回退动作。做不到其中任何一项,就应该把结果判为 NO-GO,而不是把未知风险带进活动现场。