
架构与系统设计 / 系统课时
识别秒杀链路的压力来源
识别秒杀链路的压力来源
秒杀系统的危险不只是“请求多”,而是大量请求在极短时间内同时命中少数资源,并把等待、重试和慢依赖继续放大。本篇用四类压力定位最容易失稳的链路,再把现象归到吞吐瓶颈、资源瓶颈或一致性风险。
学习目标
- 识别瞬时并发、热点商品、重复请求和慢依赖分别压垮哪里。
- 根据监控现象区分吞吐瓶颈、资源瓶颈与一致性风险。
- 用压力地图确定限流、缓存、异步化和库存控制的优先级。
先把请求链路画成压力地图
一条典型秒杀链路可以抽象为:客户端发起抢购,入口层做鉴权与限流,商品与库存信息优先从 Redis 读取或扣减,成功请求进入 Kafka,消费者异步创建订单并写入 MySQL,客户端再查询结果。真正要观察的不是组件数量,而是压力在哪一段被放大。
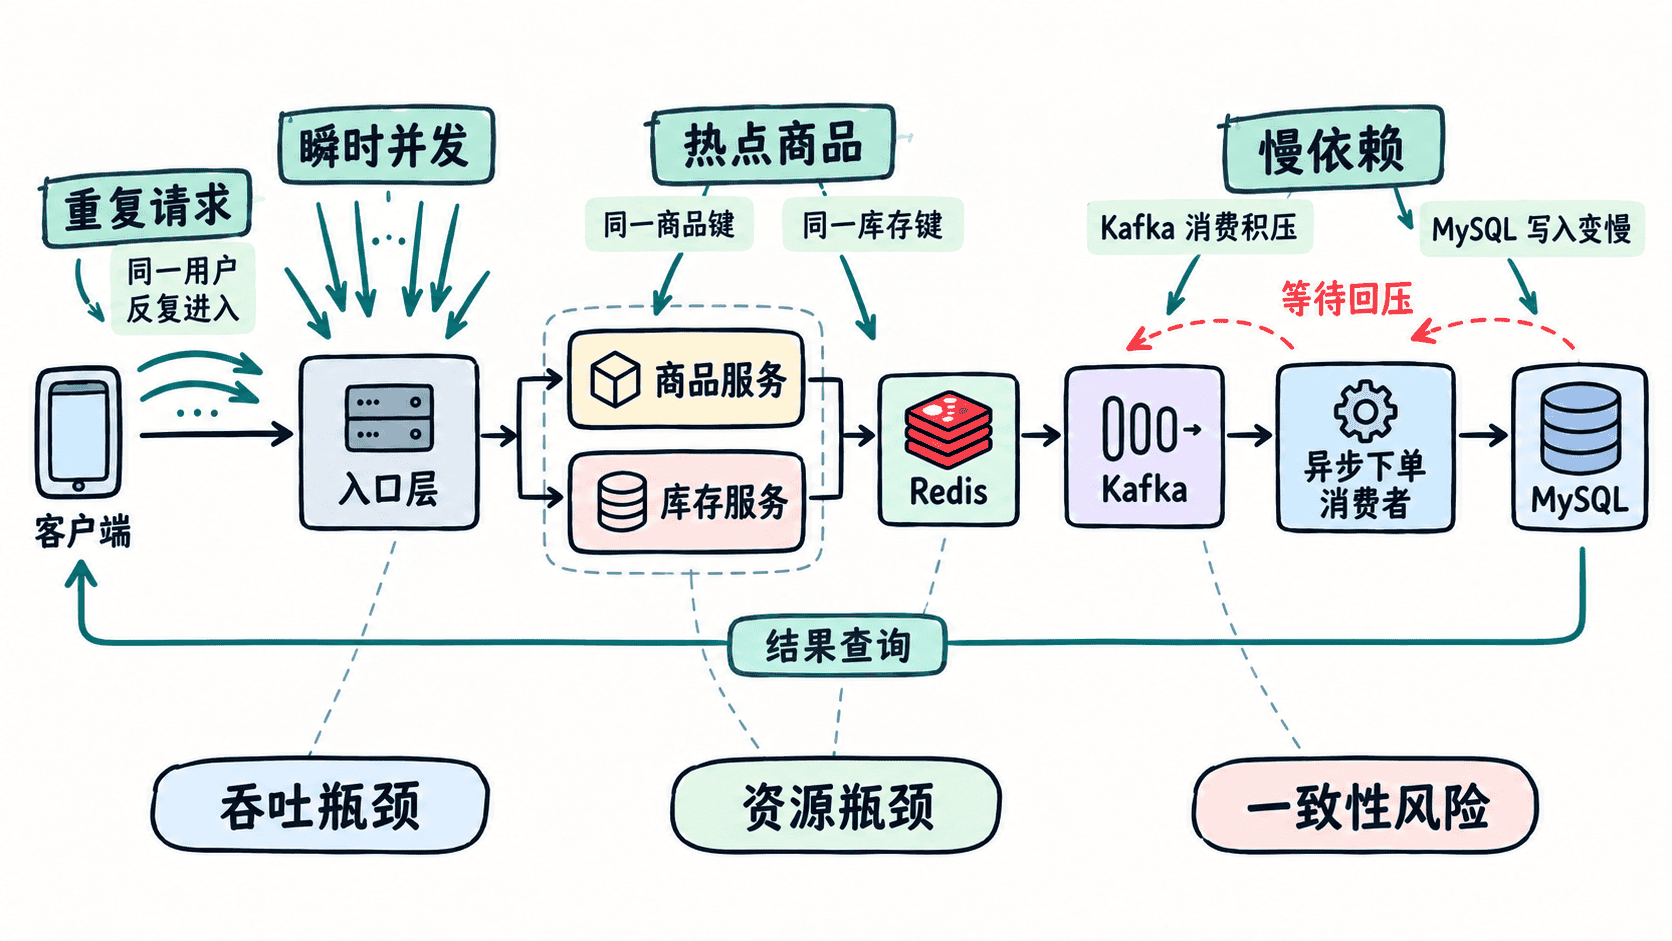
这张图的用法是从左往右问两个问题:这一段能处理多少请求,以及请求失败后会不会继续重试或留下状态差异。前者决定容量,后者决定故障是否会被放大。
四类压力为什么会失稳
瞬时并发强调“短时间同时到达”。如果一分钟平均流量并不高,但大量连接集中在几百毫秒内涌入,线程池、连接池、网卡队列和入口限流器面对的是峰值,而不是平均值。只看分钟均值,会把最关键的尖峰抹平。
热点商品强调“请求集中到同一小部分 key”。即使 Redis 或数据库总体 CPU 还有余量,某个商品库存键、分片或数据库行也可能成为串行竞争点。此时不是整体没容量,而是局部热点先达到上限。
重复请求来自用户连点、客户端超时重试、网关重放或消息重复投递。它会把一次业务意图变成多次资源消耗;如果缺少幂等控制,还可能造成重复扣库存、重复下单等一致性问题。
慢依赖会把下游的慢变成上游的“占着不放”。MySQL 写入抖动、Kafka 消费下降或外部服务超时,都会延长请求或任务的驻留时间,使线程、连接、队列和内存逐渐被占满,最终形成级联拥塞。
区分三种问题类型
吞吐瓶颈的典型特征是请求率继续上升时,某个处理阶段的完成率不再增长,并出现排队或拒绝。入口 CPU、应用线程池、Kafka 生产速率和消费者处理速率都可能成为吞吐上限。
资源瓶颈表现为某类有限资源被占满,例如数据库连接池耗尽、线程数达到上限、Redis 单节点 CPU 持续接近饱和、消息积压占用大量磁盘。它关注的是“什么被耗尽”,不等同于单纯的 QPS 不够。
一致性风险则看业务状态是否可能重复、丢失或越界。库存扣减不是原子操作、重复请求没有幂等键、异步下单成功但结果状态未更新,都可能在系统“还能响应”时已经产生错误数据。
| 观察到的现象 | 更可能的类别 | 首要检查 |
|---|---|---|
| 请求排队变长,但资源尚有余量 | 吞吐瓶颈 | 单阶段处理速率与队列长度 |
| 连接池、线程池或单节点 CPU 打满 | 资源瓶颈 | 被耗尽资源及其占用时长 |
| 出现超卖、重复订单或状态对不上 | 一致性风险 | 原子性、幂等与状态提交边界 |
用三个指标确定先处理哪里
先记录峰值到达率,不要只看平均 QPS;再记录热点集中度,例如最热门商品占总请求的比例;最后记录服务时间与队列长度,判断慢依赖是否在积累等待。
若入口在短时间内就开始拒绝请求,应优先做流量整形和限流;若大多数请求集中到单个库存 key,应优先检查原子扣减和热点隔离;若 Kafka 积压随数据库延迟一起上升,应优先保护消费者和数据库,而不是继续扩大入口并发。
建立秒杀基线时,最有价值的产物不是一个“最大 QPS”数字,而是一张能回答“压力从哪里来、在哪里被放大、最后伤到什么”的链路地图。后续每项优化都应能明确对应其中一个失稳点。