
架构与系统设计 / 系统课时
构造符合业务分布的压测流量
构造符合业务分布的压测流量
压测的目标不是制造尽可能高的 QPS,而是复现活动流量里真正会击穿系统的分布。本节把商品热度、重复用户、读写比例和突发波形组合成可执行的压测模型,并为每种流量特征绑定要验证的系统假设与通过标准。
学习目标
- 把真实业务特征转换成商品、用户、请求类型和时间四个维度的流量分布
- 使用分阶段压测脚本同时模拟热点倾斜、重复请求和突发流量
- 为压测场景定义延迟、错误率和业务正确性等可判定的通过标准
从业务分布而不是平均值建模
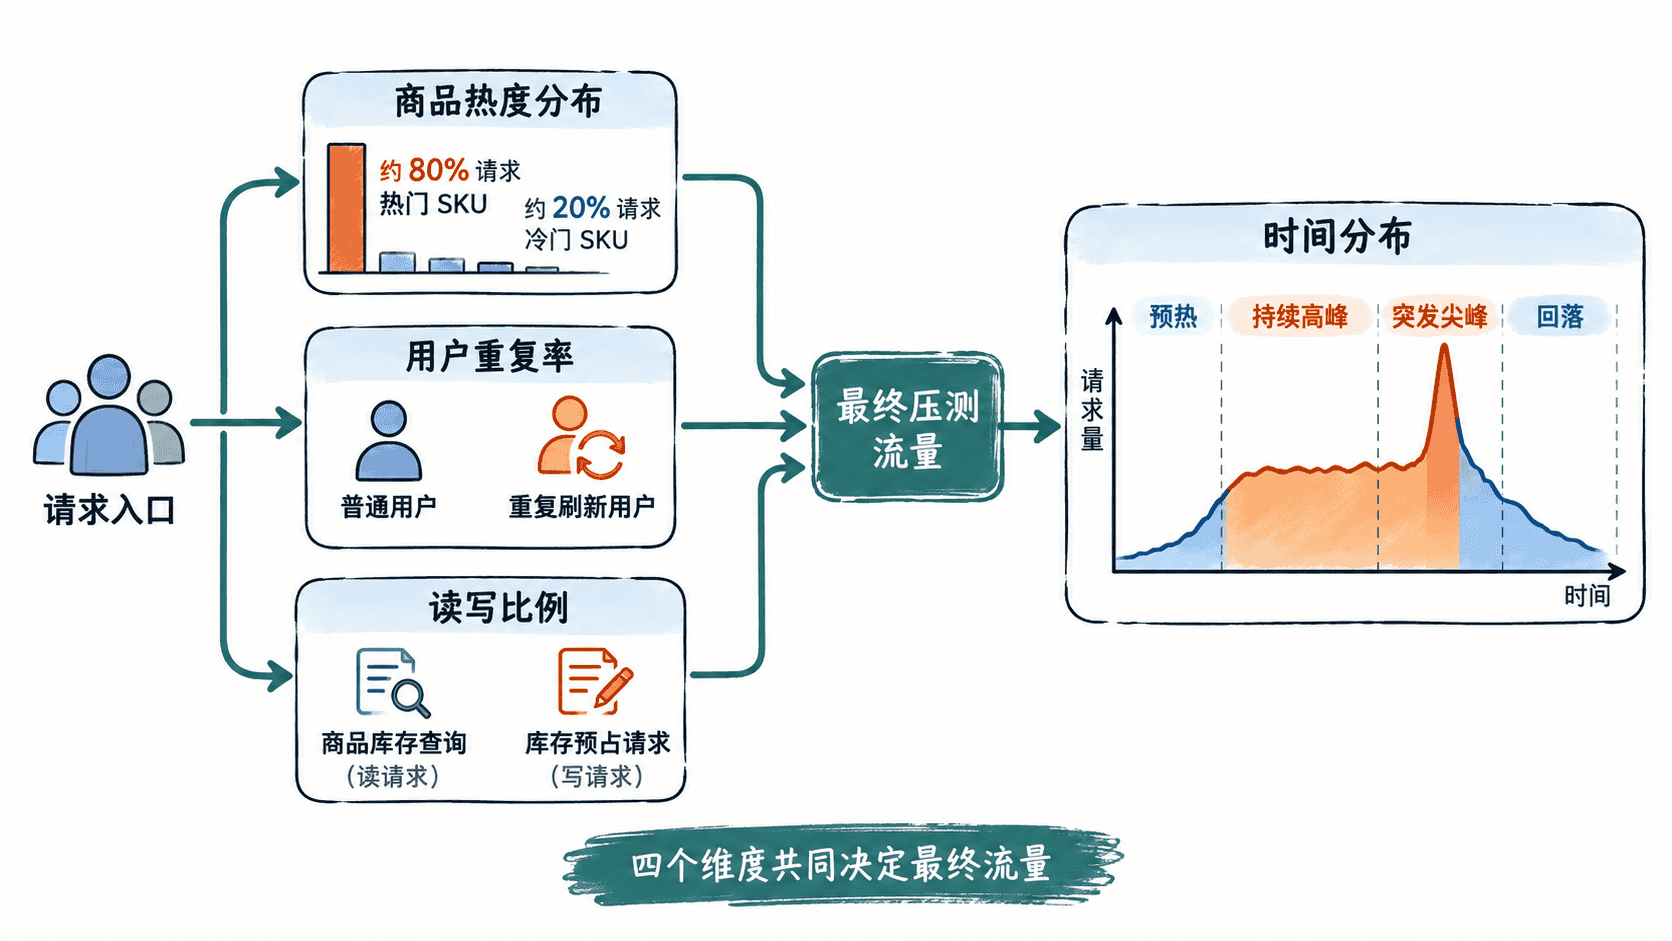
秒杀流量通常高度倾斜。假设活动有 100 个商品,但 80% 请求集中在少数热门 SKU,那么把请求均匀随机到 100 个商品会显著低估热点库存行、缓存 Key 和分区队列承受的压力。用户也不是完全独立的:刷新页面、重复点击和客户端重试会让同一用户在短时间内产生多次请求。
一个最小但有用的流量模型至少记录四个维度:热门商品占比、重复用户比例、读写混合以及随时间变化的并发波形。每个参数都应来自历史活动、灰度活动或容量假设,而不是为了让曲线好看随意填写。
把场景绑定到系统假设
压测参数只有和假设绑定才有意义。下面的数字是教学示例,实际阈值应替换为系统自己的 SLO 和容量基线。
| 流量特征 | 要验证的假设 | 示例通过标准 |
|---|---|---|
| 80% 请求命中热门 SKU | 热点缓存、库存扣减与分片不会因单 Key 过热失稳 | P99 小于 500 ms,失败率低于 1% |
| 约 30% 用户重复出现 | 幂等、限频和重复请求处理不会放大库存写入 | 不出现同一业务请求重复扣减 |
| 约 70% 查询、30% 预占 | 读流量不会掩盖写路径瓶颈 | 写请求延迟和失败率分别达标 |
| 短时间从稳定负载升到尖峰 | 线程池、连接池和队列能吸收突发 | 尖峰后延迟能够回落且无持续积压 |
通过标准不要只写“服务不挂”。服务虽然持续返回响应,但如果 P99 从 200 ms 上升到数秒、库存出现超卖或消息积压持续增长,容量验证仍然失败。
用 k6 组合四类流量特征
下面脚本假设被测服务通过环境变量 BASE_URL 提供地址。80% 请求落到热门商品集合,约 30% 请求使用重复用户身份,并按 70% 查询、30% 库存预占混合执行。stages 则制造预热、持续压力、突发尖峰和回落过程。
import http from 'k6/http';
import { check, sleep } from 'k6';
import { Counter } from 'k6/metrics';

export const options = {
  stages: [
    { duration: '30s', target: 100 },
    { duration: '1m', target: 100 },
    { duration: '15s', target: 500 },
    { duration: '45s', target: 500 },
    { duration: '30s', target: 0 },
  ],
  thresholds: {
    http_req_failed: ['rate<0.01'],
    http_req_duration: ['p(99)<500'],
    checks: ['rate>0.99'],
  },
};

const detailReads = new Counter('detail_reads');
const reserveAttempts = new Counter('reserve_attempts');
const hotSkus = ['sku-hot-1', 'sku-hot-2', 'sku-hot-3'];
const coldSkus = Array.from({ length: 20 }, (_, i) => `sku-cold-${i + 1}`);

function pick(list) {
  return list[Math.floor(Math.random() * list.length)];
}

function pickSku() {
  // 热门集合承接大多数请求,用于暴露单 Key 和单分区热点。
  return Math.random() < 0.8 ? pick(hotSkus) : pick(coldSkus);
}

function pickUser() {
  // 一部分虚拟用户反复使用相同身份,模拟刷新、重试和重复点击。
  return Math.random() < 0.3 ? `repeat-${__VU % 20}` : `user-${__VU}-${__ITER}`;
}

export default function () {
  const baseUrl = __ENV.BASE_URL || 'http://localhost:8080';
  const sku = pickSku();
  const userId = pickUser();
  let response;

  if (Math.random() < 0.7) {
    detailReads.add(1);
    response = http.get(`${baseUrl}/api/stock/${sku}`, {
      headers: { 'X-User-Id': userId },
      tags: { request_type: 'stock_read', sku },
    });
  } else {
    reserveAttempts.add(1);
    response = http.post(
      `${baseUrl}/api/reservations`,
      JSON.stringify({ sku, userId, quantity: 1 }),
      {
        headers: { 'Content-Type': 'application/json', 'X-User-Id': userId },
        tags: { request_type: 'reserve', sku },
      }
    );
  }

  // 库存售罄导致的 409 属于预期业务结果,不应直接算系统故障。
  check(response, {
    'business response is acceptable': (r) => r.status === 200 || r.status === 409,
  });
  sleep(0.1);
}
将脚本保存为 flash-sale.js,然后执行:
BASE_URL=http://<HOST>:<PORT> k6 run flash-sale.js预期输出
checks................: >= 99%
http_req_failed........: < 1%
http_req_duration......: p(99) < 500ms
detail_reads...........: <COUNT>
reserve_attempts.......: <COUNT><HOST>、<PORT> 和 <COUNT> 会随环境和运行结果变化。如果阈值未满足,k6 会将对应 threshold 标记为失败;具体延迟值和请求数量不应预先写死。
分层调整流量而不是只提高并发
第一次压测先保持商品分布、用户重复率和读写比例不变,只提升并发,用来寻找整体容量边界。随后分别提高热门 SKU 占比、重复用户比例或写请求比例,才能判断瓶颈来自总流量还是特定业务分布。
突发验证也应和稳定容量分开观察。稳定阶段用于判断系统可长期承受的负载,尖峰阶段则重点检查线程池、连接池、消息队列和限流器有没有形成持续积压。尖峰结束后如果队列长度、P99 延迟和错误率不能回落,即使瞬时流量已经下降,也说明系统没有真正恢复。
最终保留下来的压测模型应记录流量参数、系统假设和通过标准三者的对应关系。这样下一次扩容或架构调整后运行同一场景,比较的才是系统能力变化,而不是两次完全不同的随机流量。