
架构与系统设计 / 系统课时
限制数据库并发保护连接池
限制数据库并发保护连接池
秒杀入口即使已经限流,应用仍可能把过多请求同时压向数据库。本节把数据库连接视为有限预算,通过连接池上限、获取超时和请求侧并发门槛形成三层保护,并用指标区分“连接池排队”与“SQL 本身变慢”,避免扩容应用实例时反而放大数据库压力。
学习目标
- 根据数据库容量与应用实例数计算单实例连接并发上限
- 配置连接池上限、获取超时,并在请求侧增加更早的并发门槛
- 根据等待连接时间与 SQL 执行时间判断瓶颈位于连接池还是数据库
先给数据库并发做预算
连接池大小不能按应用机器配置随意设置。假设数据库在当前 SQL、索引和硬件条件下稳定承受 240 个活跃连接,其中预留 40 个给管理任务、迁移和其他服务,则秒杀服务只有约 200 个连接预算。
如果服务部署 10 个实例,单实例连接池上限首先应控制在约 20,而不是每台都配置 100。扩容到 20 个实例后,如果仍保持每实例 20 个连接,理论连接总量会从 200 翻到 400,扩应用实例反而可能把数据库拖入上下文切换、锁竞争和磁盘排队。
可以用下面的关系做第一版容量约束:单实例连接上限不应超过“服务可用数据库并发预算 ÷ 最大应用实例数”。实际值还要通过压测验证,并给突发流量留出安全余量。
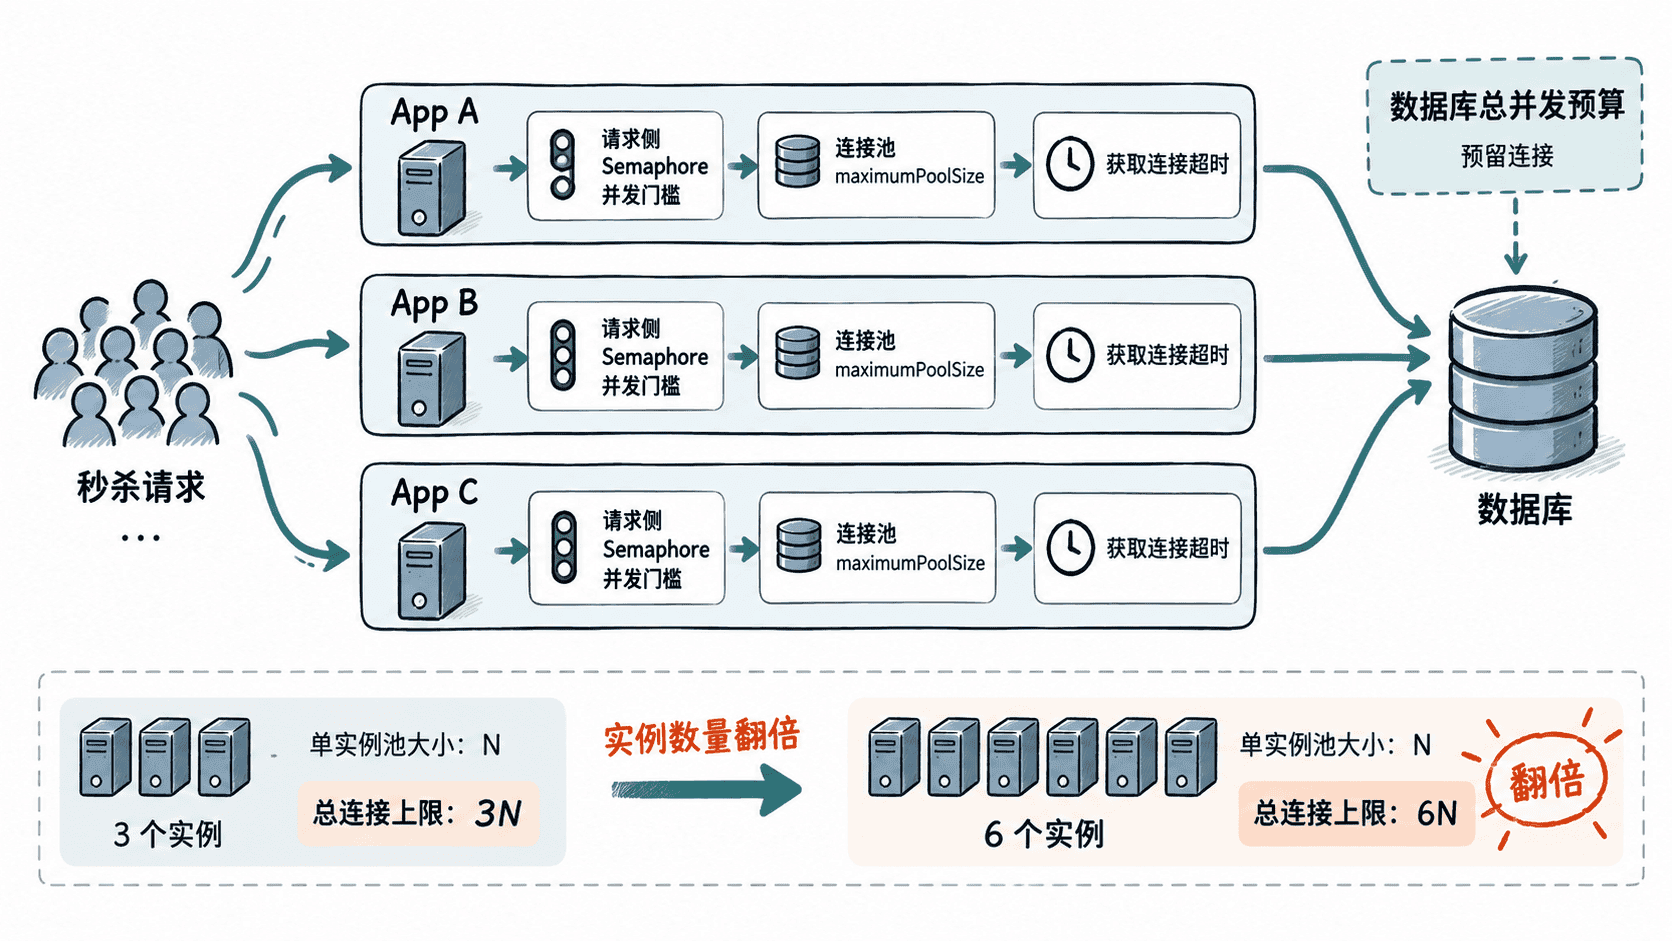
把门槛放在连接池之前
仅设置连接池上限可以保护数据库,却可能让大量业务线程堵在“等待连接”阶段。更稳妥的做法是在请求进入数据库操作前再设置一个并发门槛,让超额请求尽早失败或降级,而不是无限占用线程、内存和请求超时时间。
下面用 JDK 自带的 Semaphore 模拟请求侧数据库并发门槛。示例允许最多两个请求同时进入数据库区段,其余请求最多等待 100 毫秒;拿不到许可就快速拒绝。
import java.util.concurrent.Semaphore;
import java.util.concurrent.TimeUnit;

public class DbConcurrencyGateDemo {
    private static final Semaphore DB_GATE = new Semaphore(2);

    public static void main(String[] args) throws InterruptedException {
        Thread[] workers = new Thread[5];
        for (int i = 0; i < workers.length; i++) {
            int requestId = i + 1;
            workers[i] = new Thread(() -> handle(requestId));
            workers[i].start();
        }
        for (Thread worker : workers) {
            worker.join();
        }
    }

    private static void handle(int requestId) {
        boolean acquired = false;
        try {
            // 门槛应不大于连接池上限,让过载请求在占用连接前结束。
            acquired = DB_GATE.tryAcquire(100, TimeUnit.MILLISECONDS);
            if (!acquired) {
                System.out.println("request=" + requestId + " rejected");
                return;
            }

            System.out.println("request=" + requestId + " entered-db-section");
            Thread.sleep(300);
        } catch (InterruptedException e) {
            Thread.currentThread().interrupt();
        } finally {
            if (acquired) {
                DB_GATE.release();
            }
        }
    }
}
预期输出中,请求编号顺序可能因线程调度不同,但同时只有两个请求能够进入数据库区段,其余请求会在约 100 毫秒内被拒绝:
request=<ID> entered-db-section
request=<ID> entered-db-section
request=<ID> rejected
request=<ID> rejected
request=<ID> rejected
<ID> 为实际线程抢占顺序对应的请求编号。生产环境通常把这层门槛放在数据库访问入口,并将许可数设置为不高于该实例连接池的有效并发数。
配置连接池上限和获取超时
以常见连接池配置为例,核心不是把池调大,而是让上限和等待时间都有明确边界。下面是 Spring Boot 使用 HikariCP 时的片段示例,依赖已有的数据源地址、驱动和认证配置。
spring:
  datasource:
    hikari:
      maximum-pool-size: 20
      minimum-idle: 5
      connection-timeout: 200
这里 maximum-pool-size 限制单实例最多持有的池连接,connection-timeout 表示请求等待连接超过 200 毫秒就失败。该配置本身不会证明“20”一定合理,验证时还应同时观察数据库活跃连接、CPU、锁等待、磁盘延迟以及应用侧连接等待时间。
区分连接池排队和慢 SQL
两种故障都可能表现为接口变慢,但处理方向完全不同。建议把一次数据库访问拆成至少两个时间段:等待获得连接的时间与拿到连接后的 SQL 执行时间。
| 观察现象 | 更可能的瓶颈 | 优先动作 |
|---|---|---|
| 获取连接耗时升高,SQL 执行仍稳定 | 池已满或入口并发过高 | 收紧请求并发、检查池大小与实例数 |
| 获取连接很快,SQL 执行耗时升高 | SQL、锁、索引或数据库资源瓶颈 | 查慢 SQL、执行计划、锁等待和 I/O |
| 两者同时升高 | 数据库变慢导致连接长期不归还,继而池排队 | 先定位 SQL/数据库根因,再评估入口并发 |
当数据库已经处于饱和区,简单增加 maximum-pool-size 往往只会让更多 SQL 同时竞争 CPU、锁和 I/O,使单条 SQL 更慢,连接归还更晚,最终形成“慢 SQL → 池耗尽 → 更多线程排队”的正反馈。
扩应用实例时重新计算总连接数
连接池配置是单实例参数,数据库承受的是所有实例之和。因此自动扩容策略必须和数据库连接预算联动。假设服务最多扩到 25 个实例,而数据库只愿意给该服务 200 个连接,那么单实例池上限就不能继续保持 20,应重新压到约 8,或通过独立数据库代理、分库等方式改变容量边界。
生产验收时至少检查三个条件:峰值期间数据库总活跃连接没有长期贴顶;连接获取超时只在过载时少量出现而非持续发生;增加应用实例后数据库 CPU、锁等待和 SQL 延迟没有同步恶化。连接池真正承担的是“把数据库并发限制在可恢复范围内”,而不是尽可能多地缓存连接。