
架构与系统设计 / 系统课时
完成端到端秒杀系统演练
完成端到端秒杀系统演练
端到端演练要证明的不只是峰值 QPS 能跑起来,而是从预热、开放入口、库存扣减、排队、异步下单到售罄和故障恢复都能形成闭环。本节用一次完整演练同时验证容量、幂等、一致性、降级和恢复能力。
学习目标
- 组织覆盖预热、抢购、异步下单、售罄和恢复的完整演练流程
- 在压测过程中注入消费者、缓存或数据库故障,并判断降级行为是否符合设计
- 用库存、订单、请求和监控证据判断幂等、一致性及恢复是否真正通过验收
先定义演练验收口径
没有验收口径的压测很容易变成“机器没挂,所以通过”。演练开始前应锁定目标并保存基线,使容量和正确性都能被客观判断。
| 验收维度 | 需要证明的事实 |
|---|---|
| 容量 | 目标入口速率下限流生效,核心服务没有超过已验证容量 |
| 幂等 | 重试或重复请求不会产生重复订单和重复扣减 |
| 一致性 | 初始库存、成功占用、最终订单和剩余库存能够对账 |
| 削峰 | 突发请求进入队列后,下游消费速率保持在安全范围 |
| 降级 | 故障出现时能够快速限流、拒绝或暂停,而不是拖垮整条链路 |
| 恢复 | 故障解除后积压可消化,服务恢复且不会二次扣减或重复下单 |
尤其不能只盯平均响应时间。秒杀入口允许大量请求被限流或快速返回售罄,但已经接受的库存占用必须有清晰归宿,否则入口看似稳定,后台却可能积累一致性问题。
跑通一次完整生命周期
下面用一个可运行的最小演练模型复现核心链路:预热 3 件库存、开放入口、提交抢购请求、过滤重复请求、异步创建订单,并在消费者处理 r2 时注入一次崩溃。真实演练时应把这些函数替换为实际 HTTP、消息队列和数据库探针,但验收思路相同。
from collections import deque


def main():
    stock = 3
    opened = False
    queue = deque()
    accepted = set()
    orders = {}
    attempts = {}

    def submit(user_id, request_id):
        nonlocal stock
        if not opened:
            return f'submit={request_id} result=closed'
        # 幂等检查必须早于库存扣减,避免重试重复占库存。
        if request_id in accepted:
            return f'submit={request_id} result=duplicate'
        if stock == 0:
            return f'submit={request_id} result=sold_out'
        stock -= 1
        accepted.add(request_id)
        queue.append((user_id, request_id))
        return f'submit={request_id} result=queued stock={stock}'

    print(f'stage=warmup inventory={stock}')
    opened = True
    print('stage=open')

    requests = [
        ('u1', 'r1'),
        ('u2', 'r2'),
        ('u1', 'r1'),
        ('u3', 'r3'),
        ('u4', 'r4'),
    ]
    for user_id, request_id in requests:
        print(submit(user_id, request_id))

    while queue:
        user_id, request_id = queue.popleft()
        attempts[request_id] = attempts.get(request_id, 0) + 1
        # 模拟消费者首次处理 r2 后崩溃,随后依赖重试恢复。
        if request_id == 'r2' and attempts[request_id] == 1:
            print('fault=worker_crash request=r2 action=retry')
            queue.append((user_id, request_id))
            continue
        orders[request_id] = f'o-{request_id[-1]}'
        print(f'order={orders[request_id]} request={request_id} status=created')

    # 最终断言同时验证库存、订单数和幂等结果。
    assert stock == 0
    assert len(orders) == 3
    assert set(orders) == {'r1', 'r2', 'r3'}
    print('stage=sold_out')
    print('stage=recovery state=healthy')
    print(f'acceptance=pass stock={stock} orders={len(orders)}')


if __name__ == '__main__':
    main()
预期输出
stage=warmup inventory=3
stage=open
submit=r1 result=queued stock=2
submit=r2 result=queued stock=1
submit=r1 result=duplicate
submit=r3 result=queued stock=0
submit=r4 result=sold_out
order=o-1 request=r1 status=created
fault=worker_crash request=r2 action=retry
order=o-3 request=r3 status=created
order=o-2 request=r2 status=created
stage=sold_out
stage=recovery state=healthy
acceptance=pass stock=0 orders=3
这个模型刻意让失败发生在“请求已被接受、订单尚未完成”的中间阶段,因为这里最容易暴露幂等缺陷。消费者恢复后可以重新处理 r2,但最终仍只能生成一个对应订单。
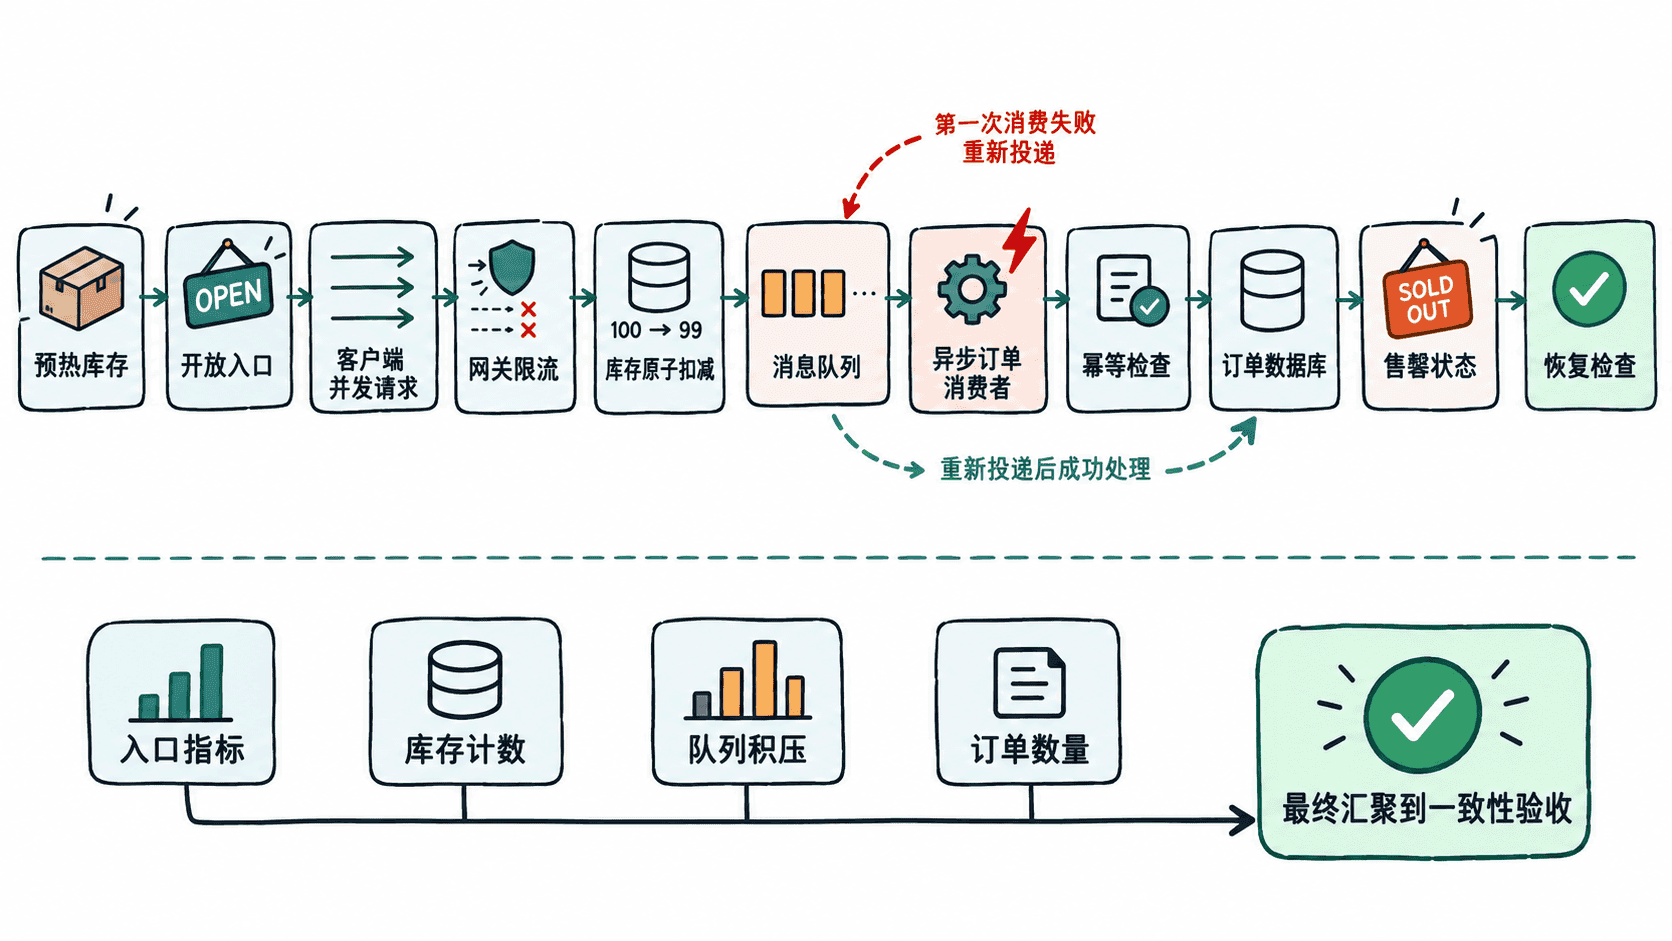
按阶段执行真实演练
- 演练开始前冻结版本,记录权威库存、缓存库存、队列深度、消费者数量、数据库资源和所有应急开关状态,并确认监控数据能够实时查看。
- 执行缓存和库存预热,但保持用户入口关闭。用探针请求验证活动配置、鉴权、库存读取和消息链路,确认基线正常后再进入放量阶段。
- 开放入口并逐级提升请求速率,观察通过量、限流量、库存扣减速率、队列积压和数据库写入速率。入口继续升压时,下游吞吐应被限流和队列约束在安全范围内。
- 在稳定负载阶段注入故障,例如暂停部分消费者、制造短时缓存延迟或限制数据库写入能力,并观察系统是否按照预案快速限流或降级。
- 恢复故障组件后停止继续升压,等待队列积压消化,再让库存自然进入售罄状态。最后关闭活动入口并执行库存、请求和订单对账。
每一个阶段都应记录开始条件、关键指标和结束条件。否则故障发生后只能看到一段混合曲线,很难判断是升压导致容量耗尽,还是故障注入改变了系统行为。
注入能暴露设计缺陷的故障
故障注入不需要追求数量,而要覆盖关键假设。暂停订单消费者可以验证队列是否真正削峰以及恢复后能否安全重放;制造缓存超时可以验证系统是否会快速失败,而不是大量请求穿透到数据库;限制数据库能力则可以检查入口限流是否能保护最慢的下游资源。
对每个故障都先写出预期行为。例如消费者停止后,允许队列积压上升,但入口延迟不应无限增加;数据库进入危险区间后,应主动降低接纳速率,而不是等连接池耗尽后被动超时;恢复后则必须确认积压下降且没有重复订单。
用四条证据链完成验收
容量证据要把入口速率与各层实际吞吐对应起来。达到目标负载时,网关、库存服务、队列消费者和数据库都应位于已经验证过的安全区间,不能只凭入口 QPS 宣布成功。
幂等证据要主动制造重复请求和消息重投。相同业务请求经过重试后,只能保留一个有效订单结果;如果系统依赖数据库唯一键兜底,也要确认冲突不会继续触发重复扣减或异常重试风暴。
一致性证据需要在演练结束后对账。核心关系是初始可售库存减去成功占用量应等于剩余库存,而成功占用最终必须能够解释为有效订单、已补偿失败或其他明确终态,不能存在长期悬空记录。
降级与恢复证据则关注故障前、故障中和恢复后三段数据。故障中系统应进入预期保护状态,恢复后积压和错误率应回落,消费者重启或消息重投不能再次破坏库存和订单的一致性。
演练通过的标志不是“最终服务恢复了”,而是整条链路在高压与故障下仍表现出预先设计的行为,并且每一个结论都能由请求、库存、队列、订单和监控数据共同证明。若任何一条证据无法闭合,就应把它转成活动前必须修复的风险,而不是在复盘中简单标记为偶发现象。