
架构与系统设计 / 系统课时
设计订单分库分表路由
设计订单分库分表路由
订单写入量超过单库容量后,真正困难的不是“多建几张表”,而是让新订单、按用户查询和按订单号查询都能稳定找到同一分片。本课从分片键、虚拟槽位、订单号与跨分片查询入手,设计一条可扩容且可验证的路由链路。
学习目标
- 选择稳定分片键,并根据容量与峰值写入估算初始库表数量。
- 用固定虚拟槽位隔离业务键与物理库表,降低后续扩容迁移成本。
- 处理订单号定位、热点倾斜和跨分片查询,避免扩写入能力却放大查询复杂度。
先固定业务路由约束
分片键必须来自订单创建时就确定、之后不会变化的字段。若核心访问模式是“用户下单后查看自己的订单”,user_id 通常比活动 ID 更稳定:同一用户的订单可以落在固定路由上,用户订单列表不需要扫所有分片。
活动 ID 往往在秒杀场景中高度集中。直接按 activity_id 分片会把同一场活动的订单打到少数分片,最容易在峰值时制造热点。订单状态也不能做分片键,因为状态会更新,一旦路由字段变化就意味着搬迁整行。
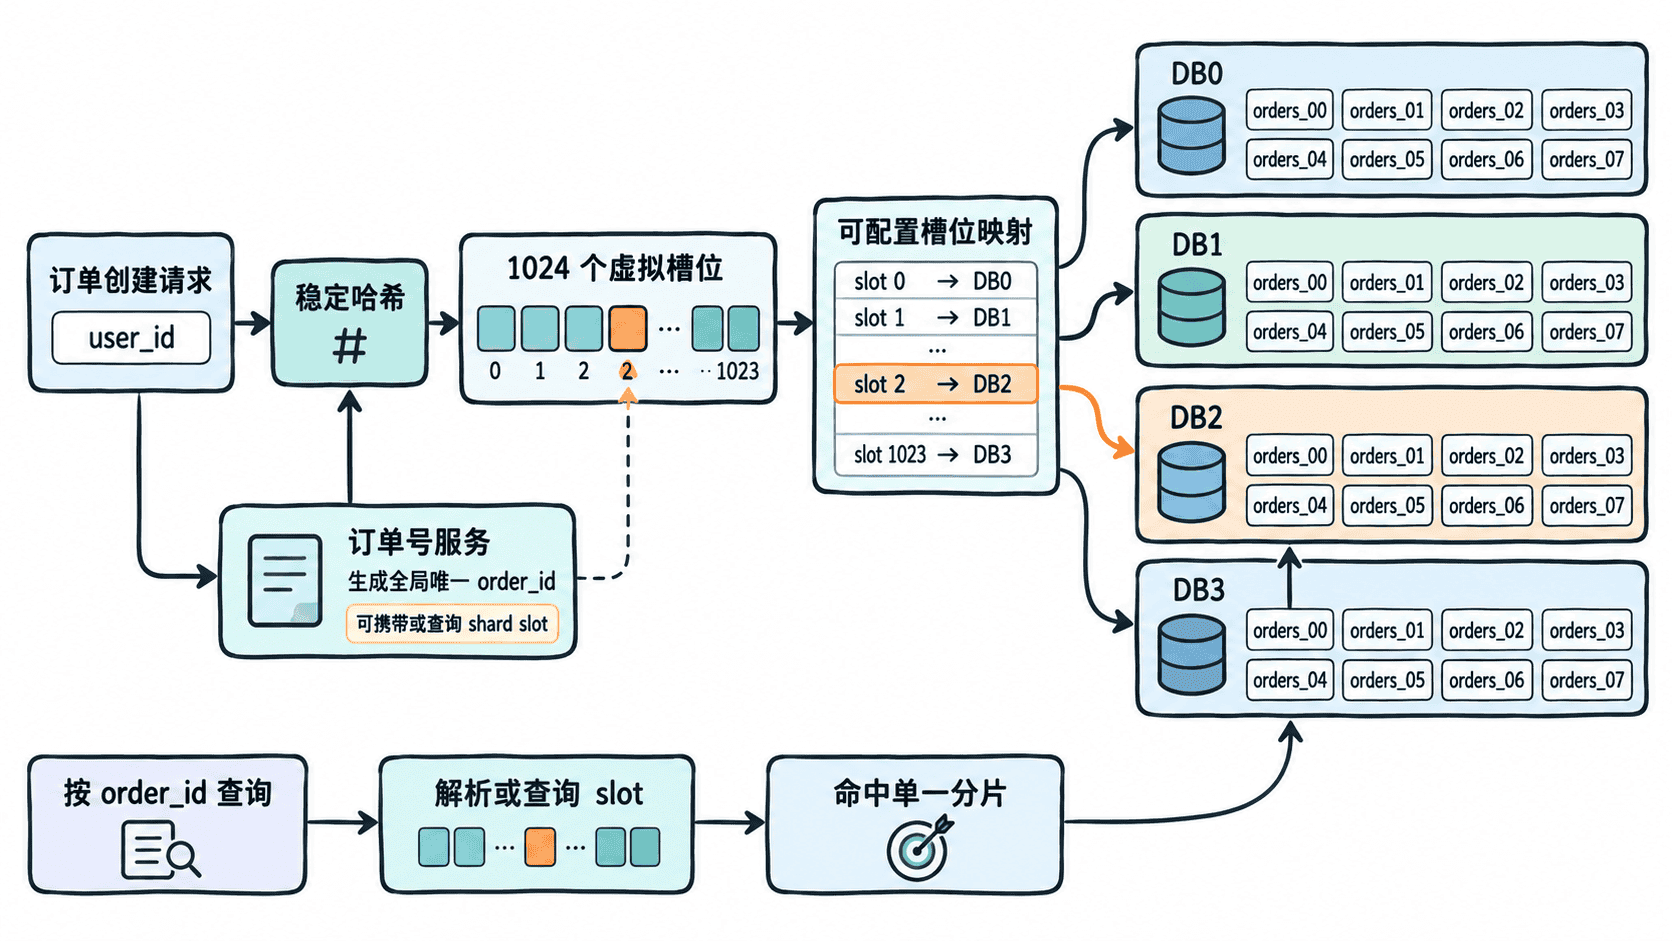
路由一旦对外生效,就要把“同一个分片键永远映射到同一个逻辑槽位”当作协议。不要在扩容时直接把取模从 32 改成 64,否则几乎所有旧键都会重新映射,查询和迁移会同时失控。
用虚拟槽隔离业务键与物理分片
一种易维护的做法是先把 user_id 稳定哈希到固定数量的虚拟槽,例如 1024 个,再由配置表把虚拟槽映射到当前物理库表。扩容时只迁移选中的槽位,并更新映射,不改变业务键到槽位的计算规则。
下面的 Python 程序演示 4 个库、每库 8 张表时的确定性路由。这里用 CRC32 只是为了得到跨进程稳定的示例哈希;生产系统应把哈希算法和槽位数量作为长期协议固定下来。
import zlib

DB_COUNT = 4
TABLES_PER_DB = 8
VIRTUAL_SLOTS = 1024

def route(user_id: int):
    raw = str(user_id).encode("utf-8")
    # CRC32 在这里用于演示稳定哈希,避免 Python 内置 hash 的进程随机化。
    slot = zlib.crc32(raw) % VIRTUAL_SLOTS

    # 当前阶段把 1024 个虚拟槽均匀映射到 32 个物理分片。
    physical = slot % (DB_COUNT * TABLES_PER_DB)
    db_index = physical // TABLES_PER_DB
    table_index = physical % TABLES_PER_DB
    return slot, db_index, table_index

for user_id in (10001, 10002, 10003):
    slot, db_index, table_index = route(user_id)
    print(
        f"user={user_id} slot={slot} "
        f"db=order_db_{db_index} table=orders_{table_index:02d}"
    )
预期输出
user=10001 slot=467 db=order_db_2 table=orders_03
user=10002 slot=105 db=order_db_1 table=orders_01
user=10003 slot=255 db=order_db_3 table=orders_07
相同 user_id 在任何应用实例上都应得到同一槽位。真正做弹性扩容时,不应修改 VIRTUAL_SLOTS;应把“槽位到物理分片”的关系放进版本化配置,例如把一部分槽从旧库表迁到新库表,并在迁移期间支持双读校验或短暂双写。
让订单号也能找到唯一分片
订单创建时,应用已经知道 user_id,因此可以直接计算分片;但售后、支付回调或客服系统常常只拿到 order_id。这时必须提前设计订单号到分片的定位方式,否则按订单号查询就会退化成扫描所有库表。
常见做法有两种:订单号中编码虚拟槽位,查询时直接解析;或者维护一张轻量的 order_id -> slot 定位索引。前者查询更直接,但订单号生成协议更难修改;后者更灵活,却多一次索引读取。无论选哪种,都应使用全局唯一 ID 服务或可靠的分段号方案,避免依赖每张分表自己的自增主键。
单个物理分表应保持同构。下面是片段示例,假设使用 MySQL 8,完整部署需要为所有目标分表创建等价结构。
CREATE TABLE orders_03 (
    order_id BIGINT NOT NULL,
    user_id BIGINT NOT NULL,
    activity_id BIGINT NOT NULL,
    status TINYINT NOT NULL,
    created_at DATETIME(3) NOT NULL,
    PRIMARY KEY (order_id),
    KEY idx_user_time (user_id, created_at),
    KEY idx_activity_time (activity_id, created_at)
) ENGINE=InnoDB;
这组索引服务两类常见局部查询:按用户分页查看订单,以及在已知分片范围内按活动排查订单。验证时应确认每个物理表结构一致,并检查路由层生成的表名只来自受控映射,不能把外部输入直接拼接成库表名。
预估库表数量而不是凭感觉切分
库表数量要同时受容量、写入吞吐和运维成本约束。先估算单表在目标保留周期内能承受的行数与索引体积,再用峰值写入压测确认单库写能力,最后给增长留出余量。初始分片过少会很快二次迁移,过多则增加连接池、DDL、监控、备份和跨分片查询成本。
虚拟槽能降低扩容时的重映射范围,但不能消除热点。如果少数大买家、机器人账号或渠道账号贡献了异常高的订单量,仅按 user_id 仍可能让某些槽过热。此时应先识别热点键,再考虑对特殊主体增加二级散列或独立路由规则,同时保证查询端知道如何聚合这些子分片。
把跨分片查询限制在离线和检索链路
交易主链路应尽量做到“带分片键访问”。运营按时间范围、活动、地区或商品做全局检索时,不要让在线数据库临时广播查询所有分表;更适合把订单变更同步到搜索引擎、分析库或数仓,再承接跨维度查询。
订单分库分表的可维护性取决于路由协议是否长期稳定:业务键先落固定虚拟槽,槽位再映射物理库表,订单号能够反向定位槽位,跨分片分析走独立读模型。这样扩写入能力时,迁移范围和查询代价才是可控的。