
架构与系统设计 / 系统课时
用阶梯加压找到系统拐点
用阶梯加压找到系统拐点
阶梯加压的目标不是把系统“打挂”,而是找出负载继续增加后,吞吐不再线性增长、尾延迟和排队开始恶化的那个拐点。你会用固定台阶逐级施压,并把 QPS、P99、错误率、队列长度和资源利用率放在同一组观察窗口里判断容量边界。
学习目标
- 设计可重复的阶梯压测,让每个台阶都有稳定观察窗口
- 用吞吐、尾延迟、错误率、排队和资源利用率识别拐点
- 区分真实容量拐点与短时抖动、预热或监控噪声
先把压测做成可比较的台阶
一次把流量从低位拉到极高值,只能得到“系统撑不住”的结论,无法知道从哪一级开始失去稳定性。更有效的做法是让每个台阶保持相同持续时间,例如从 100 req/s 开始,每两分钟增加 100 req/s,并在每个台阶前留出短暂爬升时间。
每一级至少记录五类信号:实际完成 QPS、P99、错误率、业务或中间件队列长度,以及 CPU、内存、线程、连接等关键资源利用率。施加流量和实际吞吐必须分开记录,因为系统接近饱和后,两者会明显分离。
看懂拐点的组合信号
真正有价值的拐点通常不是某一个指标刚好越过阈值,而是多个信号同时改变关系。典型现象是:施加流量继续上涨,但实际 QPS 增幅明显变小;P99 开始成倍上升;错误率从接近零变成持续增长;队列长度不再回落;某项资源持续接近饱和。
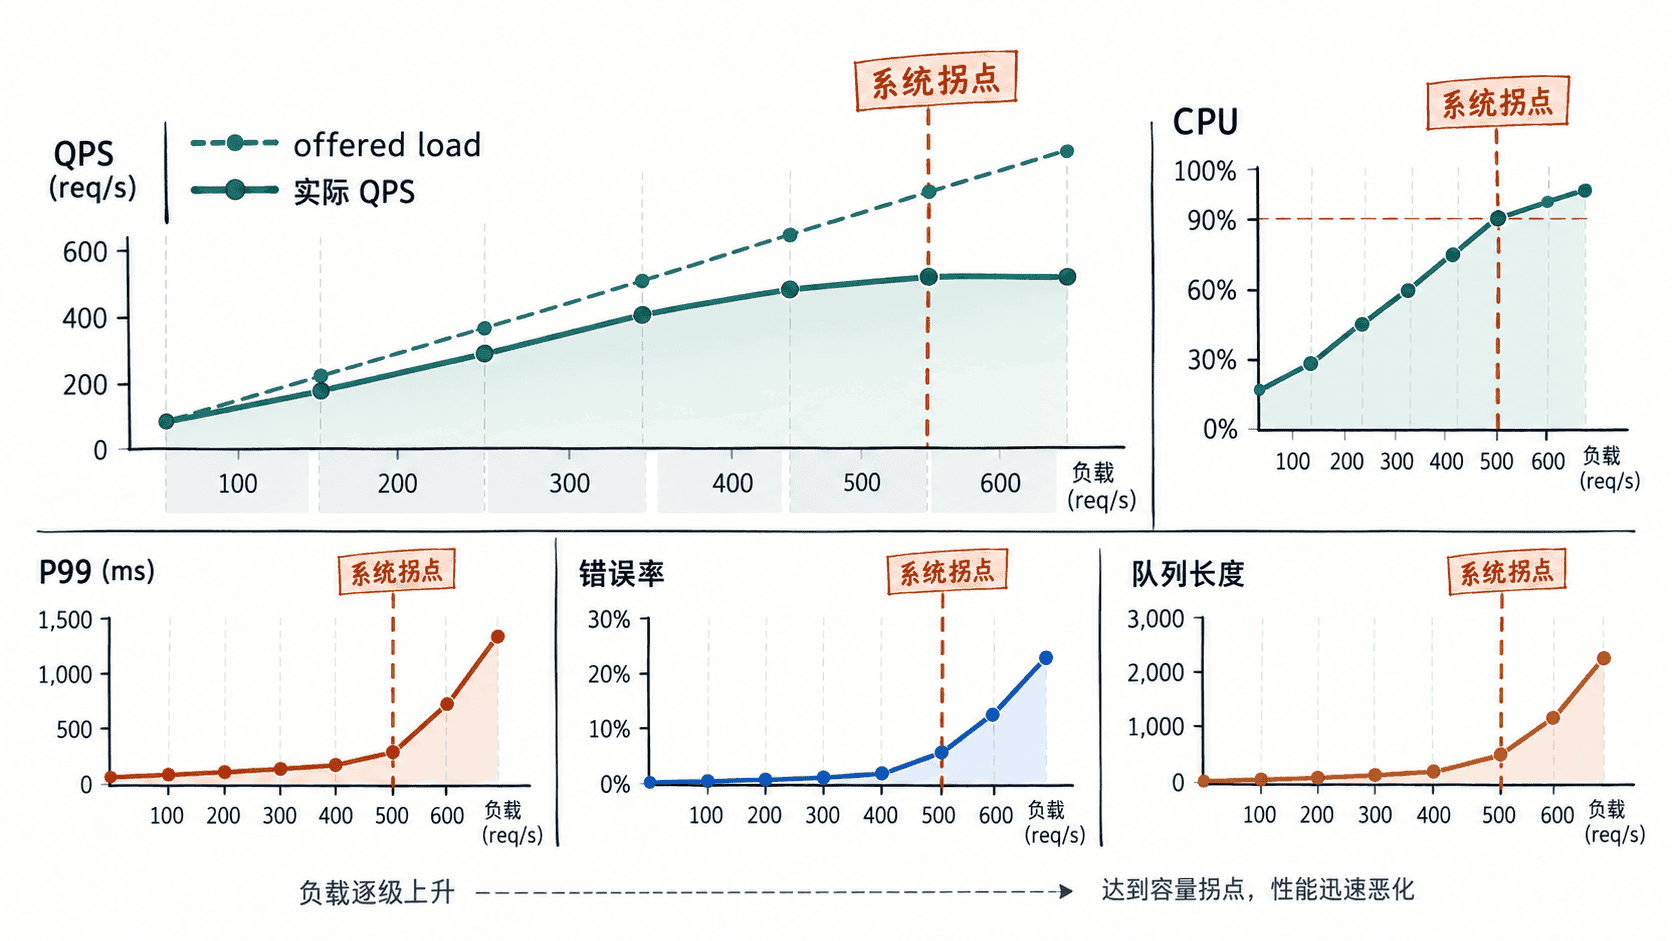
判断时先看“吞吐是否还能跟上输入”,再看延迟与排队是否恶化,最后用资源指标解释原因。只看到 CPU 90% 并不能直接说明系统到顶;如果 QPS 仍随负载同比增长、P99 稳定、队列能及时清空,这个台阶仍可能是可用容量。
用脚本筛出候选拐点
下面用一组压测台阶数据演示自动筛选。脚本把“QPS 增幅低于输入增幅”“P99 超过基线两倍”“错误率超过 1%”“队列明显积累且 CPU 超过 85%”作为组合证据。实际项目可以把阈值替换成你的 SLO 和资源上限。
rows = [
    {"load": 100, "qps": 98,  "p99_ms": 120, "err_pct": 0.1, "queue": 0,   "cpu_pct": 38},
    {"load": 200, "qps": 195, "p99_ms": 135, "err_pct": 0.1, "queue": 0,   "cpu_pct": 52},
    {"load": 300, "qps": 288, "p99_ms": 160, "err_pct": 0.2, "queue": 2,   "cpu_pct": 67},
    {"load": 400, "qps": 372, "p99_ms": 220, "err_pct": 0.3, "queue": 8,   "cpu_pct": 79},
    {"load": 500, "qps": 410, "p99_ms": 520, "err_pct": 1.8, "queue": 45,  "cpu_pct": 93},
    {"load": 600, "qps": 416, "p99_ms": 980, "err_pct": 4.9, "queue": 120, "cpu_pct": 97},
]

baseline_p99 = rows[0]["p99_ms"]

for prev, cur in zip(rows, rows[1:]):
    load_growth = (cur["load"] - prev["load"]) / prev["load"]
    qps_growth = (cur["qps"] - prev["qps"]) / prev["qps"]
    signals = [
        qps_growth < load_growth * 0.5,
        cur["p99_ms"] >= baseline_p99 * 2,
        cur["err_pct"] >= 1.0,
        cur["queue"] - prev["queue"] >= 20 and cur["cpu_pct"] >= 85,
    ]
    if sum(signals) >= 3:
        print(f"candidate_inflection={cur['load']} req/s")
        print(f"qps={cur['qps']} p99_ms={cur['p99_ms']} err_pct={cur['err_pct']}")
        print(f"queue={cur['queue']} cpu_pct={cur['cpu_pct']}")
        break
预期输出
candidate_inflection=500 req/s
qps=410 p99_ms=520 err_pct=1.8
queue=45 cpu_pct=93
这个结果不是在宣称“500 req/s 一定不可用”,而是说明从这个台阶开始,系统进入明显的非线性区间。生产容量通常还要在候选拐点之下留安全余量,并结合业务允许的 P99 和错误率确定可承诺容量。
验证它不是偶发尖刺
找到候选拐点后,不要立刻改参数。先重复 400、500、600 req/s 三个台阶至少一轮,确认拐点能复现;再把 500 req/s 附近细分成更小步长,例如 425、450、475、500 req/s,缩小边界区间。
如果第二轮中 QPS、P99 和队列走势完全不同,应先检查压测机是否成为瓶颈、缓存是否预热、GC 是否异常、依赖服务是否有后台任务。只有在相同负载下重复出现相似的“吞吐趋平 + 延迟陡升 + 排队积累”组合,才可以把它视为系统的稳定容量边界。
阶梯加压最终要得到的不是一个孤立峰值,而是一段可解释的容量区间:哪一级仍稳定,哪一级开始非线性,越过边界后首先恶化的指标是什么。这个区间才适合继续做瓶颈定位和弹性规划。