
容器与云原生 / 系统课时
形成滚动发布运行手册
形成滚动发布运行手册
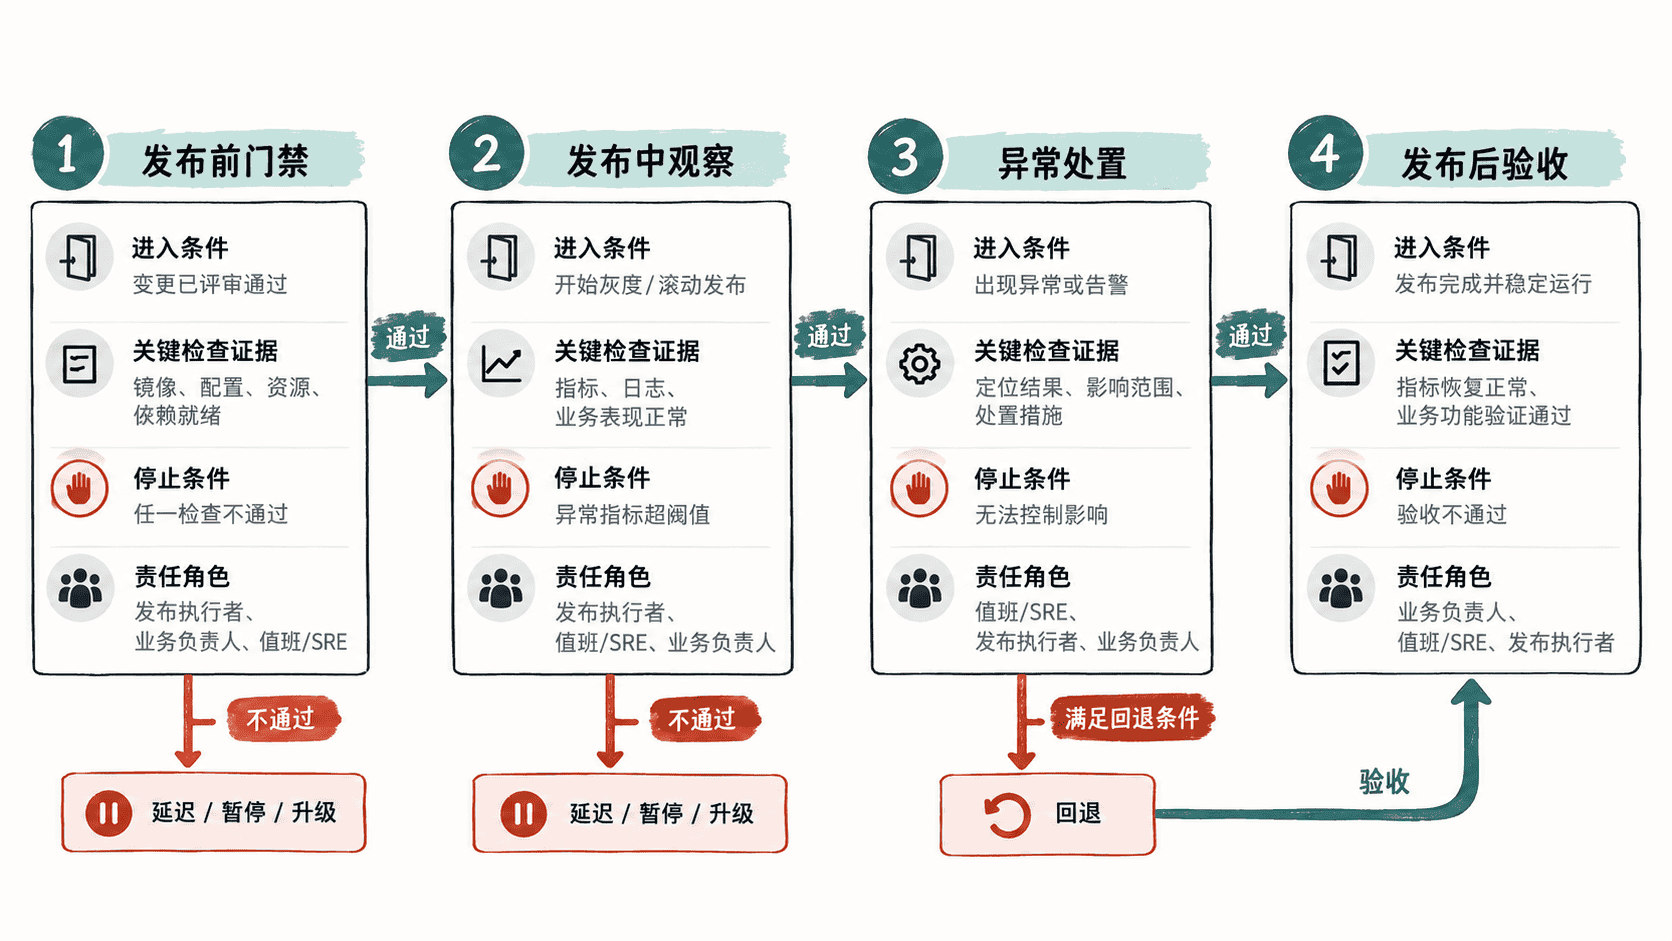
滚动发布运行手册要解决的是“不同值班人员面对同一次发布时,能否依据同一套证据做出同样的继续、暂停或回退决定”。手册应把发布前门禁、发布中观察、异常处置、发布后验收和责任边界固化为可直接执行的规则。
学习目标
- 能把滚动发布拆成发布前、发布中、异常处置和发布后四个治理阶段。
- 能为关键阶段定义可执行检查项、观测信号和停止条件。
- 能明确发布执行者、业务负责人和值班人员在异常情况下的责任边界。
用门禁决定能否开始发布
发布前门禁应回答“现在是否允许开始”,而不是笼统地写“确认系统正常”。至少确认 Deployment 已稳定、期望副本可用、当前没有未解释的关键告警,并且已知可回退的镜像或 revision。
下面保留一组只读命令作为主检查示例,资源名和标签按实际应用替换。
kubectl -n production rollout status deployment/web --timeout=30s
kubectl -n production get deployment web
kubectl -n production get pods -l app=web
kubectl -n production rollout history deployment/web
预期输出
deployment.apps/web successfully rolled out
NAME   READY     UP-TO-DATE   AVAILABLE   AGE
web    <VALUE>   <VALUE>      <VALUE>     <TIME>

deployment.apps/web
REVISION   CHANGE-CAUSE
<ID> <VALUE><VALUE>、<TIME> 和 <ID> 由现场副本数、资源年龄和历史 revision 决定。除 Kubernetes 状态外,还应确认业务错误率、关键接口延迟和核心成功率处于正常基线,否则新发布的影响会与既有故障混在一起。
发布中只观察能决定动作的信号
发布开始后,应规定统一的观察窗口。Kubernetes 层面重点关注 Deployment 的 status.updatedReplicas、status.availableReplicas 和 status.unavailableReplicas,同时观察新旧 ReplicaSet 是否按策略收敛;业务层面关注错误率、关键接口延迟和核心成功率。
如果 rollout 超时,不能只记录“超时”就继续等待。手册应给出停止条件,例如新 Pod 持续无法 Ready、不可用副本超过业务容忍范围、业务错误率突破服务阈值,或关键依赖同步出现异常。触发任一条件后,应停止扩大影响面并进入异常处置。
把异常处置写成可执行决策
“发现问题及时回滚”不足以指导事故现场。异常章节应明确什么时候暂停、先保存什么证据、谁有权决定回退,以及回退后按什么标准恢复发布。
推荐固定以下处置顺序:
- 暂停继续扩散新版本,控制影响面。
- 保存 Deployment、ReplicaSet、Pod、事件、应用日志和关键监控时间点。
- 判断故障是否与新版本在时间和 revision 上具有明确相关性。
- 满足回退条件时执行预定义回退方案;证据不足时升级到对应故障域负责人。
- 回退后重新验证控制器收敛、服务连通性和业务指标。
Deployment 可用以下命令暂停 rollout 并采集现场信息。暂停只会阻止 Deployment 继续推进新的 rollout 变化,不会自动移除已经创建并开始承载流量的新 Pod,因此不能把 pause 当作故障隔离或回退本身。
kubectl -n production rollout pause deployment/web
kubectl -n production describe deployment web
kubectl -n production get events --sort-by=.lastTimestamp
预期输出
deployment.apps/web pauseddescribe 和事件列表取决于现场状态,不应在手册中预写固定内容。手册只需规定需要保留的时间范围、资源名称和关联 revision,确保后续能够重建故障过程。
明确指标与责任边界
每项指标都应绑定责任人和决策用途。Deployment 收敛、Pod Ready 与 Kubernetes 事件通常由发布执行者或平台人员负责;接口成功率和核心业务结果由业务负责人确认;跨服务影响、大范围止损和升级协调由值班人员或 SRE 负责。
责任边界可以压缩成三个问题:谁执行变更,谁判断业务是否健康,谁有权在风险扩大时停止发布。若这些问题直到事故发生后才讨论,运行手册就没有建立真正的治理边界。
阈值也不应在通用模板中硬编码为一套数字。每个服务应维护自己的错误率、P95/P99 延迟、关键交易成功率或队列积压基线,并在手册中注明指标来源、观察窗口和停止阈值。
发布后留下可追溯记录
发布完成后仍需独立验收:Deployment 已收敛,新 ReplicaSet 达到期望副本,旧 ReplicaSet 按策略缩容,并且业务指标在约定观察窗口内保持稳定。发布记录至少应关联发布人、开始与结束时间、镜像或版本、Deployment revision、异常情况、是否回退以及最终验证结果。
最终可用的运行手册不是说明文,而是一套可在发布窗口直接执行的决策协议:每个阶段都有进入条件、检查证据、停止条件、负责人和下一步动作。持续用真实故障与演练修订这些规则,才能把滚动发布从个人经验转化为团队可复用的生产流程。