
容器与云原生 / 系统课时
用 startupProbe 保护慢启动应用
用 startupProbe 保护慢启动应用
慢启动应用可能需要较长时间完成 JVM 预热、模型加载或缓存构建。如果存活探针过早介入,正常初始化可能被误判为故障并触发反复重启。startupProbe 用独立的启动窗口把初始化阶段与运行期健康检查隔开。
学习目标
- 理解
startupProbe、readinessProbe与livenessProbe的职责和接管顺序 - 根据最长合理启动时间设置启动探针窗口
- 验证慢启动期间不会因正常初始化而产生错误重启
启动探针隔离初始化阶段
配置 startupProbe 后,kubelet 会先用它判断容器是否完成启动。在启动探针成功之前,livenessProbe 和 readinessProbe 不会执行;启动探针一旦成功便不再继续探测,后两类探针开始承担运行期检查职责。
三类探针分别回答不同问题:startupProbe 判断“应用是否已经启动完成”,readinessProbe 判断“当前是否适合接收流量”,livenessProbe 判断“运行中的容器是否需要重启”。把启动阶段单独隔离,可以避免把正常的慢启动误判为存活故障。
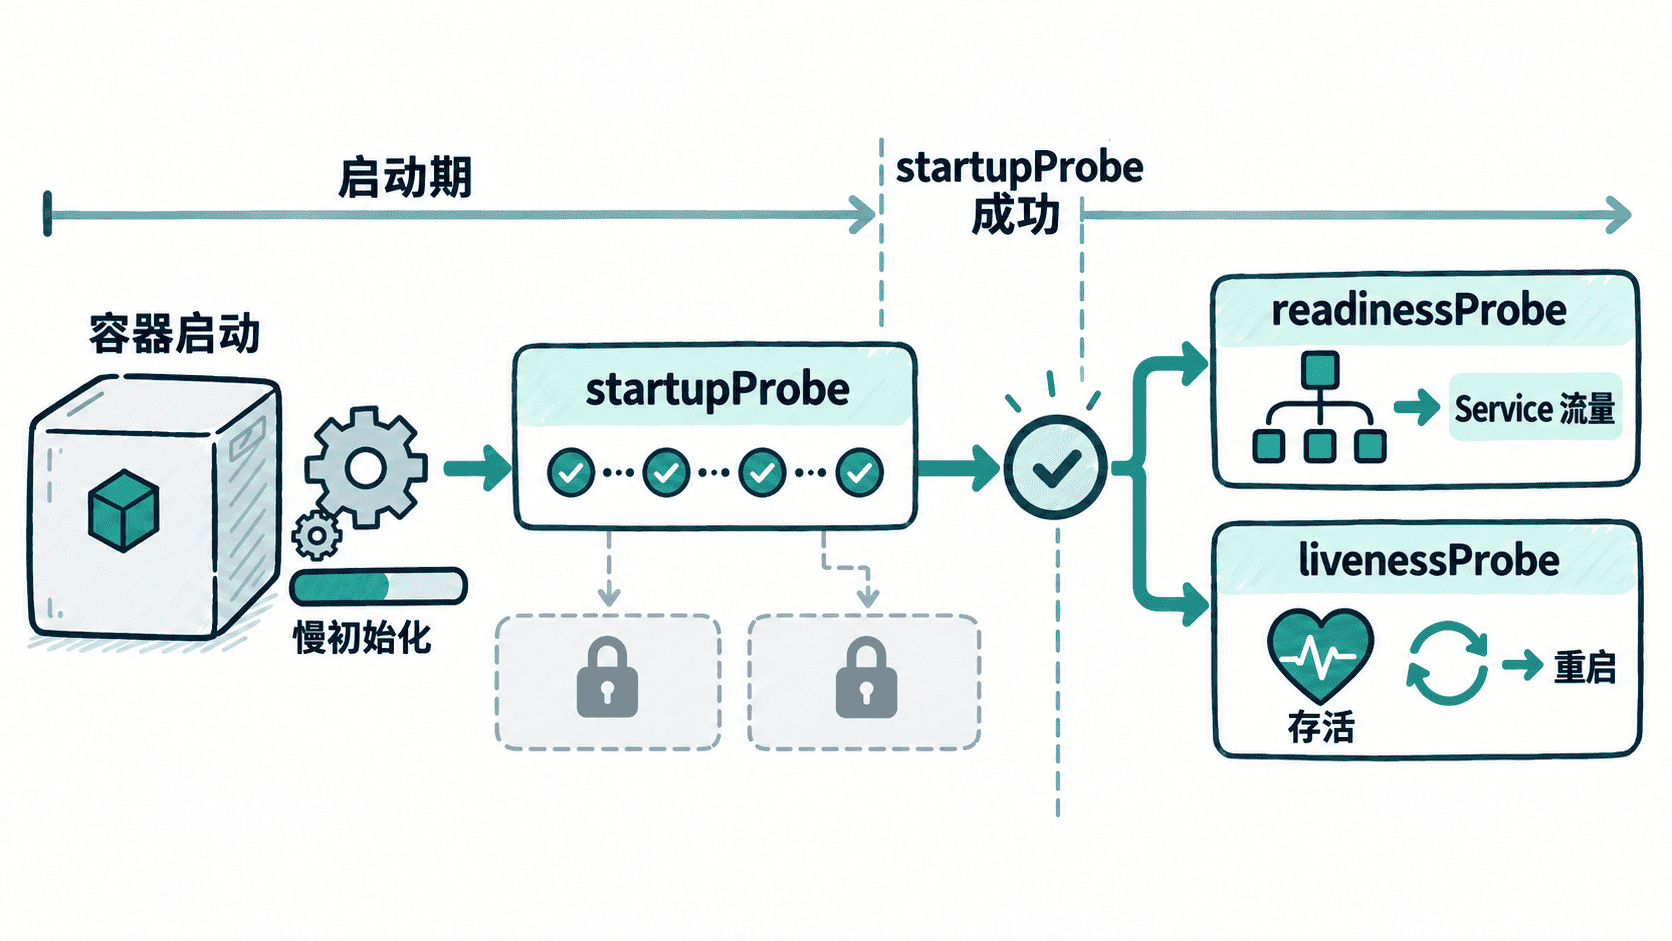
为慢启动应用配置独立窗口
下面的 Deployment 为应用提供约 5 分钟的启动容忍窗口。startupProbe 每 5 秒检查一次,连续失败 60 次才判定启动失败,因此可以用 5 × 60 = 300 秒快速估算允许的启动时长。实际配置还应为冷启动和节点负载波动留出余量。
apiVersion: apps/v1
kind: Deployment
metadata:
  name: report-api
spec:
  replicas: 2
  selector:
    matchLabels:
      app: report-api
  template:
    metadata:
      labels:
        app: report-api
    spec:
      containers:
        - name: report-api
          image: example/report-api:3.0
          ports:
            - containerPort: 8080
          startupProbe:
            httpGet:
              path: /startupz
              port: 8080
            periodSeconds: 5
            timeoutSeconds: 2
            failureThreshold: 60
          readinessProbe:
            httpGet:
              path: /readyz
              port: 8080
            periodSeconds: 5
            timeoutSeconds: 2
            failureThreshold: 2
          livenessProbe:
            httpGet:
              path: /livez
              port: 8080
            periodSeconds: 10
            timeoutSeconds: 2
            failureThreshold: 3
其中 template.metadata.labels 与 spec.selector.matchLabels 必须匹配,否则 Deployment 无法正确管理这些 Pod。三个探针都属于同一个容器配置;/startupz 只负责启动完成判断,/readyz 和 /livez 则分别承担流量准入与运行期自愈职责。
保存为 report-api.yaml 后,可以先让 API Server 校验资源结构和字段:
kubectl apply --dry-run=server -f report-api.yaml预期输出
deployment.apps/report-api created (server dry run)如果集群或 kubectl 版本不同,输出措辞可能略有差异;该检查能够验证 YAML 和 Kubernetes 资源结构,但不会验证镜像是否存在,也不会实际访问探针端点。
验证启动期间没有错误重启
实际部署后,持续观察 Pod 的就绪状态和重启次数:
kubectl get pods -l app=report-api -w预期输出
NAME                         READY   STATUS    RESTARTS   AGE
report-api-<ID>              0/1     Running   0          <TIME>
report-api-<ID>              1/1     Running   0          <TIME>
慢启动阶段 Pod 可以已经处于 Running,但仍显示 0/1;只有启动探针成功且就绪探针通过后才会变为 1/1。关键观察点是正常初始化期间 RESTARTS 不应持续增加。<ID> 和 <TIME> 以实际环境为准。
如果启动一直未成功,可以查看 Pod 事件确认启动探针失败原因:
kubectl describe pod report-api-<ID>预期结果
Events:
  Type     Reason     Age      From     Message
  Warning  Unhealthy  <TIME>   kubelet  Startup probe failed: <VALUE>
启动窗口内出现若干 Startup probe failed 并不等于容器已经失败;只有连续失败达到 failureThreshold 后,kubelet 才会按启动探针失败规则重启容器。<TIME> 和 <VALUE> 的实际内容取决于探测失败原因。
启动窗口要有明确上界
startupProbe 的目的不是永久容忍启动失败,而是区分“正常地慢”和“已经无法启动”。窗口太短会重新造成启动死循环;窗口太长则会延迟暴露镜像错误、配置缺失或依赖长期不可达等真实故障。
生产环境应统计正常版本在冷启动和高负载条件下的启动耗时,再把 failureThreshold 与 periodSeconds 设置到略高于合理上界的位置。如果应用经常需要十几分钟才能启动,应优先拆分或优化初始化过程,而不是持续扩大探针窗口。这样才能让 startupProbe 保护启动期、readinessProbe 控制流量资格、livenessProbe 处理运行期自愈,各自承担清晰且互不干扰的职责。