
容器与云原生 / 系统课时
排查旧 Pod 长时间不退出
排查旧 Pod 长时间不退出
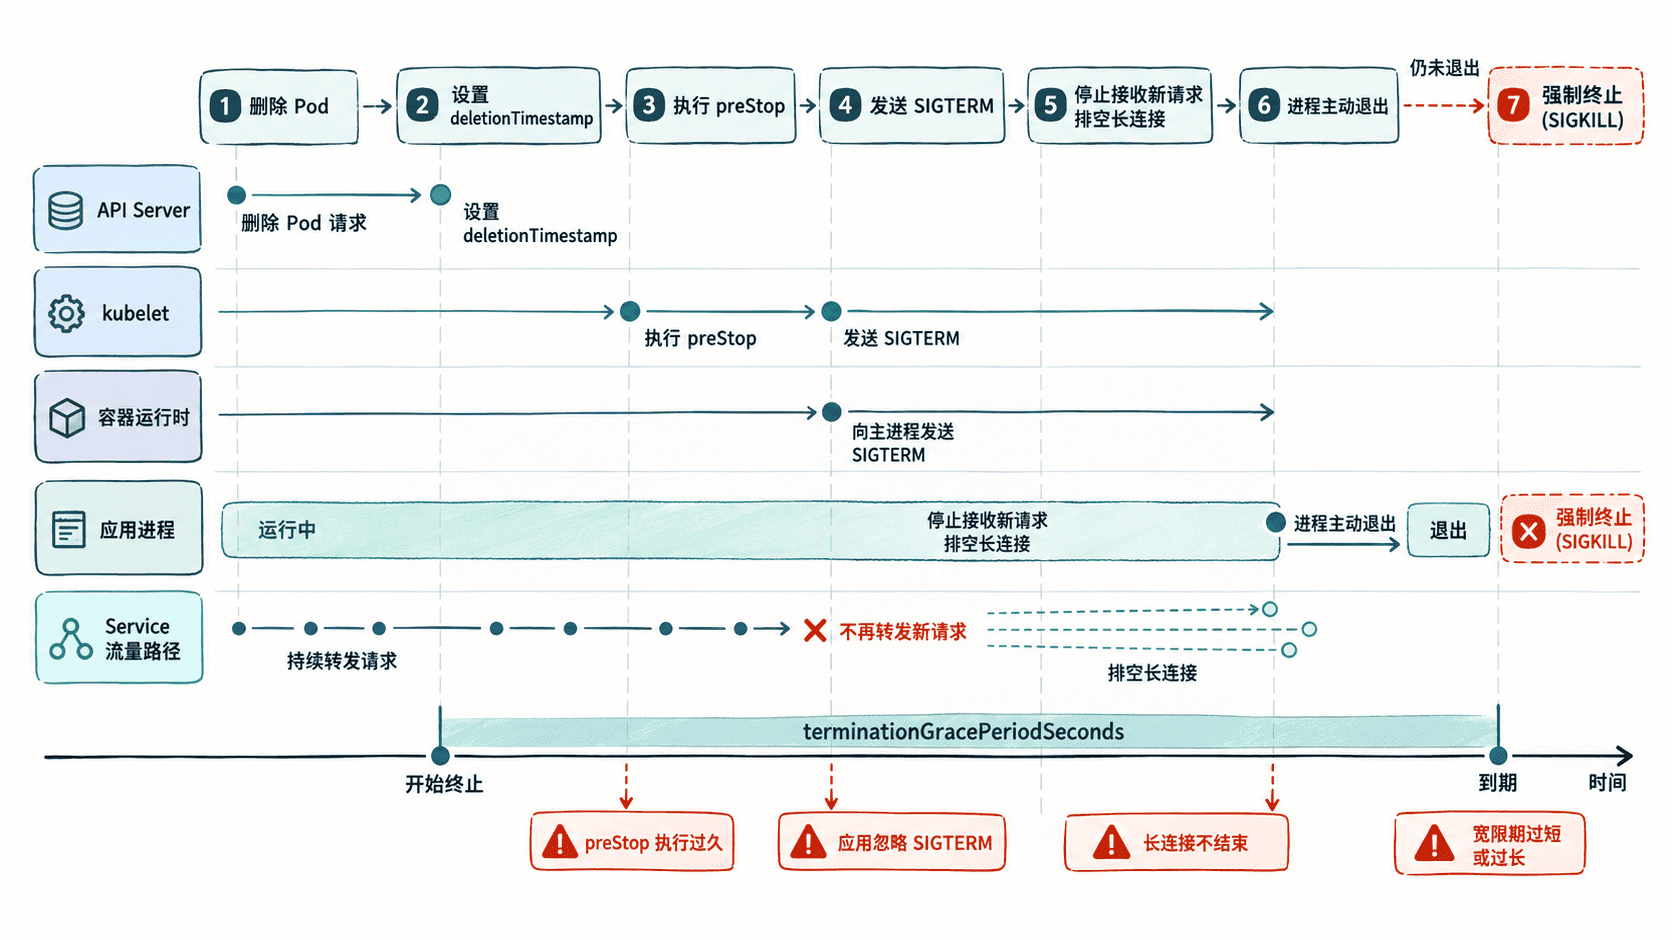
滚动发布中,新 Pod 已就绪但旧 Pod 长时间停留在 Terminating,会拖慢副本收敛。排查时先区分 API 删除、节点执行和应用退出三个层面,再沿 preStop、SIGTERM、连接排空与终止宽限期定位,避免一开始就强制删除 Pod。
学习目标
- 根据删除时间、Finalizer、节点状态和容器状态判断终止卡点
- 理解 preStop、SIGTERM、长连接排空与终止宽限期的时间关系
- 在保证请求完整性的前提下缩短旧 Pod 的退出时间
确认卡住的是哪一层
先确认 Pod 已收到删除请求,并观察它所在节点、Finalizer 和容器状态。如果没有 deletionTimestamp,问题还没进入 Pod 终止流程;如果存在自定义 Finalizer,API 对象可能在等待对应控制器完成清理;如果节点 NotReady 或 kubelet 异常,则应用本身未必是根因。
kubectl get pod <POD_NAME> -o custom-columns='NAME:.metadata.name,DELETION:.metadata.deletionTimestamp,GRACE:.spec.terminationGracePeriodSeconds,NODE:.spec.nodeName'
kubectl get pod <POD_NAME> -o jsonpath='{.metadata.finalizers}'
kubectl get node <NODE_NAME>
kubectl rollout status deployment/web --timeout=60s
预期结果应能确认 Pod 已进入删除流程,并给出节点和滚动发布状态;实际时间、节点名和状态值可能不同:
NAME         DELETION   GRACE   NODE
<POD_NAME>   <TIME>     30      <NODE_NAME>
[]
NAME          STATUS   ROLES     AGE       VERSION
<NODE_NAME>   Ready    <VALUE>   <VALUE>   <VALUE>
Waiting for deployment "web" rollout to finish: <VALUE>
如果 Finalizer 列表非空,应先确认是谁添加并负责移除它;如果节点不是 Ready,则继续检查节点和 kubelet,而不是直接修改应用的关闭逻辑。
检查 preStop 是否挤占宽限时间
Pod 删除后,终止宽限期开始计时。若容器配置了 preStop,kubelet 会先执行该钩子,再向容器主进程发送 TERM;因此 preStop 的耗时属于同一段宽限期,不是额外增加的时间。钩子过慢会压缩应用处理 SIGTERM 和清理存量请求的时间。
kubectl get deployment web -o yaml预期结果应重点核对类似配置:
spec:
  template:
    spec:
      terminationGracePeriodSeconds: 30
      containers:
        - name: web
          lifecycle:
            preStop:
              exec:
                command:
                  - /bin/sh
                  - -c
                  - /app/drain.sh
这是工作负载配置。验证时应结合应用日志记录 /app/drain.sh 的开始与结束时间,确认它不会无限重试、长期等待外部系统,或执行与摘流无关的清理任务。
验证 SIGTERM 是否真正到达应用
preStop 完成后,应用主进程应收到 TERM 并开始优雅关闭。常见故障是 shell 入口脚本占据 PID 1 却没有转发信号,或者应用收到信号后仍继续接收新任务,导致清理永远追不上新增工作。
kubectl logs <POD_NAME> --timestamps --tail=100预期结果应能看到从收到终止信号、停止接收新请求到完成清理的连续记录;具体日志文本由应用实现决定:
<TIME> received SIGTERM
<TIME> stop accepting new requests
<TIME> active requests drained
<TIME> shutdown complete
如果完全看不到 TERM 或 shutdown 相关日志,应检查镜像的 ENTRYPOINT、启动脚本和 PID 1。使用 shell 包装应用时,通常要用 exec 让应用进程替换 shell,从而直接接收 Kubernetes 发送的信号。
区分正常排空与异常挂死
WebSocket、流式 RPC、长轮询和长请求可能让应用在收到 SIGTERM 后继续等待存量连接结束。合理的排空应该能观察到活跃连接持续下降;如果数值长期不变,就更像应用挂死、连接无最大寿命,或客户端没有正确重连。
kubectl get pod <POD_NAME> -w
kubectl logs <POD_NAME> --timestamps -f
预期现象是 Pod 在 Terminating 一段时间后自行消失,同时应用日志中的活跃连接逐步归零:
<TIME> draining connections: <VALUE>
<TIME> draining connections: 0
<TIME> shutdown complete
如果连接长期不降,应在协议和应用层设置合理的连接寿命、服务端 shutdown 超时和客户端重连策略。反过来,若 terminationGracePeriodSeconds 明显短于正常排空所需时间,kubelet 最终会强制终止仍未退出的容器,请求可能因此中断。
调整宽限期并验证发布收敛
宽限期应覆盖正常的 preStop、应用关闭和连接排空时间,并留出少量余量;过短会破坏优雅关闭,过长则会在程序异常时显著拖慢滚动发布。修改配置后,应重新走一次完整发布并观察旧 Pod 是否在预期窗口内消失。
kubectl rollout restart deployment/web
kubectl rollout status deployment/web --timeout=5m
kubectl get pods -l app=web
预期结果是滚动发布成功,最终只剩新版本 Pod 处于可用状态:
deployment.apps/web restarted
deployment "web" successfully rolled out
NAME       READY   STATUS    RESTARTS   AGE
web-<ID>   1/1     Running   0          <TIME>
不要把 kubectl delete pod --force --grace-period=0 当作常规修复手段。只有在已确认节点、运行时或终止流程无法正常完成,并评估过请求中断与重复实例风险后,才考虑强制删除。稳定的滚动发布应让旧实例停止接收新流量、完成存量请求并主动退出,而且这一过程能稳定落在设定的终止宽限期内。