
容器与云原生 / 系统课时
设计可执行的回退条件
设计可执行的回退条件
滚动发布真正危险的不是出现一次异常,而是团队无法据此做出一致决策。本课把错误率、延迟、可用副本和业务指标整理成可执行门禁,让发布负责人能够明确判断继续、暂停还是立即回退。
学习目标
- 将技术指标和业务指标转化为明确的发布判定条件
- 区分继续、暂停观察和立即回退三种处置级别
- 使用 Kubernetes 状态验证回退条件并执行可控回退
先把指标写成决策条件
回退条件不能只写“错误率明显升高”或“延迟异常”。这样的描述缺少基线、阈值和持续时间,不同值班人员会得到不同结论。更可靠的规则至少包含指标、比较对象、阈值、观察窗口和动作。
例如一次发布可以约定:新版本 5xx 错误率连续 5 分钟高于 2%,立即回退;P95 延迟较发布前基线上升 30% 且持续 5 分钟,暂停发布;Deployment 可用副本低于期望值持续 3 分钟,暂停并检查 Pod;下单成功率下降 5% 以上,直接回退。
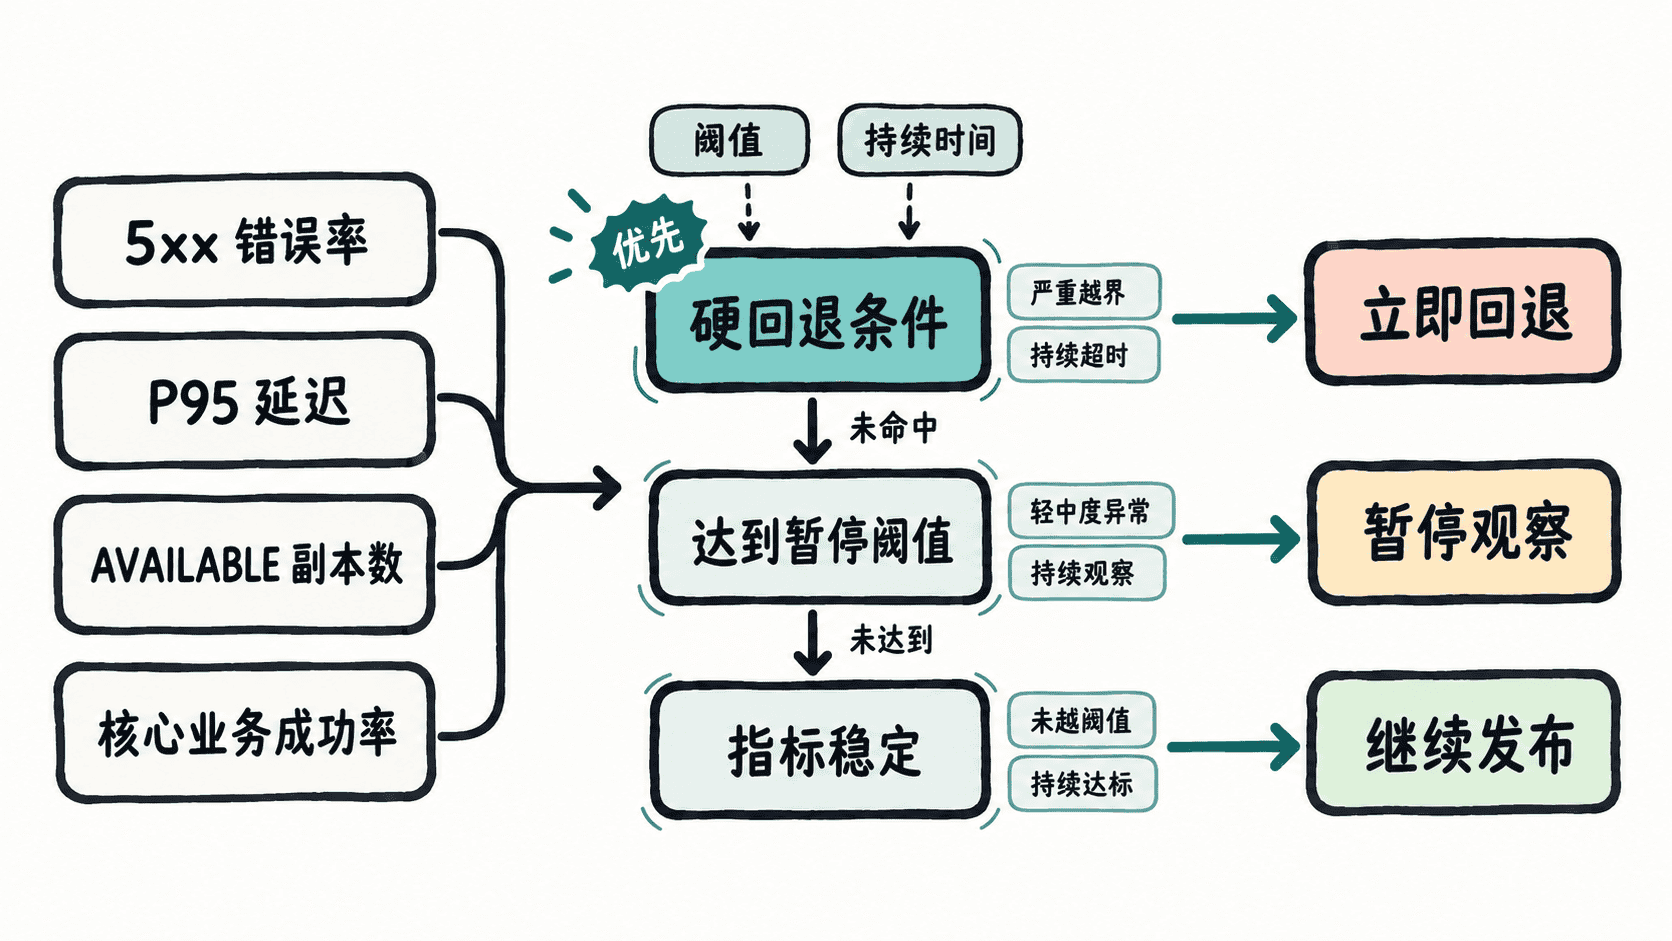
给继续、暂停和回退不同门槛
三种动作不应共用一个阈值。继续发布意味着当前证据没有显示显著风险;暂停意味着证据不足以证明必须回退,但继续扩大流量可能放大故障;回退意味着已经触发不可接受的用户影响或可用性风险。
可以把规则组织为这样的优先级:核心业务正确性和成功率优先级最高,一旦越过硬阈值直接回退;错误率和延迟通常结合持续时间判断;可用副本不足首先暂停,因为它既可能来自新版本自身,也可能来自调度、镜像或探针问题。
用 Kubernetes 状态补齐发布证据
业务监控负责回答“用户是否受影响”,Kubernetes 状态负责回答“新版本是否稳定形成可用容量”。发布过程中可以先查看 Deployment 的期望、副本和可用状态,再确认滚动更新是否完成。
kubectl get deployment checkout-api -n production
kubectl rollout status deployment/checkout-api -n production --timeout=60s
预期输出
NAME           READY   UP-TO-DATE   AVAILABLE   AGE
checkout-api   6/6     6            6           <TIME>
deployment "checkout-api" successfully rolled out
实际副本数和时间会随环境变化。即使这里显示成功,也仍需检查发布前约定的错误率、延迟和业务指标;只有技术状态与业务状态同时满足继续条件,才能扩大发布。
如果 AVAILABLE 长时间低于期望值,或者 rollout status 超时,就应先暂停扩大流量并定位原因,而不是机械地执行下一批发布。常见检查顺序是查看 Pod 是否处于 Ready、是否反复重启,再检查调度、镜像拉取、探针和节点资源等原因;如果异常集中在新版本 Pod,还应结合错误率、延迟和业务成功率判断是否已经触发预先约定的硬回退条件。未触发硬条件时保持暂停并继续定位,确认新版本造成不可接受影响后再执行回退。
把回退动作写进运行手册
触发硬回退条件后,操作路径也应提前确定。对于保留了上一版本 ReplicaSet 历史的 Deployment,可以先查看修订记录,再回退到上一修订版本。
kubectl rollout history deployment/checkout-api -n production
kubectl rollout undo deployment/checkout-api -n production
kubectl rollout status deployment/checkout-api -n production --timeout=120s
预期输出
deployment.apps/checkout-api
REVISION  CHANGE-CAUSE
<ID>      <none>
<ID>      <none>
deployment.apps/checkout-api rolled back
deployment "checkout-api" successfully rolled out
修订号属于动态值,实际结果可能不同。回退完成只表示旧版本 Pod 已重新达到 Kubernetes 的可用条件,还必须继续观察错误率、延迟和核心业务指标,确认它们恢复到发布前基线附近。
让规则能够被值班人员直接执行
一份可执行的发布门禁最终应回答三个问题:哪些指标允许继续,哪些异常要求暂停观察,哪些异常无需讨论就立即回退。每条规则都应给出量化阈值、持续时间和对应动作,并注明谁负责读取业务指标、谁有权限执行回退。
当团队不需要在故障现场重新讨论“到底严重到什么程度才回滚”,回退条件才真正从经验判断变成了可执行的可用性治理机制。