
容器与云原生 / 系统课时
理解 Pod 终止生命周期
理解 Pod 终止生命周期
删除 Pod 会同时触发控制面端点更新和节点侧容器终止,两条链路会并行推进并受到传播延迟影响。真正可靠的无损下线,不是押注“先摘流量再停进程”的强时序,而是让应用在时序交错时仍能排空并在宽限期内退出。
学习目标
- 说清 EndpointSlice、
preStop、SIGTERM 与终止宽限期各自负责什么 - 区分容器内部可依赖的局部顺序与控制面、kubelet 之间不可依赖的全局顺序
- 通过最小 Pod 观察优雅终止期间的状态变化
删除请求启动并行链路
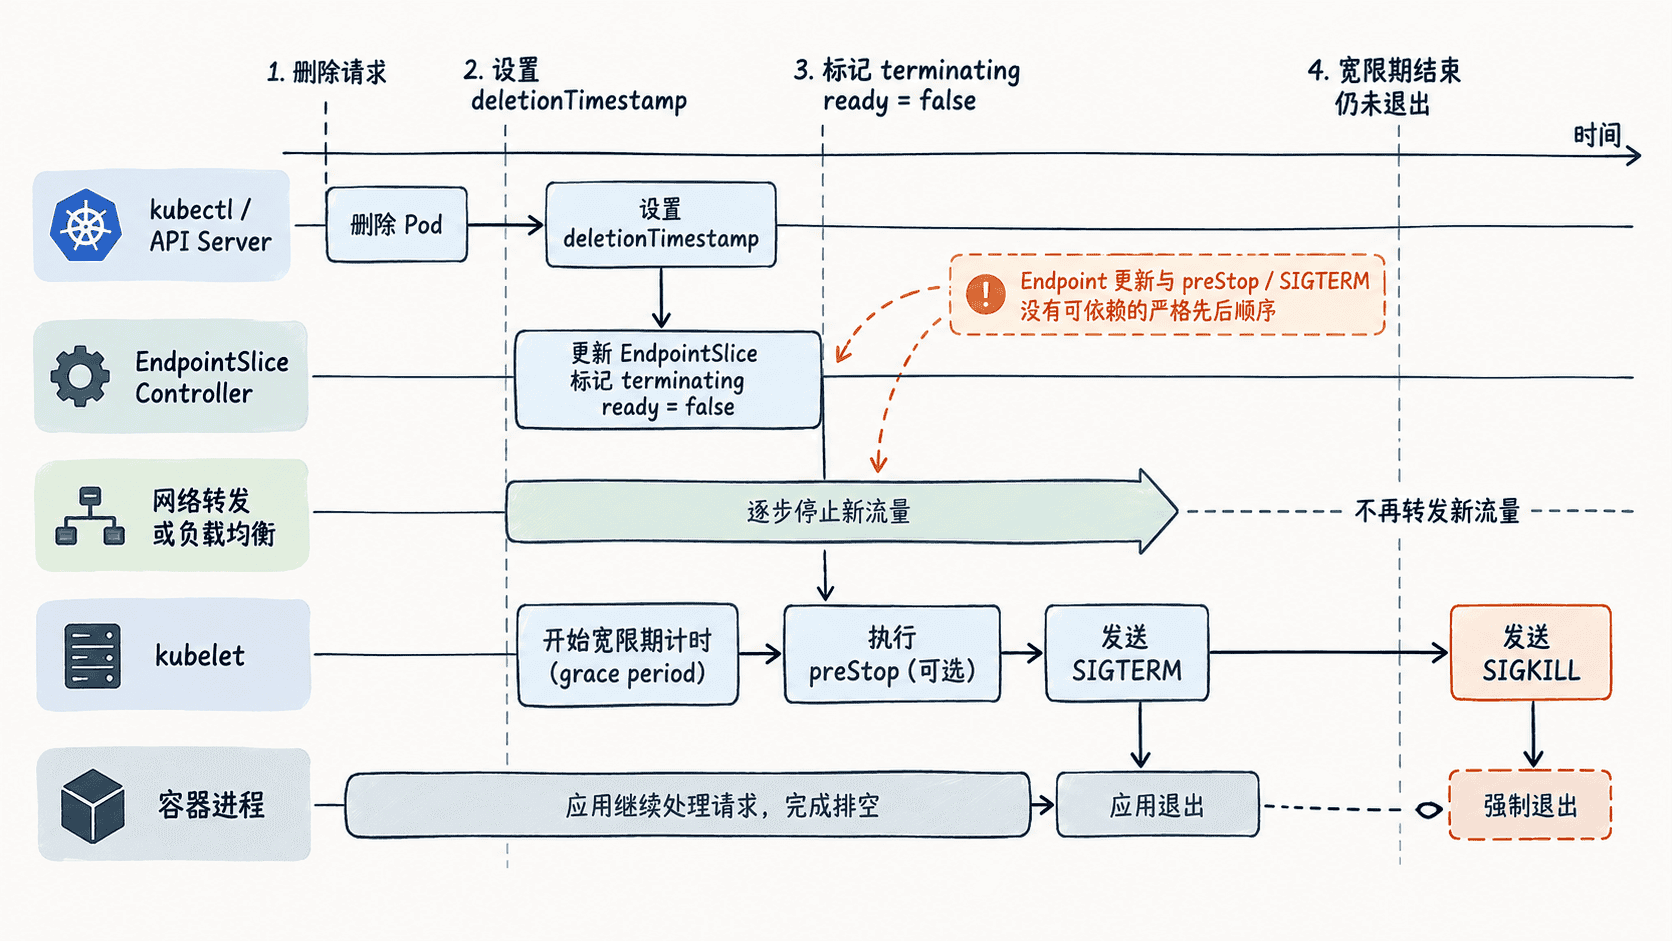
执行 kubectl delete pod 后,API Server 会为 Pod 记录删除时间戳和宽限期。kubelet 观察到 Pod 正在终止后,会开始节点侧的优雅关闭;与此同时,控制面也会处理这个删除状态,并更新与 Service 相关的 EndpointSlice。两侧不是串行流水线。
对常规 selector Service,终止中的 endpoint 会暴露 terminating=true,并以 ready=false 表示它不再是普通 Ready 目标。这个状态仍要传播给 kube-proxy、负载均衡器、Service Mesh 等实际数据面;节点侧的 preStop、终止信号和进程退出也在独立推进。因此,EndpointSlice 变更可能早于、晚于或与容器终止动作交错。
能依赖的结论是“这些动作都会围绕同一次 Pod 删除发生”,而不是“某一个动作一定完成后另一个才开始”。已经建立的长连接、正在处理的请求,以及尚未完成数据面收敛的新连接,都可能跨过这些观察时点。
节点侧有哪些可依赖的顺序
Pod 的 terminationGracePeriodSeconds 默认是 30 秒。对定义了 preStop 且宽限期不为 0 的容器,kubelet 会先运行 preStop;该 hook 完成后,再请求容器运行时向容器主进程发送终止信号(通常为 SIGTERM)。这个“preStop 在终止信号之前”的关系只属于单个容器的本地终止流程,不能外推成“EndpointSlice 一定已经先更新”。
终止宽限期的倒计时在 preStop 之前就已经开始,所以 hook 消耗的是总预算,而不是额外赠送的时间。如果 preStop 到宽限期末尾仍未结束,kubelet 会请求一次很短的 2 秒扩展;应用不应把这 2 秒当作正常容量规划的一部分。
同一个 Pod 中若有多个普通容器,kubelet 发给容器运行时的停止请求会异步处理,不能依赖它们的结束顺序;原生 sidecar 容器存在专门的终止顺序规则。需要跨容器协调时,应显式设计协议,而不是从日志时间戳推断固定先后。
下面用一个 5 秒 preStop 观察 Pod 的终止窗口:
apiVersion: v1
kind: Pod
metadata:
  name: termination-demo
spec:
  terminationGracePeriodSeconds: 20
  containers:
    - name: web
      image: nginx:1.27
      lifecycle:
        preStop:
          exec:
            # 用短暂延迟放大 Terminating 观察窗口,不代表生产推荐值
            command: ["/bin/sh", "-c", "sleep 5"]
      ports:
        - containerPort: 80
将配置保存为 pod.yaml 后执行:
kubectl apply -f pod.yaml
kubectl get pod termination-demo
kubectl delete pod termination-demo --wait=false
kubectl get pod termination-demo
预期输出
pod/termination-demo created
NAME               READY   STATUS    RESTARTS   AGE
termination-demo   1/1     Running   0          <TIME>
pod "termination-demo" deleted
NAME               READY   STATUS        RESTARTS   AGE
termination-demo   1/1     Terminating   0          <TIME>
最后一条查询是否还能看到 Pod 取决于命令执行速度;如果终止已经完成,也可能返回 NotFound。<TIME> 等动态值以实际环境为准。
preStop 与终止信号职责不同
preStop 是 Kubernetes 生命周期 hook,适合执行应用退出前的明确动作,例如暂停消费、通知本地代理或触发排空。它不是应用优雅退出机制本身,也不能证明 Service、Ingress、外部负载均衡或注册中心已经完成流量收敛。
终止信号则应由应用进程直接处理。服务程序收到信号后,应停止接收新的业务工作,在剩余宽限时间内完成已有请求、关闭连接、刷新必要状态并主动退出。对需要无损下线的服务,可靠的信号处理通常比简单延长 preStop 中的 sleep 更重要。
EndpointSlice 更新不是流量屏障
Pod 进入终止状态后,对应 endpoint 不会立刻从 EndpointSlice 消失,而会先暴露终止状态。常规流量路径通常不再把 ready=false 的终止 endpoint 当作新的 Ready 目标,但控制面对象的变化还需要被各类数据面消费者观察和应用。
即使新流量已经明显减少,TCP keep-alive、HTTP/2 长连接、正在执行的请求或消息任务仍可能存在。反过来,如果数据面同步尚未完成,也可能短暂出现控制面已标记终止、节点侧正在关闭,但仍有请求到达的情况。因此应用必须把“收到终止信号后主动排空”作为自身职责,而不是等待一个 Kubernetes 提供的绝对先后门禁。
宽限期定义最终边界
如果进程没有在终止宽限期内完成退出,Kubernetes 最终会对仍存活的进程执行强制终止。这个边界保证 Pod 删除不会无限等待,但也意味着未完成的请求和任务可能被中断。
设计安全下线时,应把控制面 EndpointSlice 更新、数据面规则收敛、节点侧 preStop、终止信号与进程退出视为会相互交错的过程。只依赖局部保证,不假设跨组件强时序,并让应用在宽限期内主动排空,才是可迁移到真实生产环境的终止模型。