
容器与云原生 / 系统课时
处理长连接与后台任务退出
处理长连接与后台任务退出
HTTP 短请求通常可以依靠摘流和优雅退出完成迁移,但 WebSocket、流式响应和后台任务可能在 Pod 进入终止阶段后持续数十秒甚至数分钟。本课建立“停止接新工作、收尾或迁移存量工作、到期强制退出”的统一策略,并给出可验证的终止窗口配置。
学习目标
- 区分短请求、长连接和后台任务在 Pod 终止阶段的不同风险
- 为 WebSocket、流式请求和异步任务设计有截止时间的退出行为
- 用终止宽限期和业务指标验证滚动发布不会静默丢失工作
长连接为什么不能只靠摘流
Pod 从 Service 后端集合中摘除,主要影响后续流量选择,并不会自动结束已经建立的 TCP 连接。WebSocket、gRPC 流式调用、Server-Sent Events 等会话可能继续停留在旧 Pod 上,直到客户端关闭、服务端主动结束,或容器最终被终止。
后台任务更特殊:它不依赖入站连接。Worker 已经从队列领取任务后,即使实例不再承接新流量,当前任务仍可能继续执行。若进程直接退出,任务会不会丢失取决于消息系统的确认时机、重投机制和应用是否具备幂等能力。
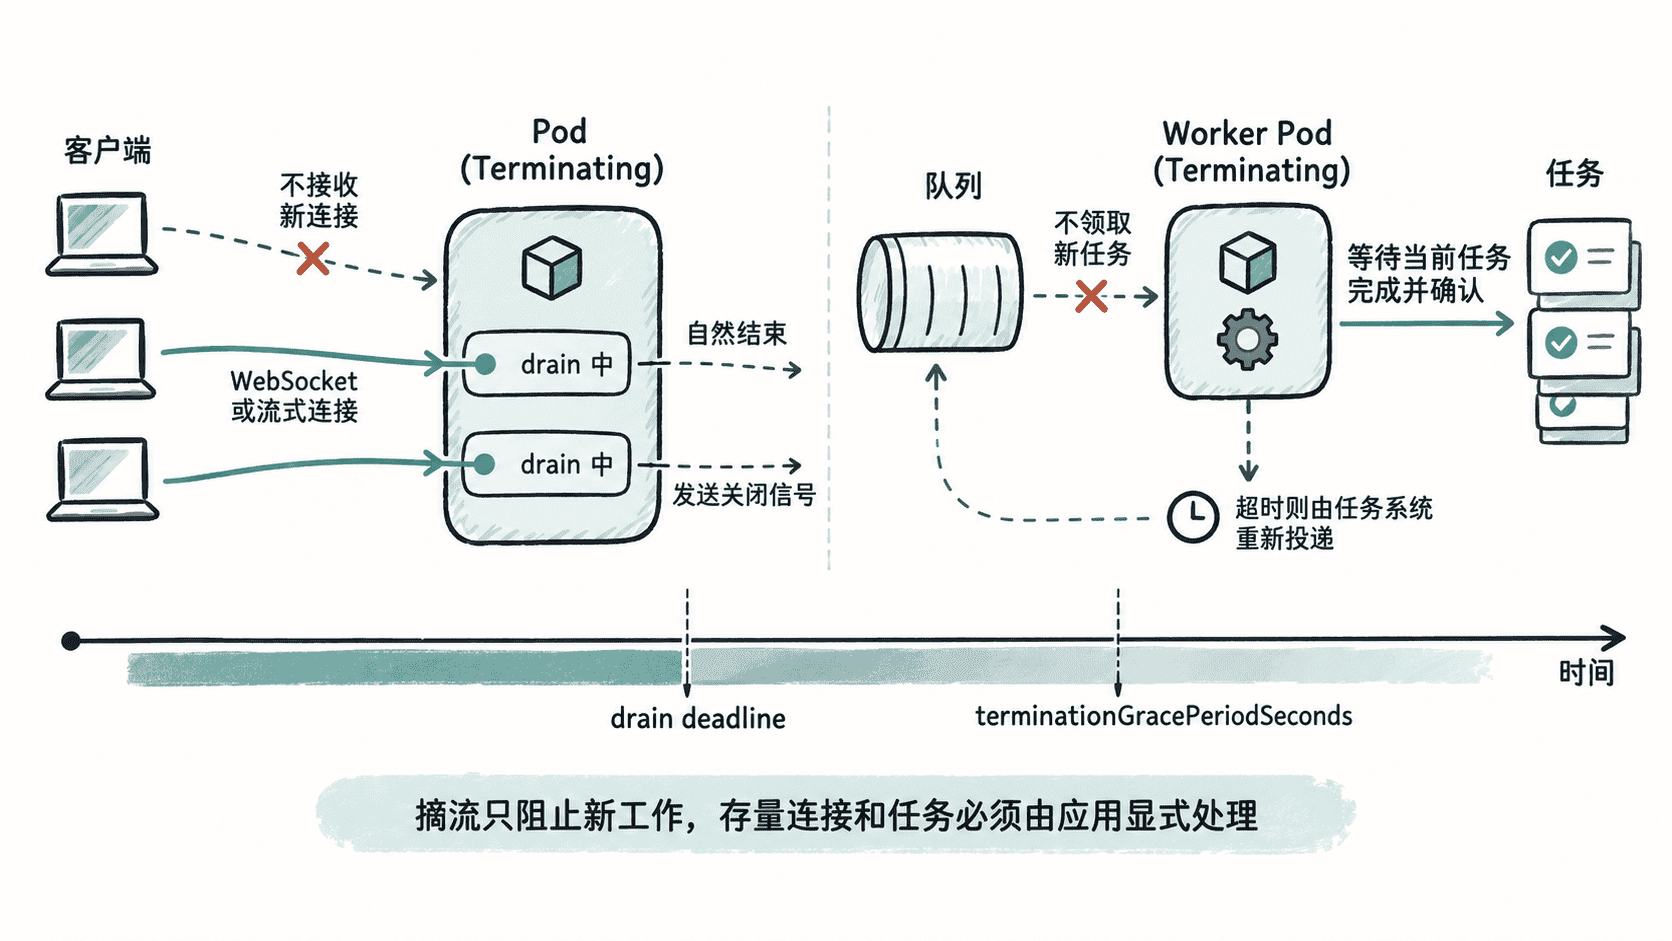
让应用先停止接收新工作
可靠的顺序通常是:实例进入 draining 状态,不再接收新业务;继续处理已经建立的连接或已经领取的任务;在截止时间内完成收尾;最后退出进程。对 HTTP 服务,可以在收到 SIGTERM 后让 readiness 失败,并让新请求快速失败,同时给存量工作留出有限时间。
下面的最小 Python 服务收到 SIGTERM 后把 draining 设为 True,此后 /ready 和普通业务请求都返回 503,并在 10 秒后关闭服务器。生产实现应把固定等待替换为“活动请求数、连接数或任务数降到 0,或者达到 drain deadline”。
import signal
import threading
import time
from http.server import BaseHTTPRequestHandler, ThreadingHTTPServer

state = {"draining": False}

class Handler(BaseHTTPRequestHandler):
    def do_GET(self):
        if self.path == "/ready":
            status = 503 if state["draining"] else 200
            body = b"draining\n" if state["draining"] else b"ready\n"
            self.send_response(status)
            self.end_headers()
            self.wfile.write(body)
            return

        if state["draining"]:
            self.send_response(503)
            self.end_headers()
            self.wfile.write(b"server draining\n")
            return

        self.send_response(200)
        self.end_headers()
        self.wfile.write(b"ok\n")

    def log_message(self, format, *args):
        pass

server = ThreadingHTTPServer(("0.0.0.0", 8080), Handler)

def shutdown_after_drain():
    # 生产环境应等待真实活动工作归零,或在截止时间到达后结束等待。
    time.sleep(10)
    server.shutdown()

def handle_sigterm(signum, frame):
    state["draining"] = True
    threading.Thread(target=shutdown_after_drain, daemon=True).start()

signal.signal(signal.SIGTERM, handle_sigterm)
print("listening on :8080", flush=True)
server.serve_forever()
print("shutdown complete", flush=True)
预期输出:
listening on :8080
shutdown complete
第二行只会在进程收到终止信号并完成 drain 等待后出现。进入 draining 后,请求 /ready 将得到 503;这里的端口和等待时间是示例值,生产环境应按真实连接和任务耗时设置。
WebSocket 与流式请求要主动定义截止点
对长连接而言,“一直等到客户端自己断开”通常不可执行,因为连接寿命可能远大于 Pod 的终止宽限期。应用需要定义 drain deadline:进入退出阶段后拒绝建立新会话,通知现有客户端准备重连,在截止点前尽量自然结束,超时后再关闭剩余连接。
WebSocket 可以先发送应用级“服务器维护,请重连”消息,再发送正常关闭帧;gRPC 流式调用则应使用客户端能够识别并重试的结束语义。客户端还要具备退避重连和幂等能力,否则即使服务端按顺序退出,也可能出现明显中断。
后台任务要区分停止领取与完成确认
Worker 收到终止通知后,应先停止拉取新任务,再处理已经领取的任务。若消息系统支持显式 ACK,通常应在业务结果真正持久化后再确认;进程在 ACK 前退出时,消息才能按队列语义重新投递。
对于可能执行很久的任务,不应依赖不断放大 Pod 的终止宽限期。更稳妥的做法是把任务拆成可恢复阶段、记录 checkpoint,或允许任务在新 Worker 上重放,并用幂等键消除重复副作用。终止预算可以按“停止领取新任务 + 当前任务允许的最长收尾时间 + 安全余量”设计。
配置足够但有限的终止窗口
下面的 Deployment 片段提供 60 秒终止宽限期,并用 preStop 先等待 5 秒。需要注意,Kubernetes 会先执行 preStop,随后才向容器发送 SIGTERM,因此这个 5 秒等待不是应用自身的 draining;它只是给 Pod 终止状态、端点更新和外部流量收敛留出传播时间。应用真正的退出逻辑仍由收到 SIGTERM 后的处理代码负责,并必须在剩余宽限期内结束。
apiVersion: apps/v1
kind: Deployment
metadata:
  name: stream-worker
spec:
  replicas: 3
  selector:
    matchLabels:
      app: stream-worker
  template:
    metadata:
      labels:
        app: stream-worker
    spec:
      terminationGracePeriodSeconds: 60
      containers:
        - name: app
          image: example/stream-worker:1.0
          ports:
            - containerPort: 8080
          readinessProbe:
            httpGet:
              path: /ready
              port: 8080
            periodSeconds: 2
          lifecycle:
            preStop:
              exec:
                command: ["/bin/sh", "-c", "sleep 5"]
这是片段示例,依赖镜像中的应用实现 /ready 并正确处理终止信号。配置应用后,可检查 Deployment 模板中的终止窗口:
kubectl get deployment stream-worker -o jsonpath='{.spec.template.spec.terminationGracePeriodSeconds}'预期输出:
60验收不能只看 rollout 成功
滚动发布显示成功,只能说明控制器完成了副本替换,不能证明长连接和后台任务没有损失。验收时应同时观察异常断连数、重连成功率、流式请求失败码、任务重新投递数、重复执行数和任务最终完成率。
对长连接服务,可以在发布前建立持续连接并记录连接 ID,确认发布期间连接是自然结束,或收到可识别的重连信号;对 Worker,则投递带唯一业务 ID 的任务,确认最终每个任务都完成且副作用只发生一次。只有“旧 Pod 不再接新工作、存量工作有明确收尾路径、超时后仍能安全恢复”同时成立,Pod 退出才真正可控。