
容器与云原生 / 系统课时
设计 readinessProbe 就绪门槛
设计 readinessProbe 就绪门槛
滚动发布时,容器进程已经启动并不等于应用已经能稳定接单。readinessProbe 要把“进程运行”与“允许进入 Service 流量池”分开,让新 Pod 只有在初始化和关键业务能力真正就绪后才接收请求。
学习目标
- 理解 readinessProbe 如何影响 Pod 就绪状态与 Service 流量资格
- 为 HTTP 应用设计不过松、不过严的业务就绪检查
- 在滚动发布中验证未就绪 Pod 不承接正常 Service 流量
就绪检查控制的是流量资格
Service 的 selector 选中 Pod,只说明它属于候选后端。readinessProbe 成功后,Pod 才满足就绪条件;探针失败时,容器通常不会被重启,而是被标记为未就绪。EndpointSlice 仍可能保留该 Pod 的地址,但会通过 conditions.ready: false 标记其状态,常规 Service 数据面不会把正常业务流量转给它。
这与 livenessProbe 的职责不同:readinessProbe 回答“现在能不能接请求”,livenessProbe 回答“进程是否已经坏到需要重启”。数据库连接池尚未建立、配置尚未加载或缓存尚未预热时,更适合暂时挡住流量,而不是触发重启。
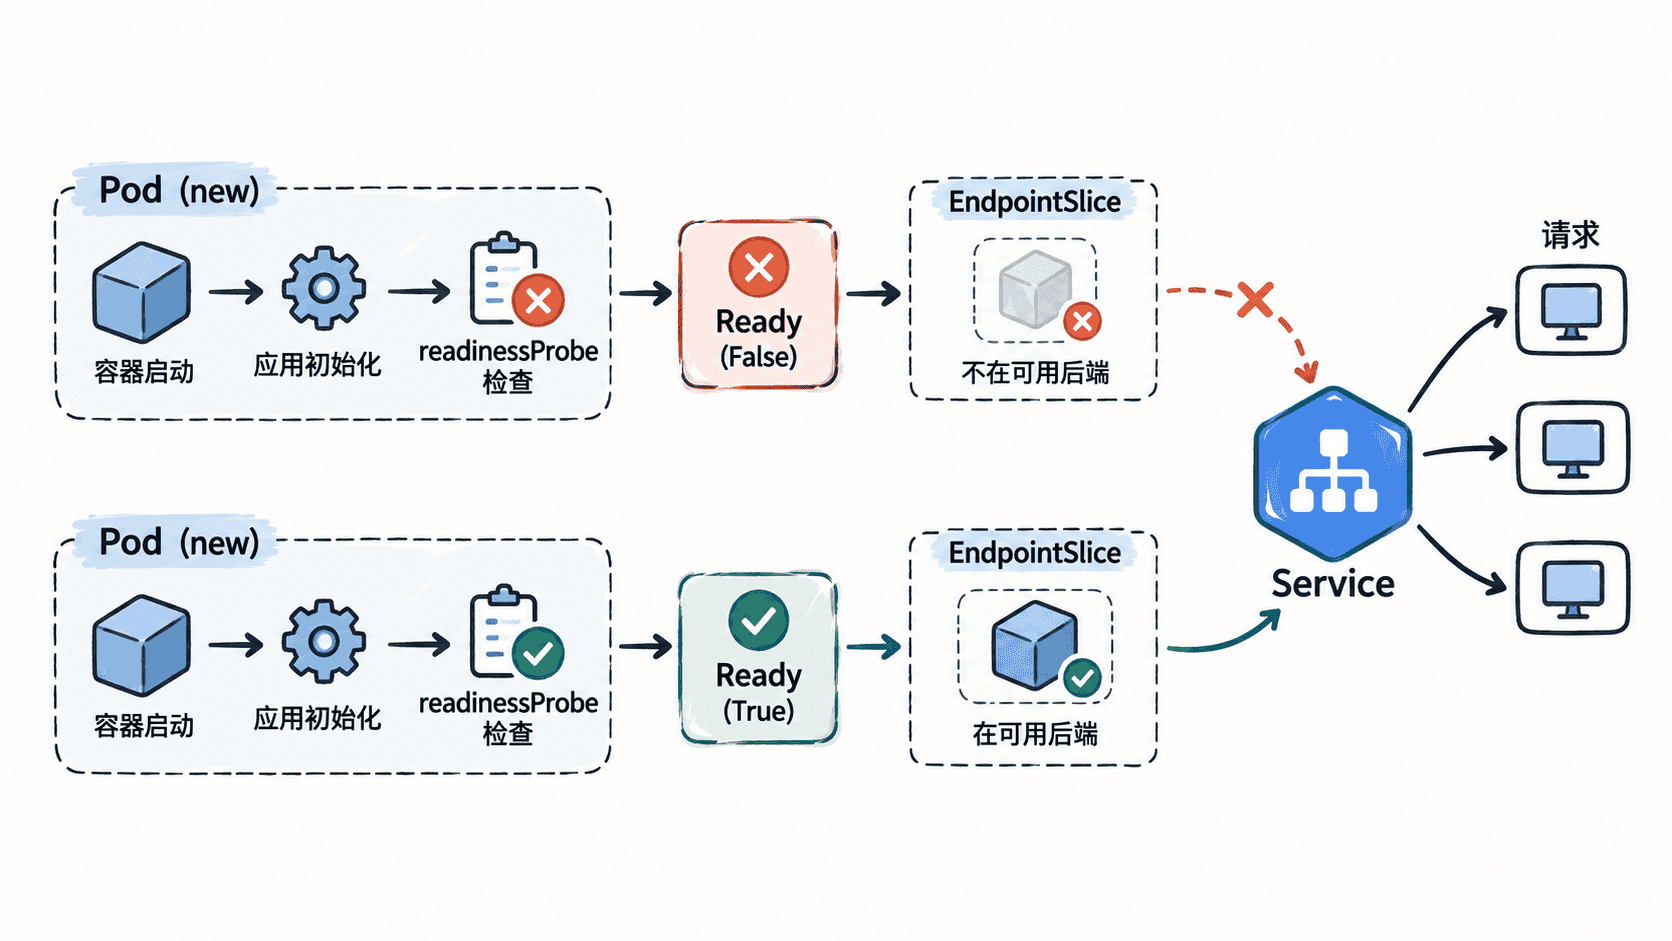
让探针检查真正的业务就绪条件
/readyz 应只在应用自身初始化完成,并且提供核心请求所需的依赖可用时返回成功。下面的主示例同时定义 Service 与 Deployment,避免验证时出现 Service 不存在或 selector 不匹配的问题。
apiVersion: v1
kind: Service
metadata:
  name: api
spec:
  selector:
    app: api
  ports:
    - port: 80
      targetPort: 8080
---
apiVersion: apps/v1
kind: Deployment
metadata:
  name: api
spec:
  replicas: 3
  selector:
    matchLabels:
      app: api
  template:
    metadata:
      labels:
        app: api
    spec:
      containers:
        - name: api
          image: example/api:2.0
          ports:
            - containerPort: 8080
          readinessProbe:
            httpGet:
              path: /readyz
              port: 8080
            initialDelaySeconds: 2
            periodSeconds: 5
            timeoutSeconds: 2
            failureThreshold: 2
            successThreshold: 1
这组参数表示容器启动 2 秒后开始检查,每 5 秒探测一次;单次最多等待 2 秒,连续 2 次失败后判为未就绪,后续一次成功即可恢复就绪。配置文件本身没有固定控制台输出,生效后应通过 Pod 条件和 EndpointSlice 验证。
验证未就绪 Pod 是否被挡在流量池外
先观察 Pod。Running 只表示容器在运行,READY 才反映是否通过就绪门槛。
kubectl get pods -l app=api预期输出
NAME        READY   STATUS    RESTARTS   AGE
api-<ID>    1/1     Running   0          <TIME>
api-<ID>    1/1     Running   0          <TIME>
api-<ID>    0/1     Running   0          <TIME>
Pod 名称和时间会随环境变化。再检查 EndpointSlice 中每个地址的就绪条件:
kubectl get endpointslice -l kubernetes.io/service-name=api -o jsonpath='{range .items[*].endpoints[*]}{.addresses[0]}{" => ready="}{.conditions.ready}{"\n"}{end}'预期结果
<IP> => ready=true
<IP> => ready=true
<IP> => ready=false
地址顺序和数量可能不同。关键是未就绪 Pod 对应的 endpoint 显示 ready=false;这比只看 EndpointSlice 是否包含该 IP 更准确。若 Service 显式设置 publishNotReadyAddresses: true,其语义不同,不能用上述“未就绪即不接流量”的结论直接判断。
发布时还可以观察 rollout:
kubectl rollout status deployment/api预期输出
deployment "api" successfully rolled out只有新副本满足可用条件后 rollout 才会完成;如果 readinessProbe 长时间失败,命令会持续等待而不是把“Pod 已创建”误判为“新版本已可用”。
避免把探针设计成新的故障源
就绪接口必须轻量,只检查“当前是否具备服务核心流量的能力”。不要让 /readyz 每次执行复杂 SQL、访问多个外部 API 或扫描大量数据,否则探针本身可能放大后端压力,并在短暂抖动时同时摘除大量 Pod。
也不要把所有非关键依赖都放进就绪门槛。例如推荐服务故障时订单接口仍可降级完成交易,那么推荐服务不可用不应让整个 Pod 退出流量池。判断标准不是“所有依赖是否完美”,而是“当前 Pod 是否还能履行它承诺的核心请求”。
一个有效的 readinessProbe 应形成清晰门槛:未准备好时不接单,准备完成后及时加入流量池,运行期间短暂失去服务能力时退出,恢复后再重新接入。