
容器与云原生 / 系统课时
演练异常发布与快速回退
演练异常发布与快速回退
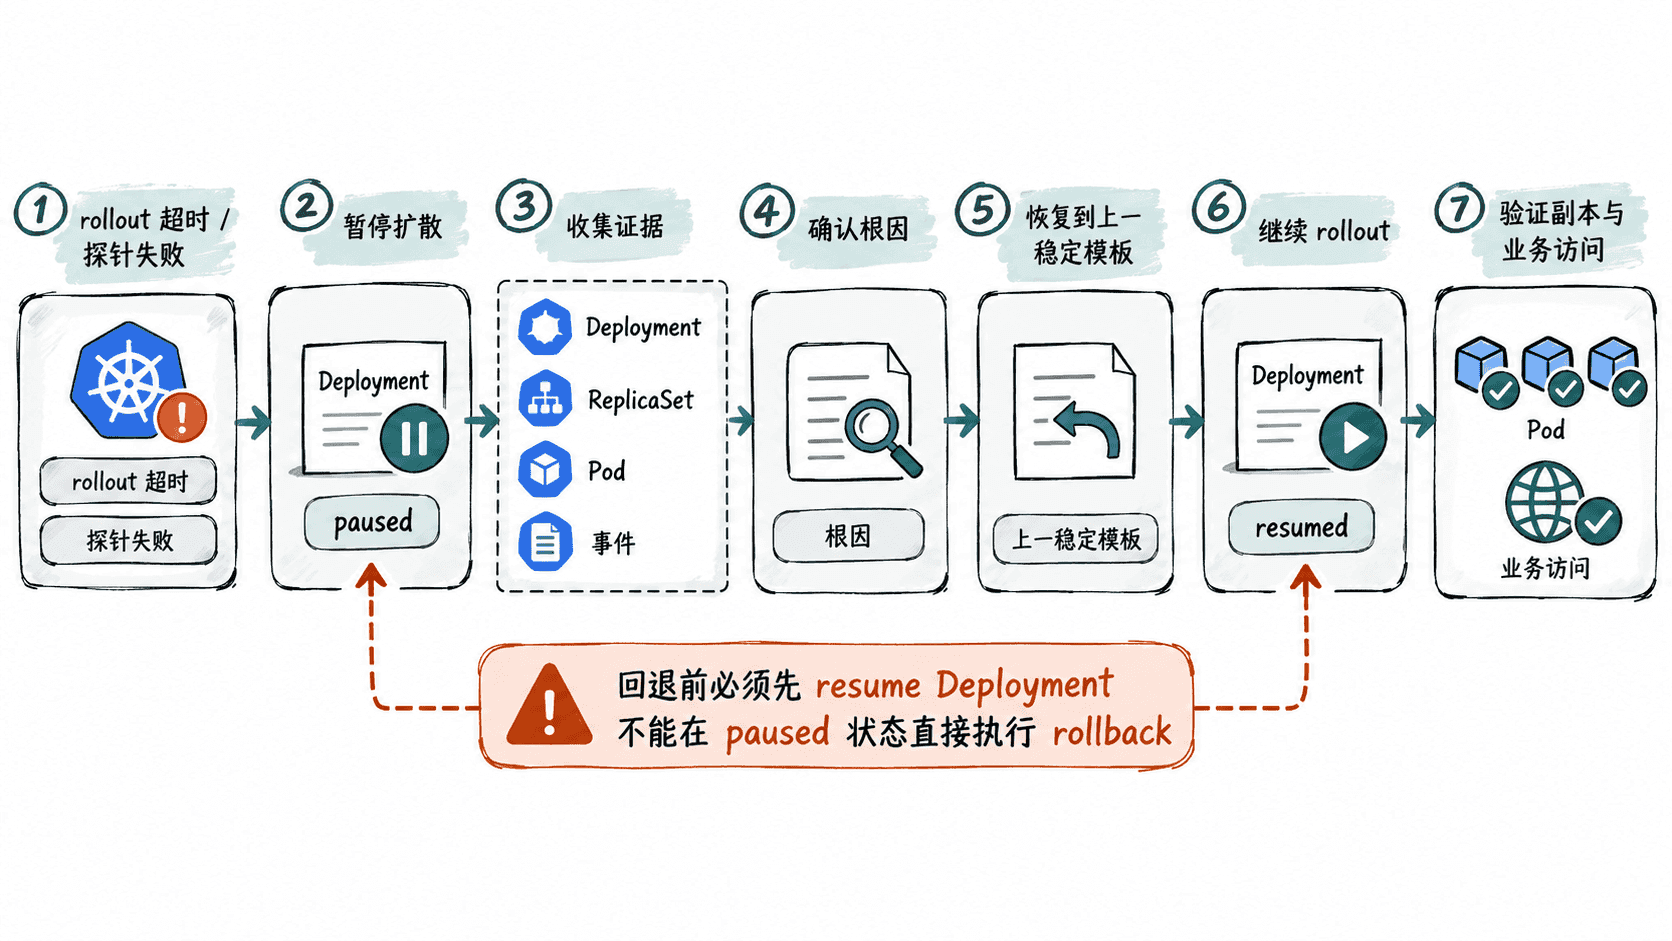
异常发布演练的目标不是证明 kubectl rollout undo 能执行,而是把发现异常、暂停扩散、保存证据、选择回退点、恢复服务和验证结果串成一条可重复的处置链路。本课用 readinessProbe 失败模拟一次 Deployment 发布事故,并完成从故障注入到恢复验收的闭环。
学习目标
- 能用 Deployment、ReplicaSet、Pod 和事件判断滚动发布是否异常。
- 能在继续扩散前暂停发布并保存足够的现场证据。
- 能按正确顺序恢复并回退 Deployment,再从副本、探针和业务访问三个层面验收。
构造一次可控的异常发布
假设命名空间 release-lab 中已有正常运行的 web Deployment,容器名为 web,Pod 模板带 app=web 标签,并有同名 Service 提供访问。下面的片段示例一次性修改镜像和 readinessProbe,使本次 PodTemplate 变更只形成一个故障 revision;探针访问不存在的路径,新 Pod 能启动但不会 Ready。
kubectl -n release-lab patch deployment web --type='strategic' -p '{"spec":{"template":{"spec":{"containers":[{"name":"web","image":"nginx:1.27.5","readinessProbe":{"httpGet":{"path":"/not-ready","port":80},"initialDelaySeconds":2,"periodSeconds":3}}]}}}}'
kubectl -n release-lab rollout status deployment/web --timeout=30s
预期输出
deployment.apps/web patched
error: timed out waiting for the condition
等待过程中的提示文字可能随 kubectl 版本和副本进度不同,但关键结果是 rollout 未能在超时时间内完成。由于失败的是就绪探针,新 Pod 不会进入 Service 的可用后端;旧 Pod 是否还能维持服务,则取决于副本数和 RollingUpdate 的 maxUnavailable、maxSurge 设置。
先暂停扩散,再保存现场
看到 rollout 超时后,不要连续重试发布,也不要先删除失败 Pod。先暂停 Deployment,让当前现场保持稳定,再检查 Deployment、ReplicaSet 和 Pod。暂停用于阻止控制器继续推进这次 rollout,同时给取证留出窗口。
kubectl -n release-lab rollout pause deployment/web
kubectl -n release-lab get deployment web
kubectl -n release-lab get rs -l app=web
kubectl -n release-lab get pods -l app=web
kubectl -n release-lab describe deployment web
预期输出
deployment.apps/web paused
NAME   READY     UP-TO-DATE   AVAILABLE   AGE
web    <VALUE>   <VALUE>      <VALUE>     <TIME>

NAME       DESIRED   CURRENT   READY   AGE
web-<ID>   <VALUE>   <VALUE>   <VALUE> <TIME>
web-<ID> <VALUE> <VALUE> <VALUE> <TIME><VALUE>、<ID> 和 <TIME> 会随副本数和发布进度变化。应重点确认新 ReplicaSet 已产生但 Ready 数量不足,同时旧 ReplicaSet 是否仍保留可用副本。接着检查一个失败的新 Pod,确认根因确实是探针,而不是镜像拉取、调度或节点异常。
kubectl -n release-lab describe pod <POD-NAME>预期输出
Readiness probe failed: HTTP probe failed with statuscode: 404事件文本可能略有差异,但应能看到 readinessProbe 对 /not-ready 的失败记录。如果证据显示 ImagePullBackOff、调度失败或应用启动异常,就应按真实根因处理,不能把所有 rollout 超时都归为探针问题。
回退到上一份稳定模板
Deployment 的 revision 对应 PodTemplate 的历史版本。关键约束是:paused Deployment 不能 rollback。因此暂停阶段只用于控制扩散和保存现场;决定回退后,先查看历史并确定稳定 revision,再 resume,随后立即执行 undo。不要把 undo 放在 resume 之前。
kubectl -n release-lab rollout history deployment/web
kubectl -n release-lab rollout resume deployment/web
kubectl -n release-lab rollout undo deployment/web --to-revision=<REVISION>
kubectl -n release-lab rollout status deployment/web --timeout=120s
预期输出
deployment.apps/web
REVISION  CHANGE-CAUSE
<VALUE>   <VALUE>
<VALUE>   <VALUE>

deployment.apps/web resumed
deployment.apps/web rolled back
deployment "web" successfully rolled out
<REVISION> 必须替换为已经核对过的稳定 revision,历史表中的具体值和 CHANGE-CAUSE 取决于环境。使用显式 revision 比凭“上一版应该没问题”更稳妥;如果目标历史 ReplicaSet 已因 revisionHistoryLimit 被清理,就不能再依赖 Deployment revision 完成恢复。
从三个层面验证恢复
rollout status 成功只说明 Deployment 控制器完成了目标状态收敛。恢复验收还要确认期望副本全部 Ready、Service 后端重新包含健康 Pod,并让真实请求穿过 Service 路径,避免“控制器成功但业务仍失败”的假恢复。
kubectl -n release-lab get deployment web
kubectl -n release-lab get pods -l app=web
kubectl -n release-lab get endpointslices -l kubernetes.io/service-name=web
kubectl -n release-lab run verify-client --rm -i --restart=Never --image=curlimages/curl --command -- curl -fsS http://web/
预期输出
NAME   READY     UP-TO-DATE   AVAILABLE   AGE
web    <VALUE>   <VALUE>      <VALUE>     <TIME>

<应用实际返回内容><VALUE>、<TIME> 和业务响应取决于实际环境。验收时应确认期望副本全部 Ready、EndpointSlice 中重新出现健康地址、请求恢复成功;生产演练还应观察错误率、延迟和告警是否回落到发布前基线。
一次合格的异常发布演练,最终留下的不只是“回退成功”,还应保存异常时间点、失败 revision、关键事件、回退目标、恢复时间和验证证据。只有这些信息能够被复盘和重复执行,快速回退才真正成为发布治理能力。