
容器与云原生 / 系统课时
处理依赖型健康检查风险
处理依赖型健康检查风险
健康检查访问数据库、缓存或外部接口看似能够证明应用“真的可用”,但在共享依赖故障时,它可能让全部 Pod 同时退出就绪状态,甚至触发重启。本课建立依赖检查的判断方法,并设计不会把单点依赖故障扩散成整批摘流的健康检查策略。
学习目标
- 判断数据库、缓存和外部接口是否应该影响健康状态
- 区分依赖故障对 liveness 与 readiness 的不同处理方式
- 通过降级和最小就绪条件避免大规模级联摘流
依赖检查为什么容易产生级联故障
设想 20 个 Pod 的 readinessProbe 都要求数据库查询成功。数据库出现几秒连接抖动后,20 个 Pod 可能在相近时间连续探测失败,EndpointSlice 随即移除这些未就绪 Pod。此时即使应用本来还能提供缓存读取、静态接口或降级响应,Service 也可能暂时没有可用后端。
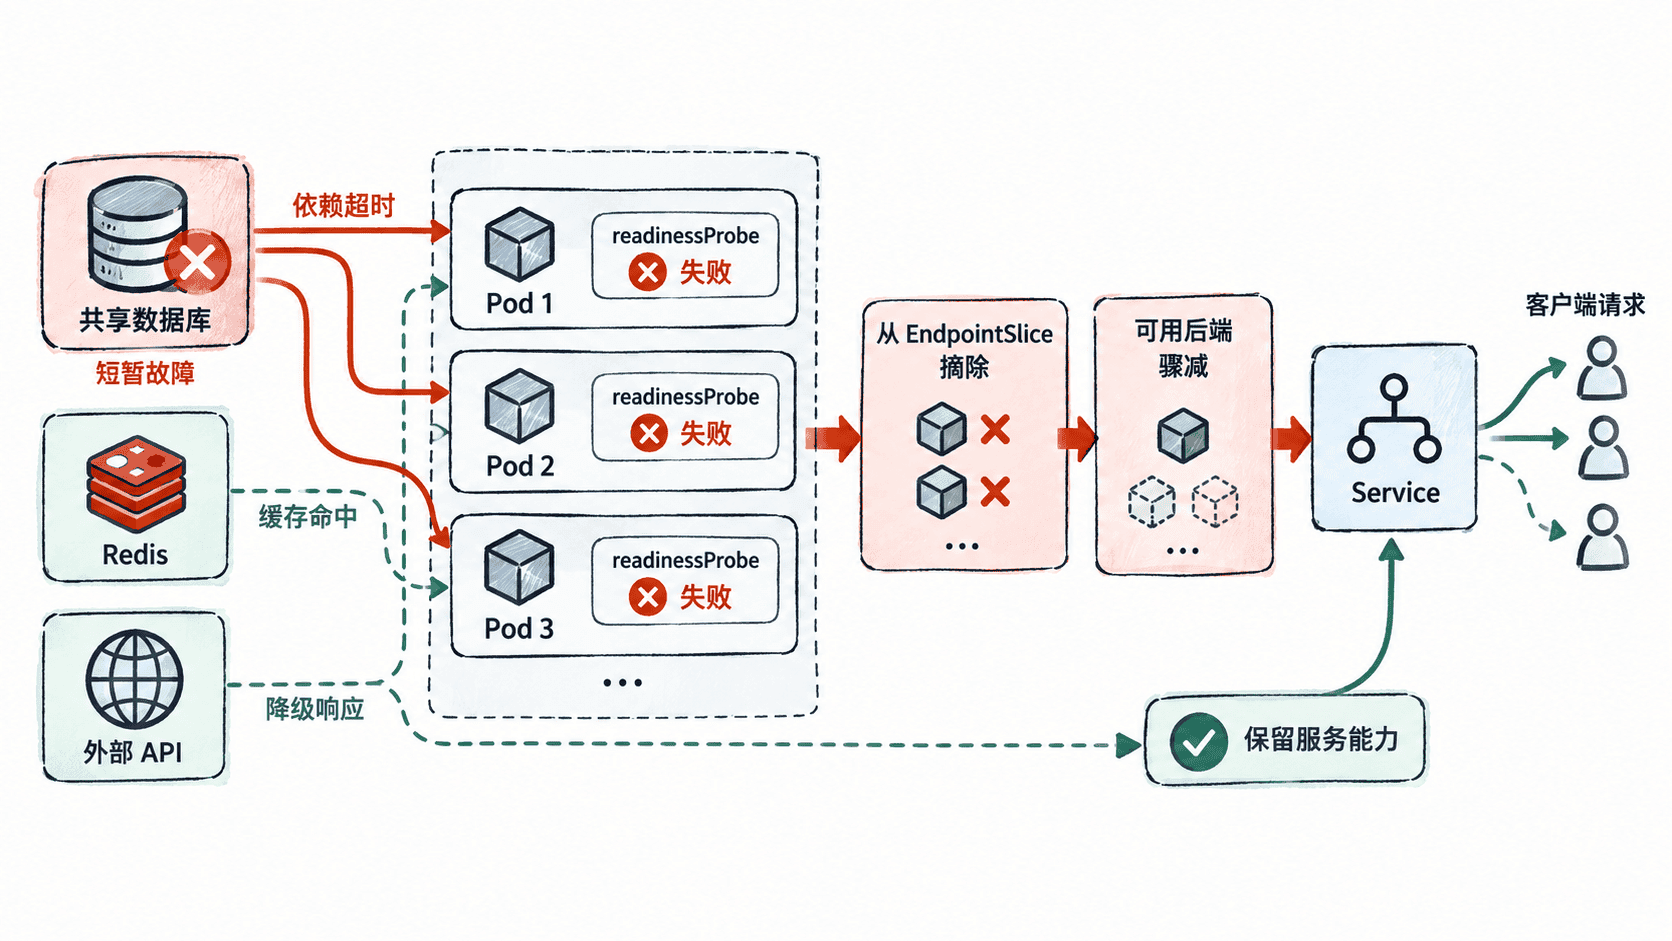
问题不在于“健康检查绝对不能访问依赖”,而在于必须先确定:这个依赖失败时,当前 Pod 是否真的完全没有服务价值,以及把 Pod 摘流后是否能改善局面。
先判断依赖属于哪一种
数据库通常是强依赖,但并不意味着数据库连接失败就应该触发 liveness。重启 Pod 无法修复数据库,因此数据库状态通常不应决定容器是否存活。
readiness 的判断更细。如果应用所有请求都必须访问数据库,数据库长期不可用时让 Pod 暂停接流量可能合理;但如果所有副本共享同一个数据库,让全部副本同时摘流并不会产生健康实例,只会把故障表现从“应用返回受控错误”变成“Service 没有后端”。
缓存通常更适合降级处理。例如 Redis 不可用时回源数据库、关闭部分非核心能力,而不是直接让整个 Pod 未就绪。外部 HTTP API 也应优先考虑超时、熔断和降级,因为其故障通常不能通过本地 Pod 重启解决。
| 依赖故障 | 适合作为 liveness 条件 | 是否适合作为 readiness 条件 |
|---|---|---|
| 数据库不可达 | 通常不适合 | 仅在应用确实完全无法服务时谨慎使用 |
| 缓存不可达 | 通常不适合 | 有回源或降级能力时通常不适合 |
| 外部 API 不可达 | 通常不适合 | 能熔断或降级时通常不适合 |
| 应用自身初始化未完成 | 不一定 | 通常适合 |
把存活检查和就绪检查拆开
下面的配置分别使用 /health/live 和 /health/ready。其中 live 只检查应用自身;ready 只判断本实例当前是否具备最小服务能力,不要求所有外部依赖都处于完美状态。
apiVersion: apps/v1
kind: Deployment
metadata:
  name: checkout
spec:
  replicas: 4
  selector:
    matchLabels:
      app: checkout
  template:
    metadata:
      labels:
        app: checkout
    spec:
      containers:
        - name: checkout
          image: example/checkout:2.0.0
          ports:
            - containerPort: 8080
          readinessProbe:
            httpGet:
              path: /health/ready
              port: 8080
            periodSeconds: 5
            timeoutSeconds: 2
            failureThreshold: 3
          livenessProbe:
            httpGet:
              path: /health/live
              port: 8080
            periodSeconds: 10
            timeoutSeconds: 2
            failureThreshold: 3
配置本身无法决定 /health/ready 的语义,关键在应用实现:例如 Redis 故障但可以回源数据库时,ready 应继续成功;某个推荐服务失效但核心结算仍可工作时,也不应因为非关键依赖失败而摘掉整个 Pod。
应用配置后可以检查就绪状态:
kubectl apply -f deployment.yaml
kubectl get pods -l app=checkout
预期结果
deployment.apps/checkout configured
NAME                         READY   STATUS    RESTARTS   AGE
checkout-<ID>                1/1     Running   0          <TIME>
checkout-<ID>                1/1     Running   0          <TIME>
checkout-<ID>                1/1     Running   0          <TIME>
checkout-<ID>                1/1     Running   0          <TIME>
实际 Pod 名称与时间会不同。非关键依赖故障时,如果应用仍具备最小服务能力,Pod 应保持 READY,同时由业务指标和依赖告警反映降级状态。
不要把健康检查当成依赖监控系统
探针是流量控制和容器恢复机制,不应该承担完整依赖监控职责。数据库延迟、缓存命中率、外部 API 错误率等状态,更适合通过指标和告警系统持续观测。
依赖探测本身还必须设置严格超时。健康接口若串行查询多个下游,会让探针耗时受最慢依赖控制,并可能在故障期间额外制造连接和请求压力。健康检查应保持轻量,避免为了证明“所有东西都健康”而主动攻击已经过载的依赖。
验证依赖故障下仍保留合理容量
可以在依赖异常期间持续观察 Pod 就绪情况与 EndpointSlice:
kubectl get pods -l app=checkout
kubectl get endpointslice -l kubernetes.io/service-name=checkout
预期结果应与设计目标一致:非关键依赖故障时,仍具备降级能力的 Pod 保持 Ready,并继续出现在对应 EndpointSlice 中;如果核心能力确实完全不可用,readiness 才应在达到失败阈值后将实例摘流。EndpointSlice 的具体名称和地址属于动态值。
Pods:              Ready replicas remain available according to the degradation policy
EndpointSlices:    Ready endpoints remain for Pods that can still serve requests
设计依赖型健康检查时,不要问“这个依赖现在是不是健康”,而要问“它失败后,这个 Pod 是否仍然值得接收请求,以及重启或摘流是否真的能改善系统状态”。把这两个问题回答清楚,才能避免一次数据库、缓存或外部接口故障演变成 Kubernetes 层面的级联失效。